
Architettura dell’informazione: cos’è e come si progetta

L’architettura dell’informazione è la disciplina che organizza, struttura ed etichetta i contenuti di uno spazio informativo — un sito, un’app, un servizio fisico — per renderli facili da trovare, capire e usare, secondo logiche di classificazione, navigazione e ricerca pensate attorno ai bisogni reali di chi li consulta.
In breve
- Cosa risolve: evita che gli utenti si perdano in un sito o in un’app, strutturando contenuti, etichette e percorsi di navigazione in modo coerente con il loro modo di cercare.
- Quando si applica: in ogni progetto con più di poche decine di pagine o contenuti, dai siti della pubblica amministrazione ai prodotti digitali complessi.
- Condizioni e limiti: funziona solo se basata su un’analisi reale dei contenuti esistenti e dei comportamenti degli utenti, non su un organigramma aziendale.
- Come verificare: si valida con tecniche come il card sorting e il tree testing, confrontando il modello mentale degli utenti con la struttura progettata.
- Cosa fare: partire da un inventario dei contenuti, definire tassonomie ed etichette, poi costruire alberatura e sistemi di ricerca prima di disegnare l’interfaccia.
Che cos’è l’architettura dell’informazione
L’architettura dell’informazione riguarda il modo in cui contenuti, documenti e servizi vengono organizzati all’interno di uno spazio complesso per favorire orientamento, trovabilità e comprensione. Non è un’attività isolata: attraversa biblioteconomia, scienze cognitive, linguistica e interazione uomo-computer, ed è per questo che non esiste un’unica definizione universalmente accettata.
Il termine compare per la prima volta nel 1970, quando un gruppo di ricerca dello Xerox Palo Alto Research Center lo utilizza per descrivere i primi studi sull’interazione uomo-computer. Nel 1976 Richard Saul Wurman lo porta a una conferenza dell’American Institute of Architecture, e nel 1998 Louis Rosenfeld e Peter Morville pubblicano “Information Architecture for the World Wide Web”, il testo che codifica i quattro sistemi ancora oggi considerati il nucleo della disciplina.
Esiste una distinzione utile per capire l’ampiezza del campo: la cosiddetta “little IA” riguarda la classificazione e il recupero dei contenuti di un singolo sito, mentre la “big IA” comprende l’intera esperienza utente, l’usabilità e la progettazione di ecosistemi informativi che attraversano più canali e dispositivi, dal web agli ambienti fisici.
Che cos’è l’architettura del web?
L’architettura del web descrive l’infrastruttura tecnica che permette a pagine e servizi di comunicare — protocolli, server, standard di markup — mentre l’architettura dell’informazione si occupa di come i contenuti vengono organizzati ed etichettati perché le persone li trovino. Le due discipline si intrecciano nella fase di progettazione di un sito, ma rispondono a domande diverse: una riguarda il funzionamento tecnico, l’altra l’esperienza di chi naviga.
Quali sono le novità nell’evoluzione dell’architettura dell’informazione?
L’evoluzione della disciplina si può leggere in quattro fasi: una prima fase, fino agli anni ’80, legata all’information design visivo; una seconda, fino agli anni ’90, centrata sui sistemi informativi aziendali; una terza, legata all’esplosione del web, dedicata a etichettatura e organizzazione dei siti; una quarta, dal 2010 a oggi, in cui la diffusione di dispositivi connessi e ambienti ibridi fisico-digitali spinge l’architettura dell’informazione a diventare pervasiva, progettando sistemi che attraversano più canali contemporaneamente.
Trovabilità, usabilità e orientamento: gli obiettivi principali
I tre obiettivi che guidano ogni progetto di architettura dell’informazione sono la trovabilità dei contenuti, la semplicità d’uso del sistema e la capacità dell’utente di orientarsi durante la navigazione.
- Findability (trovabilità)
- La possibilità per l’utente di individuare un contenuto specifico in tempi brevi, grazie a etichette chiare, gerarchie coerenti e collegamenti interni ben distribuiti.
- Usability (usabilità)
- La facilità con cui il sistema viene utilizzato per completare un compito, senza richiedere più di pochi passaggi per le azioni più comuni.
- Wayfinding (orientamento)
- La capacità dell’utente di capire in ogni momento dove si trova, da dove proviene e quali percorsi ha a disposizione per proseguire.
Questi tre obiettivi non sono indipendenti: un’etichetta ambigua compromette la trovabilità ma anche l’orientamento, perché l’utente perde il riferimento semantico che gli permette di capire in quale sezione si trova. Per questo la progettazione dei sistemi di etichettatura e di navigazione va sempre condotta in parallelo, non in sequenza.
Una regola spesso citata è quella dei “tre click”, secondo cui un contenuto dovrebbe essere raggiungibile in non più di tre passaggi di navigazione: nella pratica si tratta più di un principio orientativo che di una soglia rigida, perché un percorso di quattro o cinque passaggi resta efficace se ogni passaggio è prevedibile e coerente con le aspettative dell’utente.
Vantaggi di una buona architettura dell’informazione
Una struttura informativa ben progettata riduce il carico cognitivo richiesto per orientarsi, perché l’utente non deve interpretare il sistema: lo riconosce immediatamente come coerente con il proprio modo di pensare i contenuti.
Il primo vantaggio deriva dall’approccio centrato sull’utente: ogni decisione di classificazione e di etichettatura parte dai modelli mentali reali delle persone che useranno il sistema, non dall’organigramma interno di chi lo produce. Un menu organizzato per funzioni interne dell’ente o dell’azienda, anziché per compiti che l’utente deve svolgere, è il sintomo più comune di un’architettura progettata al contrario.
Il secondo vantaggio riguarda la scalabilità: una struttura solida accoglie nuovi contenuti o nuove funzionalità senza che l’intera alberatura debba essere ridisegnata. Una tassonomia troppo rigida, al contrario, costringe a inserire forzatamente nuovi contenuti in categorie che non li rappresentano, degradando nel tempo la qualità della navigazione.
Il terzo vantaggio è la credibilità percepita: a parità di contenuto, un sistema organizzato in modo coerente comunica maggiore affidabilità rispetto a uno caotico, perché la qualità della struttura viene associata, anche inconsciamente, alla qualità dell’informazione stessa.
I quattro sistemi che compongono l’architettura dell’informazione
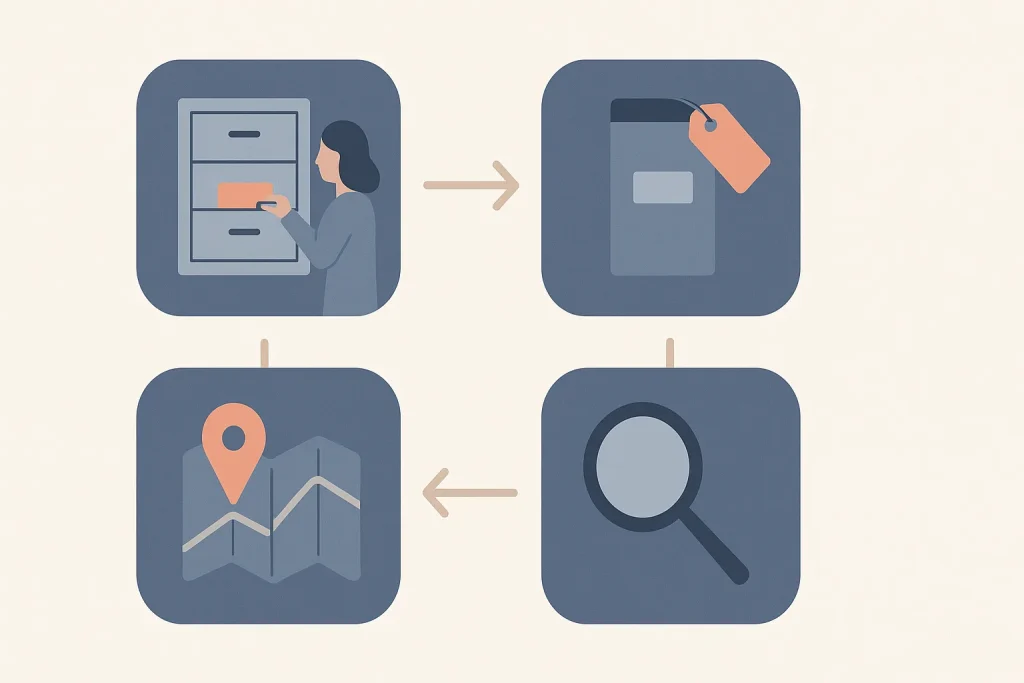
Secondo la definizione classica codificata da Rosenfeld e Morville, ogni architettura dell’informazione si compone di quattro sistemi distinti ma interdipendenti: organizzazione, etichettatura, navigazione e ricerca.
Sistemi di organizzazione e tassonomie
I sistemi di organizzazione stabiliscono come i contenuti vengono raggruppati: per categoria tematica, per ordine cronologico, per pubblico di riferimento o in ordine alfabetico. La tassonomia è la classificazione gerarchica che ne risulta, con livelli di dettaglio crescente: nei siti della pubblica amministrazione italiana, ad esempio, un evento culturale viene classificato fino al terzo livello, da “Evento culturale” a “Conferenza e summit” fino a “Convegno”.
Sistemi di etichettatura e linguaggio
I sistemi di etichettatura definiscono il vocabolario usato per nominare menu, categorie e pulsanti. Questo vocabolario costituisce l’ontologia del sistema: le parole devono provenire dal linguaggio reale degli utenti, non dal gergo interno di chi gestisce il servizio. Una scheda di servizio chiamata internamente “pratica” ma percepita dall’utente come “richiesta” genera confusione anche se il contenuto sottostante è identico.
Sistemi di navigazione
I sistemi di navigazione rendono visibile la tassonomia attraverso menu principali, menu secondari, breadcrumb e collegamenti contestuali. Tassonomia e navigazione non coincidono necessariamente: una classificazione complessa può essere esposta con un menu semplice, a patto che i livelli nascosti restino raggiungibili tramite ricerca o link correlati. Un menu ad accordion è un esempio di pattern di navigazione pensato per comprimere più livelli senza affollare l’interfaccia.
Sistemi di ricerca
I sistemi di ricerca comprendono il motore interno, i filtri e i suggerimenti automatici. Nei prodotti con un numero elevato di contenuti, la ricerca diventa spesso il canale principale di accesso ai contenuti, più della navigazione per menu: in questi casi la qualità dell’indicizzazione interna e la precisione dei filtri pesano quanto la struttura dell’alberatura.
Metodi e strumenti per progettare l’architettura dell’informazione
La progettazione segue un percorso che parte dall’inventario dei contenuti esistenti e arriva alla validazione della struttura con gli utenti reali, prima che inizi la fase di wireframing.
Come si conduce un content audit
- Esportare la sitemap esistente o effettuare una scansione dei contenuti pubblicati.
- Costruire una tabella con una riga per ogni contenuto, indicando URL, titolo, tipologia, data di ultima modifica, stato e link in ingresso e uscita.
- Classificare ogni contenuto come da mantenere, da aggiornare, da accorpare o da eliminare.
- Individuare i contenuti duplicati, quelli orfani privi di link in ingresso e quelli più consultati, per orientare le priorità della nuova struttura.
Il risultato di questa fase è spesso una gap analysis, che evidenzia la distanza tra i contenuti attualmente disponibili e quelli che la nuova architettura dovrà produrre, modificare o eliminare.
| Metodo | Domanda a cui risponde | Quando usarlo |
|---|---|---|
| Content audit | Cosa esiste già e in che stato si trova? | Prima di ogni riprogettazione, per avere una mappa reale dei contenuti. |
| Card sorting | Come raggrupperebbero i contenuti gli utenti? | Quando la tassonomia non esiste ancora o va ripensata. |
| Tree testing | Gli utenti trovano un contenuto nella struttura proposta? | Dopo aver abbozzato una tassonomia, per validarla prima del wireframe. |
Se la tassonomia non esiste ancora o va validata
Se non hai ancora una classificazione dei contenuti, conduci un card sorting aperto, lasciando che gli utenti creino liberamente i gruppi e li nominino. Se invece una tassonomia abbozzata esiste già e va verificata, usa un card sorting chiuso con categorie predefinite, oppure una versione ibrida che permette di aggiungerne di nuove quando necessario.
Il tree testing interviene nella fase successiva: si fornisce agli utenti una struttura testuale, senza elementi grafici, e si chiede loro di individuare dove troverebbero un determinato contenuto. Per risultati quantitativamente solidi su un campione ampio sono generalmente necessari più partecipanti rispetto a un’esplorazione qualitativa, che può limitarsi a un gruppo ristretto per individuare i pattern principali di errore.
Solo dopo aver validato tassonomia e navigazione si procede ai wireframe a bassa fedeltà, che definiscono la gerarchia visiva dei contenuti senza dettagli grafici, e successivamente ai prototipi interattivi destinati al test di usabilità.
Quali qualità rendono efficace un’architettura dell’informazione
Un’architettura dell’informazione efficace si valuta su un insieme di qualità che vanno oltre la semplice facilità di navigazione: utilità, usabilità, trovabilità, credibilità, accessibilità, desiderabilità, valore prodotto, chiarezza del linguaggio, coerenza delle etichette e controllabilità da parte dell’utente.
Alcune di queste qualità entrano spesso in tensione tra loro. Un sistema molto ricco di contenuti può risultare utile ma poco usabile se la quantità di opzioni supera la capacità dell’utente di scegliere rapidamente; un’interfaccia esteticamente desiderabile può sacrificare la chiarezza se privilegia l’originalità grafica rispetto a etichette riconoscibili. Il compromesso corretto dipende dal contesto: un sito istituzionale privilegia chiarezza e accessibilità, un prodotto di intrattenimento può concedere più spazio alla desiderabilità.
La coerenza merita un’attenzione specifica: la stessa voce di menu deve mantenere lo stesso nome in tutte le sezioni del sistema, perché un cambio di terminologia tra una pagina e l’altra viene interpretato dall’utente come un cambio di contenuto, anche quando non lo è.
Applicazioni pratiche: pubblica amministrazione e prodotti digitali
Nei siti della pubblica amministrazione italiana l’architettura dell’informazione è normata attraverso Designers Italia e il riferimento al CAD: ogni sito comunale definisce content type come scheda servizio, notizia, evento o documento pubblico, ciascuno con attributi obbligatori e un ordine di presentazione prestabilito, organizzati in sezioni di primo livello come Amministrazione, Novità, Servizi e Vivere il comune.
Nei prodotti digitali generici l’architettura dell’informazione si inserisce come seconda fase del processo di progettazione, dopo la ricerca utente e prima del wireframing: definisce come i contenuti individuati durante l’analisi vengono trasformati in una struttura navigabile, su cui si innestano poi gli user flow, cioè i percorsi passo passo che un utente compie per completare un’azione.
Che differenza c’è tra UX e UI?
Lo UX design riguarda l’organizzazione dell’esperienza — cosa vede l’utente per primo, quali decisioni deve prendere, come si riduce l’attrito nel percorso — mentre lo UI design riguarda l’esecuzione visiva di quella esperienza, dal colore dei pulsanti alla leggibilità del testo. L’architettura dell’informazione appartiene al primo ambito: definisce la struttura su cui l’interfaccia viene poi disegnata.
Cosa significa UX e quali competenze servono per occuparsene
UX è l’abbreviazione di user experience, in italiano esperienza utente: l’insieme delle percezioni e delle reazioni di una persona durante l’uso di un prodotto. Chi lavora sull’architettura dell’informazione e sulla UX in generale utilizza metodi di ricerca qualitativa e quantitativa, costruisce mappe di percorso e persona dell’utente, conduce test di usabilità e padroneggia tecniche come il card sorting; la formazione in questo campo unisce design, scienze cognitive e, nei contesti più tecnici, nozioni di struttura dei dati.
Quanto guadagna chi si occupa di architettura dell’informazione
Il compenso di chi progetta architetture dell’informazione varia in base al settore, all’esperienza e al tipo di contratto, e dipende da condizioni che cambiano nel tempo: per avere una stima realistica è necessario consultare le rilevazioni salariali aggiornate del settore UX/UI nel mercato di riferimento, non un valore unico valido per ogni ruolo o paese.
Errori frequenti nella progettazione dell’architettura dell’informazione
L’errore più comune consiste nell’aggiungere continuamente nuove voci di menu senza mai rimuovere quelle superflue: un’architettura dell’informazione migliora quando si eliminano i contenuti che nessun utente cerca davvero, non solo quando se ne aggiungono di nuovi.
Un secondo errore è trattare l’accessibilità come un intervento successivo: menu con molti livelli annidati o etichette poco chiare diventano ostacoli concreti per chi usa uno screen reader, e correggerli dopo il lancio costa molto più che progettarli correttamente fin dall’inizio.
Un terzo errore riguarda la terminologia interna: usare nei menu il nome con cui un ufficio o un reparto chiama un servizio, anziché il termine che l’utente userebbe per cercarlo, è la causa più comune di bassa trovabilità anche quando il contenuto esiste ed è corretto.
Un quarto errore è confondere tassonomia e navigazione: progettare un menu visibile semplice senza aver prima validato la classificazione sottostante porta a strutture che sembrano chiare in superficie ma nascondono contenuti irraggiungibili con la sola navigazione per menu.
Architettura dell’informazione e concetti spesso confusi
Cos’è l’architettura dell’informatica o del computer?
L’architettura del computer, talvolta chiamata architettura dell’informatica, descrive l’organizzazione fisica e logica dei componenti hardware di un elaboratore — processore, memoria, bus di comunicazione — ed è un campo dell’ingegneria elettronica. Non va confusa con l’architettura dell’informazione, che riguarda l’organizzazione dei contenuti in uno spazio digitale o fisico e appartiene al design dell’esperienza utente.
L’informatica è matematica?
L’informatica si fonda su basi logico-matematiche — algebra booleana, teoria degli algoritmi, strutture dati — ma comprende anche discipline applicative come l’ingegneria del software e l’interazione uomo-macchina, di cui l’architettura dell’informazione è un’espressione pratica orientata al design piuttosto che al calcolo.
Quali sono i tre pilastri della UX?
Nella letteratura UX si fa spesso riferimento a tre fondamenta progettuali: il design centrato sull’utente, l’usabilità e l’accessibilità. Nell’architettura dell’informazione, in particolare, queste fondamenta si traducono nelle tre domande operative a cui ogni struttura deve rispondere: dove si trova l’utente, dove può andare e come trova ciò che cerca.
Domande frequenti
Che cos’è l’architettura dell’informazione?
È la disciplina che organizza, struttura ed etichetta i contenuti di uno spazio digitale o fisico perché le persone possano trovarli, comprenderli e usarli senza sforzo, attraverso sistemi di organizzazione, etichettatura, navigazione e ricerca progettati attorno ai reali bisogni degli utenti.
Quali sono i quattro sistemi dell’architettura dell’informazione?
Sono i sistemi di organizzazione, che raggruppano i contenuti in categorie o gerarchie; i sistemi di etichettatura, che definiscono il linguaggio di menu e categorie; i sistemi di navigazione, che rendono percorribile la struttura; e i sistemi di ricerca, che permettono di trovare un contenuto specifico con una query.
Che differenza c’è tra UX e UI?
Lo UX design organizza l’esperienza complessiva dell’utente, inclusa l’architettura dell’informazione su cui si basa la navigazione; lo UI design si occupa dell’aspetto visivo dell’interfaccia che rende quella struttura concreta e utilizzabile. Sono fasi distinte ma complementari dello stesso processo di progettazione.
Che differenza c’è tra architettura dell’informazione e architettura del web?
L’architettura del web riguarda l’infrastruttura tecnica di comunicazione tra server, protocolli e standard di markup, mentre l’architettura dell’informazione riguarda come i contenuti vengono organizzati ed etichettati per essere trovati e compresi dalle persone. Si tratta di due livelli progettuali distinti che convergono nella realizzazione di un sito.
Come si valida un’architettura dell’informazione prima del lancio?
Si valida combinando card sorting, per capire come gli utenti raggrupperebbero i contenuti, e tree testing, per verificare se riescono a trovare un contenuto specifico in una struttura già abbozzata. Solo dopo questi passaggi la struttura viene trasformata in wireframe e poi in prototipo interattivo.
Come funziona l’architettura dell’informazione nei siti della pubblica amministrazione?
Nei siti pubblici italiani segue gli standard definiti da Designers Italia: ogni contenuto è classificato in content type con attributi obbligatori, organizzati in tassonomie e in un’alberatura di navigazione che tipicamente non supera il terzo livello, per mantenere i servizi facilmente raggiungibili dai cittadini.
Che differenza c’è tra architettura dell’informazione e architettura del computer?
L’architettura del computer descrive l’organizzazione hardware di un elaboratore, mentre l’architettura dell’informazione riguarda l’organizzazione dei contenuti in uno spazio informativo digitale o fisico: appartengono a due campi disciplinari diversi, ingegneria elettronica la prima, design dell’esperienza la seconda.
Quanto guadagna chi lavora nell’architettura dell’informazione?
Il compenso dipende da esperienza, settore e area geografica, e va verificato tramite le rilevazioni salariali aggiornate del mercato UX/UI di riferimento: non esiste una cifra unica applicabile a ogni contesto o livello di seniority.
