
Cos’è llms.txt e come funziona

Llms.txt è un file di testo in Markdown che si colloca nella radice di un sito per indicare agli assistenti AI quali pagine contengono le informazioni più importanti e in che ordine leggerle. Non blocca né autorizza l’accesso: segnala un percorso di lettura prioritario, lasciando al crawler la scelta di seguirlo.
Llms.txt in sintesi
- Cos’è: un file Markdown pubblicato all’indirizzo /llms.txt sulla radice del dominio o di una sottocartella.
- A cosa serve: dà a un LLM una mappa sintetica del sito, evitando che debba leggere menu, script e grafica per arrivare al contenuto utile.
- Struttura: un titolo H1, una citazione di riassunto, sezioni H2 con elenchi di link, più una sezione facoltativa “Optional” per i contenuti secondari.
- Differenza chiave: non sostituisce robots.txt (permessi di accesso) né sitemap.xml (elenco completo delle URL): aggiunge un terzo livello pensato per l’inferenza, non per l’indicizzazione.
- Supporto attuale: alcune piattaforme di documentazione e alcuni assistenti AI lo leggono; Google ha dichiarato di non usarlo per comparire nella Ricerca, generativa compresa.
Perché esiste llms.txt
Un LLM lavora dentro una finestra di contesto, cioè una quantità massima di testo che può elaborare in un passaggio. Una pagina HTML tradizionale, con menu di navigazione, script e grafica, occupa gran parte di quello spazio con elementi che non aggiungono informazione. Llms.txt nasce per risolvere proprio questo: offrire un punto d’ingresso pulito, senza il rumore del codice attorno al contenuto.
La proposta viene attribuita a Jeremy Howard, co-fondatore di Answer.AI, intorno al 2024. L’idea riprende un’intuizione semplice: se robots.txt dice ai crawler dove possono andare e sitemap.xml elenca dove possono trovare tutto, mancava un file che dicesse loro cosa conviene leggere per primo per capire il sito in poche righe.
Le pratiche SEO tradizionali, come i title ottimizzati o lo schema.org, restano pensate per far indicizzare una pagina a un motore di ricerca classico. Un assistente AI che deve rispondere a una domanda in linguaggio naturale ha un problema diverso: deve capire il contenuto, non solo localizzarlo. Llms.txt prova a colmare questo scarto. Offre un riassunto curato invece di un indice esaustivo.
A cosa serve e come funziona llms.txt
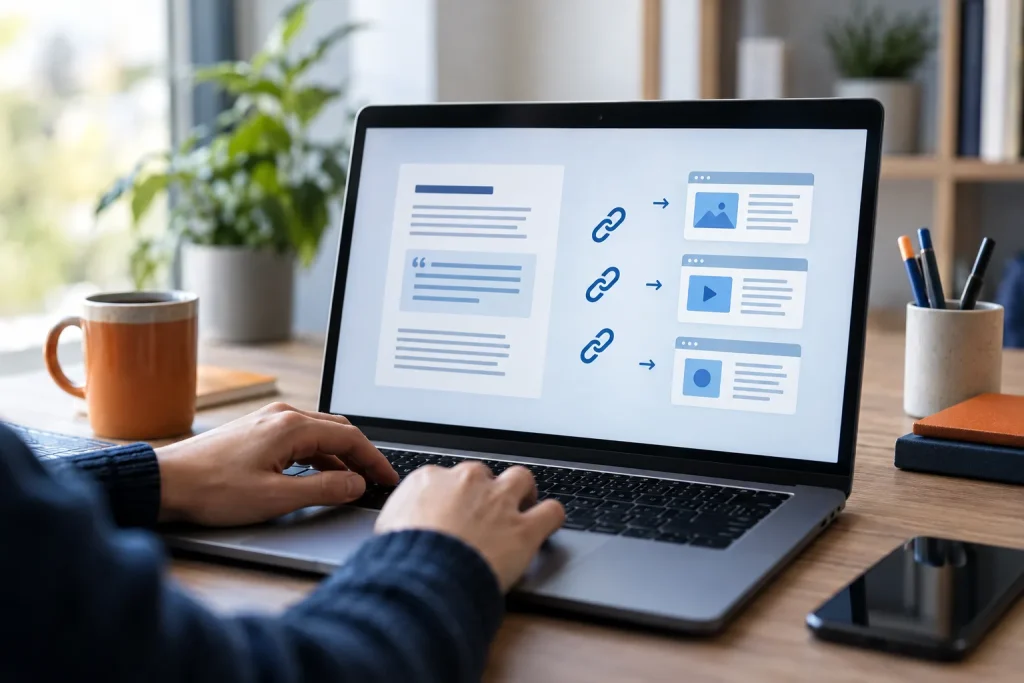
Llms.txt funziona come un indice ragionato: un agente AI o un crawler per l’intelligenza artificiale lo consulta prima di esplorare il resto del sito, individua le sezioni segnalate e segue solo i link rilevanti per la domanda che deve risolvere. Il resto del sito resta raggiungibile, ma non viene proposto come prima scelta.
Il vantaggio principale è il risparmio di token: invece di far elaborare al modello pagine intere con navigazione e script, il file comunica in poche righe dove si trova la documentazione, la pagina prodotto o la sezione più aggiornata. Un file opzionale, llms-full.txt, può accompagnarlo con il testo integrale delle pagine indicate, per i casi in cui serve il contenuto completo e non solo i link.
Questo meccanismo riguarda soprattutto la fase di inferenza, cioè il momento in cui l’AI risponde a una domanda in tempo reale, e non la fase di addestramento dei modelli: la distinzione conta, perché spiega perché pubblicare il file oggi non garantisce che un modello già addestrato ne tenga conto.
Struttura tipica di un file llms.txt
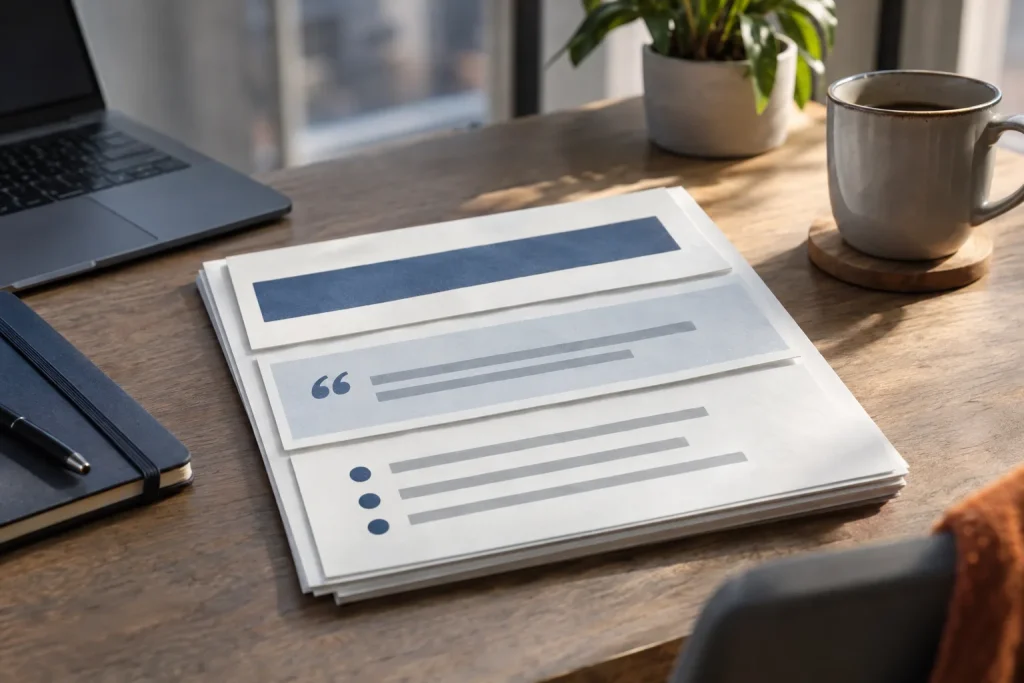
La specifica ufficiale del formato fissa un ordine preciso delle sezioni, in questo senso:
- Apri il file con un’intestazione H1 che contiene il nome del progetto o del sito: è l’unica sezione obbligatoria.
- Subito sotto inserisci un blockquote con un riassunto breve, che spiega in poche righe lo scopo del sito o del progetto.
- Aggiungi, se serve, uno o più paragrafi descrittivi senza ulteriori titoli, con dettagli utili a interpretare il resto del file.
- Organizza i link principali in sezioni introdotte da intestazioni H2, ciascuna con un elenco puntato in formato link più breve nota.
- Chiudi, quando serve, con una sezione “Optional” per i link secondari che un modello può saltare se ha poco spazio di contesto disponibile.
Ogni voce di un elenco è un link Markdown seguito, dopo i due punti, da una breve descrizione: quella frase è ciò che permette al modello di scegliere se seguire il link senza doverlo aprire. Quando esistono versioni Markdown pulite delle pagine, i link puntano a quelle (con estensione .md); in caso contrario restano validi i normali URL HTML, a patto che la descrizione sia chiara. Capita che un llms.txt venga pubblicato copiando un esempio online senza adattare le descrizioni al proprio sito: in quel caso il file perde lo scopo per cui è nato.
Differenze tra llms.txt, robots.txt e sitemap.xml
robots.txt stabilisce quali parti del sito i crawler possono visitare; llms.txt suggerisce un ordine di lettura a chi è già autorizzato a entrare. Un sito può avere entrambi i file, con funzioni che non si sovrappongono: il primo decide i permessi, il secondo la priorità.
| File | Scopo principale | Chi lo usa | Cosa succede se manca |
|---|---|---|---|
| robots.txt | Concede o blocca l’accesso dei crawler a parti del sito | motori di ricerca e crawler AI | il sito resta scansionabile senza restrizioni |
| sitemap.xml | Elenca tutte le URL indicizzabili del sito | motori di ricerca tradizionali | la scoperta delle pagine si basa solo sui link interni |
| llms.txt | Segnala un percorso di lettura sintetico per gli LLM | agenti AI e assistenti conversazionali | l’agente deve dedurre da solo la struttura del sito |
Nessuno dei tre file è obbligatorio per legge: sono convenzioni tecniche che un sito adotta volontariamente. Per capire come i motori interpretano questi segnali in fase di scansione serve guardare al funzionamento del file robots.txt, che resta il livello su cui si decide cosa è raggiungibile prima ancora di parlare di priorità di lettura.
Llms-full.txt: quando serve il file completo
Llms-full.txt è il file che raccoglie, in un unico documento, il testo integrale delle pagine indicate in llms.txt. Se llms.txt è l’indice, llms-full.txt è il contenuto per intero: alcuni strumenti di sviluppo, come gli IDE basati su AI, permettono di caricarlo direttamente per rispondere a domande dettagliate sulla documentazione di un progetto.
Ha senso pubblicarlo quando il sito ha una documentazione tecnica estesa, che un modello potrebbe dover consultare per intero in una sola sessione. Per un sito aziendale o un e-commerce, dove le pagine rilevanti sono poche e già sintetiche, llms.txt da solo copre la gran parte dei casi: aggiungere il file completo serve a poco se nessuno lo scarica mai.
Adozione e supporto attuale
Google ha dichiarato pubblicamente di non usare file di testo o Markdown, llms.txt incluso, per decidere cosa mostrare nella Ricerca, nemmeno nelle sue funzioni generative. Altri servizi AI possono comportarsi diversamente: l’adozione resta disomogenea, e non esiste un elenco ufficiale aggiornato di chi lo legge davvero e con quale frequenza.
Nella documentazione ufficiale del formato si segnala che migliaia di siti hanno già pubblicato un llms.txt e che Lighthouse, lo strumento di audit di Chrome, controlla la sua presenza tra i parametri legati alla navigazione da parte di agenti. Secondo una piattaforma di documentazione tecnica, gli agenti AI rappresenterebbero oltre il 40% dei lettori di documentazione online: un dato che riguarda specificamente i siti di documentazione e non i siti generici.
Conviene consigliarlo solo a chi ha già una documentazione o un catalogo organizzato da indicizzare: su un sito con poche pagine, tempo e contenuti stanno meglio investiti in ottimizzazione per i motori generativi che in un file che quasi nessun crawler legge oggi con continuità.
Errori frequenti e casi limite
Il formato non ha ancora uno strumento di validazione sintattica ufficiale e diffuso: un errore nella struttura del Markdown (un’intestazione H2 fuori posto, un link senza parentesi quadre) non genera un messaggio di avviso da nessuna parte, semplicemente il file diventa meno utile a chi lo legge. Prima di pubblicarlo conviene aprirlo come farebbe un lettore umano e controllare che titolo, citazione e sezioni siano nell’ordine previsto dalla specifica.
Se il sito è una documentazione tecnica
Conviene affiancare llms.txt a llms-full.txt e mantenere entrambi aggiornati a ogni rilascio: un file che punta a una versione superata dell’API genera risposte sbagliate quanto l’assenza del file stesso.
Se il sito è un e-commerce o un blog aziendale
Basta llms.txt con le sezioni principali (chi siete, cosa offrite, dove sono le pagine guida) e un aggiornamento solo quando cambia la struttura del sito, non a ogni nuovo prodotto o articolo.
Un punto che le guide in circolazione lasciano aperto è la relazione con i dati strutturati: llms.txt indica dove guardare, mentre gli esempi pratici di dati strutturati dicono come interpretare quello che c’è in pagina. Non esiste oggi una regola documentata su quale dei due un agente AI legga per primo quando entrambi sono presenti: finché non arriva una specifica più precisa, conviene mantenerli coerenti tra loro invece di sceglierne uno solo.
Domande frequenti
Dove si posiziona il file llms.txt sul sito?
Il file va pubblicato all’indirizzo /llms.txt nella radice del dominio, oppure in un sottopercorso come /docs/llms.txt se deve coprire solo quella sezione. Quando esistono più file su percorsi diversi, l’agente usa quello che copre il percorso più specifico, per esempio /docs/llms.txt per le pagine sotto /docs/.
Llms.txt sostituisce robots.txt?
Robots.txt resta il file che concede o blocca l’accesso dei crawler; llms.txt segnala un ordine di lettura a chi è già autorizzato a entrare. I due file convivono e rispondono a domande diverse.
Serve descrivere ogni pagina del sito nel file?
No, serve indicare le sezioni e le pagine più rilevanti con una breve descrizione per ciascuna. Un elenco troppo lungo riduce lo scopo del file, che è dare una sintesi, non duplicare la sitemap.
Google legge llms.txt per posizionare le pagine?
No, Google ha dichiarato di non usare questo file per la Ricerca, generativa compresa. Il file resta utile per altri assistenti AI e per strumenti di documentazione che lo supportano in modo esplicito.
Che differenza c’è tra llms.txt e llms-full.txt?
Llms.txt è un indice sintetico con link alle pagine principali; llms-full.txt raccoglie il testo integrale di quelle stesse pagine in un unico documento, utile quando un modello deve consultare tutto il contenuto in una sola sessione.
Quando conviene aggiornare il file llms.txt?
Conviene aggiornarlo quando cambia la struttura del sito o quando una sezione indicata non esiste più, non a ogni nuovo contenuto pubblicato. Per siti di documentazione tecnica l’aggiornamento è più frequente, legato ai rilasci delle versioni.
