
Crawler: cos’è e come funziona

Se vuoi controllare come i crawler scansionano e indicizzano le tue pagine, serve un intervento di ottimizzazione tecnica del sito su sitemap, robots.txt e velocità di caricamento.
Un crawler è un programma software automatizzato, noto anche come spider o bot, che esplora in modo sistematico le pagine del web seguendo i collegamenti ipertestuali, per raccogliere contenuti e aggiornare gli indici dei motori di ricerca o svolgere attività di monitoraggio e analisi dei dati online.
In breve
- Funzione: un crawler scansiona pagine web e invia i dati raccolti ai sistemi di indicizzazione dei motori di ricerca.
- Punto di partenza: la scansione parte da un elenco di indirizzi noti, chiamati seed URL, spesso ricavati da una sitemap.
- Limiti applicabili: le direttive del file robots.txt e il meta tag noindex possono impedire l’accesso o l’indicizzazione di una pagina.
- Come verificare l’attività: la presenza e la frequenza di passaggio di un crawler si osservano nei log del server web.
- Cosa fare su un sito: una struttura di link HTML navigabile e una sitemap aggiornata facilitano la scansione completa delle pagine.
- Altri usi del termine: “crawler” indica anche modelli di automodelli radiocomandati, un genere di videogioco e una traduzione lessicale dall’inglese, trattati in una sezione dedicata.
Cosa vuol dire crawler in informatica
In informatica un crawler è un software che naviga autonomamente sul web per scoprire e raccogliere informazioni sulle pagine esistenti, senza intervento manuale continuo. Il termine deriva dal verbo inglese to crawl, che significa “strisciare”, ed è entrato nel lessico tecnico italiano come sinonimo diretto di spider, spiderbot o web robot.
Un crawler non naviga come un utente umano: segue un percorso logico predefinito da un algoritmo, decide quali pagine visitare per prime in base a criteri come l’autorevolezza del dominio, la frequenza di aggiornamento dei contenuti e il numero di link in entrata. Il risultato del suo lavoro non è la lettura di una pagina, ma l’estrazione strutturata di testo, metadati, immagini e collegamenti, che vengono poi trasmessi a un sistema più ampio: un motore di ricerca, un archivio interno aziendale o uno strumento di monitoraggio.
Ogni crawler opera identificandosi tramite uno user agent, una stringa che ne dichiara l’identità ai server visitati. Questo permette ai gestori dei siti di riconoscere il tipo di bot in transito e di applicare regole differenziate: un crawler di un motore di ricerca riceve un trattamento diverso rispetto a un bot di scraping non dichiarato. La distinzione tra crawler legittimi e bot non identificati è alla base di molte politiche di sicurezza applicate ai server web.
Va distinto dal termine “crawling”, che indica invece l’attività stessa di scansione: il crawler è il programma, il crawling è il processo che quel programma esegue. Questa differenza terminologica è frequente nelle domande su cosa sia il crawling in informatica e va tenuta distinta dal concetto di indicizzazione, trattato più avanti.
Come funziona un crawler
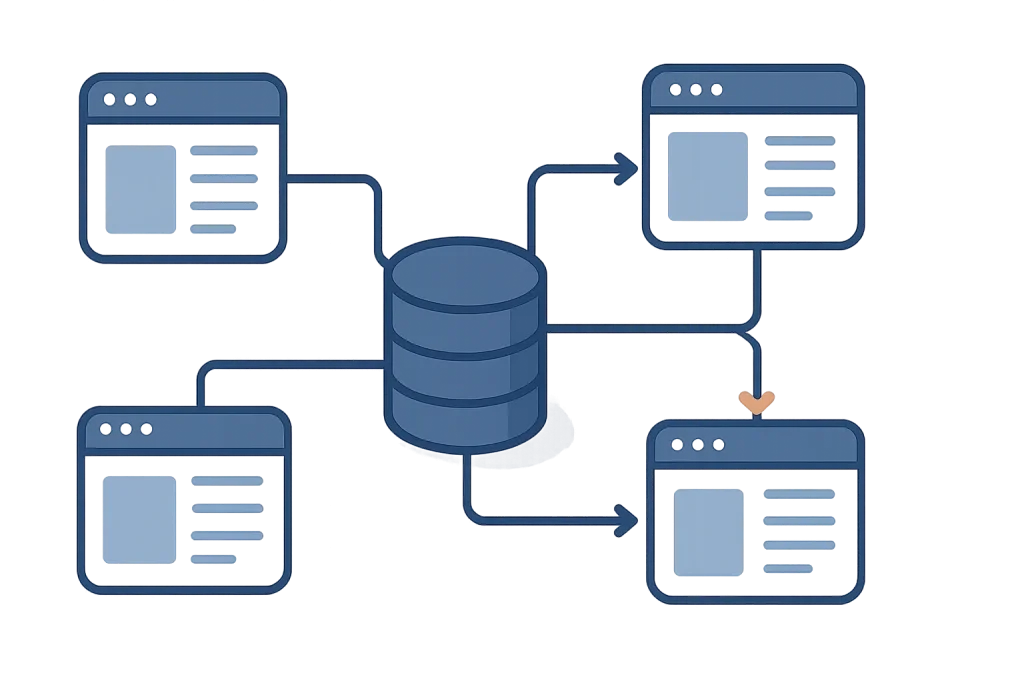
Il funzionamento di un crawler segue un ciclo ripetuto composto da quattro fasi operative, sempre nello stesso ordine logico, anche quando la scala dell’operazione coinvolge miliardi di pagine.
- Seed URL: il crawler parte da un elenco iniziale di indirizzi noti, ricavati da sitemap, pagine già scansionate in precedenza o URL segnalati manualmente.
- Scansione e lettura: accede a ciascuna pagina, ne scarica il codice HTML e analizza testo, meta tag, immagini e altri elementi strutturali.
- Estrazione dei collegamenti: individua tutti i link ipertestuali presenti nella pagina e li aggiunge a una coda di nuovi indirizzi da visitare.
- Trasmissione dei dati: invia le informazioni raccolte al sistema di destinazione, che le organizza in un indice consultabile o in un database interno.
La scansione non è un evento singolo: un crawler torna periodicamente sulle stesse pagine per verificare modifiche, nuovi contenuti o rimozioni. La cadenza di questi ritorni non è fissa, ma dipende da un insieme di fattori valutati da algoritmi dedicati, tra cui la frequenza storica di aggiornamento del sito, l’autorevolezza del dominio e la presenza di errori tecnici che rallentano l’accesso.
Se il sito usa menu costruiti solo in JavaScript
Se la navigazione interna di un sito è affidata esclusivamente a menu generati via JavaScript, un crawler può non riuscire a seguire tutti i collegamenti, o seguirli solo in parte, con il rischio che intere sezioni restino fuori dalla scansione. In questo caso conviene affiancare al menu dinamico una struttura di link HTML statici, raggiungibile da ogni pagina del sito, così da garantire un percorso di scansione completo indipendentemente dal linguaggio usato per l’interfaccia.
Differenza tra crawling e indicizzazione
Il crawling è l’attività di esplorazione delle pagine web svolta dal crawler; l’indexing, o indicizzazione, è il processo successivo con cui i contenuti scoperti vengono analizzati e inseriti nell’indice del motore di ricerca. Sono due fasi distinte e sequenziali, non sinonimi, e una pagina può attraversare la prima senza arrivare alla seconda.
- Pagina scansionata e indicizzata
- Il crawler ha letto il contenuto e il motore di ricerca lo ha inserito nel proprio indice, rendendolo potenzialmente visibile nei risultati.
- Pagina scansionata ma non indicizzata
- Il crawler ha visitato la pagina, ma il contenuto non entra nell’indice perché duplicato, di qualità insufficiente o bloccato da un’istruzione esplicita.
- Pagina non scansionata
- Il crawler non ha ancora raggiunto la pagina, oppure ne ha l’accesso impedito da direttive tecniche presenti nel sito.
Le cause più comuni che separano crawling e indicizzazione riguardano la qualità dei contenuti, la presenza di pagine duplicate all’interno dello stesso dominio e le istruzioni tecniche impostate dal gestore del sito, come il meta tag noindex o una regola di blocco nel file robots.txt. Chi gestisce un sito e vuole che una pagina compaia nei risultati di ricerca deve quindi verificare non solo che sia raggiungibile dal crawler, ma anche che nessuna direttiva ne impedisca l’ingresso nell’indice.
Questa distinzione è centrale per capire perché un contenuto pubblicato online non compaia immediatamente in una ricerca: il passaggio del crawler è condizione necessaria ma non sufficiente perché una pagina venga effettivamente indicizzata e resa disponibile agli utenti.
A cosa serve il crawling nel mondo digitale
Il crawling serve principalmente a mantenere aggiornato il database delle pagine web conosciute da un motore di ricerca, ma non è l’unico impiego: la stessa tecnologia viene applicata al monitoraggio dei siti, alla raccolta di dati competitivi e alla creazione di motori di ricerca interni.
Per i motori di ricerca, il crawler è lo strumento che permette di scoprire pagine nuove o modificate e aggiungerle progressivamente all’indice, così da restituire risultati aggiornati agli utenti. Senza questo processo continuo, un motore di ricerca mostrerebbe contenuti obsoleti o incompleti, ignorando le pagine pubblicate dopo l’ultima scansione registrata.
Per chi si occupa di ottimizzazione dei contenuti, conoscere il comportamento dei crawler è una condizione operativa: una pagina irraggiungibile dal crawler, o bloccata da una direttiva tecnica, non può comparire nei risultati di ricerca indipendentemente dalla qualità del contenuto pubblicato. Da questo derivano pratiche come la creazione di una sitemap aggiornata, l’uso di link interni coerenti e il controllo periodico delle direttive presenti nel file robots.txt.
Oltre alla ricerca, i crawler vengono impiegati per il monitoraggio tecnico di un sito, ad esempio per individuare link non funzionanti, pagine duplicate o tempi di risposta anomali, e per la raccolta automatizzata di dati pubblici a scopo di analisi comparativa. In questi contesti il crawler non alimenta un indice di ricerca, ma un rapporto tecnico o un database di confronto, mantenendo lo stesso principio di funzionamento: scansione, lettura, estrazione dei dati.
Tipologie di crawler ed esempi famosi
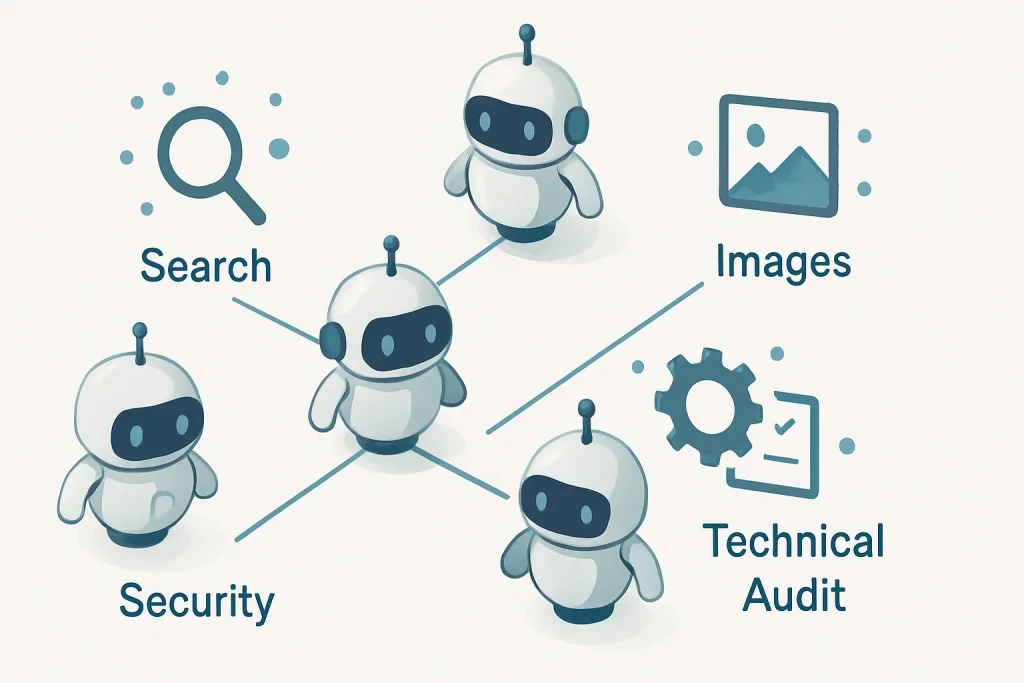
Non tutti i crawler condividono lo stesso obiettivo: esistono categorie distinte, ciascuna sviluppata per un compito specifico, e riconoscerle aiuta a interpretare correttamente il traffico automatizzato registrato da un sito.
| Tipologia | Obiettivo principale | Esempio |
|---|---|---|
| Generici | Scansione dell’intero web per aggiornare l’indice di un motore di ricerca | Googlebot, Bingbot |
| Verticali o tematici | Raccolta di un tipo specifico di contenuto (immagini, video, notizie, prodotti) | crawler per immagini, crawler per notizie |
| Di validazione e analisi | Simulazione della navigazione per individuare errori tecnici nelle pagine | strumenti di audit tecnico per la scansione dei siti |
| Aziendali o interni | Monitoraggio del proprio sito o raccolta dati dalla concorrenza | bot proprietari a bassa invasività |
| Bad bots | Scopi dannosi: scraping non autorizzato, spam, accessi ripetuti, sovraccarico dei server | bot di scraping, bot di credential stuffing |
Googlebot è il crawler ufficiale dei motori di ricerca di Google e opera in due varianti, una desktop e una per dispositivi mobili; dal 2019 la versione mobile è diventata quella predefinita per la maggior parte dei siti, un criterio noto come indicizzazione mobile-first. Bingbot svolge una funzione equivalente per Bing, con logiche di scansione proprie ma con lo stesso schema di base: seed URL, lettura, estrazione dei link, invio dei dati.
La categoria dei bad bots merita un’attenzione specifica perché non condivide le finalità legittime delle altre tipologie: copia contenuti per ripubblicarli altrove, inserisce commenti o richieste automatiche nei moduli di un sito, tenta accessi con credenziali sottratte o genera un volume di richieste tale da sovraccaricare un server. Riconoscere un bad bot richiede l’osservazione dello user agent dichiarato, della frequenza delle richieste e del rispetto o meno delle direttive presenti nel file robots.txt.
Regole ed etica: come i siti gestiscono i crawler
Un crawler può inviare migliaia di richieste al secondo a un server, con il rischio concreto di rallentarlo o renderlo temporaneamente inaccessibile; per questo motivo esistono regole condivise che i crawler legittimi rispettano nella quasi totalità dei casi.
Il file robots.txt è il primo strumento di controllo: posizionato nella radice di un dominio, indica ai bot quali sezioni del sito possono essere esplorate e quali restano escluse dalla scansione. Non è un meccanismo di sicurezza in senso stretto, perché un bot malevolo può ignorarlo, ma rappresenta la convenzione standard rispettata dai crawler dei motori di ricerca e dagli strumenti di analisi tecnica.
Il meta tag noindex agisce a un livello diverso: non impedisce la scansione della pagina, ma comunica al motore di ricerca di non inserirla nell’indice, anche se il contenuto è stato letto correttamente. Questa differenza è rilevante perché una pagina con noindex continua a consumare risorse di scansione pur non comparendo mai nei risultati di ricerca.
Se serve limitare la frequenza di scansione senza bloccarla del tutto
Se l’obiettivo non è impedire l’accesso ma solo ridurre la frequenza delle visite, la soluzione più diretta è intervenire sulle direttive di crawl-delay dove supportate dal crawler specifico, oppure segmentare la sitemap in modo da segnalare priorità diverse tra le sezioni del sito. Se invece l’obiettivo è impedire del tutto l’accesso a una sezione riservata, la direttiva corretta nel robots.txt è quella di disallow sul percorso interessato, verificando poi che nessun link interno continui a puntare verso quella stessa area.
Come bloccare o gestire i crawler sul proprio sito
Gestire un crawler indesiderato richiede prima di identificarlo con certezza, poi di scegliere lo strumento tecnico più adatto al livello di blocco necessario, dal semplice suggerimento fino all’interruzione forzata delle richieste.
- Identificazione: analizzare i log del server per individuare lo user agent e l’indirizzo IP del bot in transito.
- Verifica della legittimità: controllare se lo user agent dichiarato corrisponde a un crawler noto e se il suo comportamento rispetta le direttive del sito.
- Applicazione delle direttive: impostare una regola di disallow nel file robots.txt per le sezioni da escludere dalla scansione.
- Blocco tecnico, se necessario: per bot che ignorano le direttive, applicare regole a livello di server o di infrastruttura di rete per rifiutare le richieste provenienti da quello user agent o da quell’indirizzo.
- Monitoraggio continuo: ripetere periodicamente l’analisi dei log, perché nuovi bot possono comparire e le direttive impostate in precedenza possono richiedere aggiornamenti.
Il file robots.txt resta una direttiva di cortesia: un crawler progettato per ignorarla continuerà a fare richieste indipendentemente dal contenuto del file. In questi casi la gestione efficace richiede un intervento a livello di infrastruttura, capace di riconoscere pattern di richieste anomale e di interrompere l’accesso prima che raggiunga le pagine del sito.
Un errore frequente consiste nel bloccare per errore i crawler legittimi dei motori di ricerca insieme ai bot dannosi, ad esempio con regole troppo generiche basate solo sulla frequenza delle richieste: questo comportamento può escludere un sito dall’indicizzazione senza che il gestore se ne accorga subito, con un impatto diretto sulla visibilità nei risultati di ricerca.
Altri significati della parola crawler
Al di fuori dell’informatica, “crawler” indica realtà molto diverse tra loro, accomunate solo dal richiamo etimologico al verbo inglese to crawl, “strisciare” o “muoversi lentamente”.
| Ambito | Significato |
|---|---|
| Modellismo radiocomandato | Un crawler RC è un automodello a motorizzazione elettrica progettato per affrontare percorsi off-road impervi e sconnessi, distinto da uno scaler per l’enfasi sulle prestazioni fuoristrada rispetto alla riproduzione fedele di un veicolo reale. |
| Traduzione lessicale | In inglese “crawler” indica anche una creatura che si muove lentamente, come un insetto strisciante, oltre al significato informatico di programma di indicizzazione siti. |
| Videogiochi e narrativa | Un dungeon crawler è un genere di videogioco o di narrativa incentrato sull’esplorazione progressiva di ambienti sotterranei o labirintici, spesso con combattimenti ed elementi di ruolo. |
| Pesca | Un crawler esca indica un’esca artificiale o naturale pensata per muoversi strisciando sul fondo o sulla superficie dell’acqua durante la pesca. |
| Vita notturna | Un pub crawl è un giro tra più locali in una stessa serata, espressione colloquiale legata allo stesso verbo “to crawl”. |
La differenza tra un crawler RC e uno scaler riguarda principalmente l’obiettivo del modello: lo scaler punta alla riproduzione fedele di un veicolo reale in scala, mentre il crawler privilegia la capacità di superare ostacoli e terreni accidentati, con telaio, motorizzazione e pneumatici pensati per l’aderenza fuoristrada piuttosto che per il realismo estetico.
Il termine “crawl” nel nuoto indica invece uno stile natatorio, spesso chiamato stile libero, caratterizzato da un movimento alternato delle braccia e da un battito continuo delle gambe: anche in questo caso il richiamo etimologico resta lo stesso verbo inglese, applicato a un contesto sportivo del tutto separato da quello informatico.
Domande frequenti
Cosa vuol dire crawler?
Nel contesto informatico, crawler indica un programma automatizzato che esplora le pagine web seguendo i link per raccogliere contenuti e inviarli a un sistema di indicizzazione o monitoraggio, mentre in altri ambiti il termine indica automodelli fuoristrada, un genere di videogioco o un’esca da pesca.
Qual è la differenza tra un crawler e uno scaler?
Nel modellismo radiocomandato lo scaler riproduce fedelmente un veicolo reale in scala, mentre il crawler è progettato per affrontare ostacoli e terreni accidentati, privilegiando aderenza e capacità di trazione rispetto al realismo estetico del modello.
Che cos’è il crawling in informatica?
Il crawling è l’attività di esplorazione automatica delle pagine web svolta da un crawler: parte da un elenco di indirizzi noti, legge il contenuto di ogni pagina, estrae i collegamenti presenti e invia i dati raccolti a un sistema di indicizzazione o analisi.
Qual è la funzione del crawling rispetto all’indicizzazione?
Il crawling scopre e legge le pagine web, mentre l’indicizzazione è il passaggio successivo in cui i contenuti scoperti vengono analizzati e inseriti nell’indice di un motore di ricerca: una pagina può essere scansionata senza essere indicizzata, se bloccata da direttive tecniche o giudicata di qualità insufficiente.
Come si traduce “web crawling” in italiano?
“Web crawling” si traduce come scansione del web ed è comunemente usato anche in italiano nella forma originale inglese, per indicare l’attività di esplorazione automatica delle pagine web svolta da un crawler o spider.
Cosa vuol dire dungeon crawler?
Un dungeon crawler è un genere di videogioco o di narrativa basato sull’esplorazione progressiva di ambienti sotterranei o labirintici, con combattimenti, raccolta di oggetti ed elementi di progressione del personaggio: il termine non ha relazione diretta con i crawler informatici, se non nel richiamo etimologico al verbo “strisciare”.
Cosa sono i pub crawl?
Un pub crawl è un giro organizzato tra più locali nella stessa serata, un’espressione colloquiale che condivide con i crawler informatici solo l’origine etimologica dal verbo inglese “to crawl”, senza alcuna relazione con la tecnologia web.
Che stile è crawl nel nuoto?
Nel nuoto, il crawl è comunemente conosciuto come stile libero: prevede un movimento alternato delle braccia e un battito continuo delle gambe, ed è considerato lo stile più veloce tra quelli praticati in acqua.
