
Deep learning: definizione e funzionamento

Il deep learning (apprendimento profondo), nell’ambito dell’intelligenza artificiale, è la tecnica di machine learning che addestra reti neurali artificiali organizzate in molti strati per estrarre automaticamente pattern complessi da grandi volumi di dati, senza richiedere una selezione manuale delle caratteristiche. In questa pagina il termine indica esclusivamente questo significato tecnico, non altri eventuali usi generici dell’espressione al di fuori dell’informatica.
In breve
- Cosa fa: il deep learning permette a un sistema di riconoscere pattern in immagini, testi, suoni o dati strutturati analizzando gli input attraverso più strati di elaborazione.
- Quando si applica: è utile quando i dati sono complessi e abbondanti e le caratteristiche rilevanti non sono definibili facilmente a priori, come in visione artificiale o linguaggio naturale.
- Condizioni e limiti: richiede grandi quantità di dati etichettati o non etichettati e potenza di calcolo basata su GPU; senza dati sufficienti il modello tende all’overfitting.
- Come verificare: il numero di strati nascosti della rete distingue un modello di machine learning tradizionale da uno di deep learning, anche se la soglia esatta varia tra due e quattro strati a seconda della fonte tecnica considerata.
- Cosa fare: la scelta dell’architettura (convoluzionale, ricorrente o a trasformatore) dipende dal tipo di dato da elaborare, rispettivamente immagini, sequenze temporali o linguaggio.
- Tempo e risorse: l’addestramento di un modello profondo richiede cicli ripetuti di calcolo su hardware parallelo; la durata dipende dalla dimensione della rete e dal volume dei dati, non da un valore fisso.
Cosa si intende con deep learning
Con deep learning si intende una branca avanzata del machine learning che usa reti neurali artificiali multistrato per apprendere rappresentazioni sempre più astratte dei dati, senza una fase preliminare di estrazione manuale delle caratteristiche. La traduzione italiana più diffusa è “apprendimento profondo”; l’aggettivo “profondo” non indica una capacità di ragionamento paragonabile a quella umana, ma il numero elevato di strati nascosti attraversati dall’informazione durante l’elaborazione.
Il termine si colloca dentro una gerarchia precisa: l’intelligenza artificiale è il campo generale che comprende ogni sistema capace di simulare compiti cognitivi umani; il machine learning, in italiano spesso reso come “apprendimento automatico”, è il sottoinsieme in cui i sistemi migliorano le proprie prestazioni analizzando dati anziché seguire regole scritte esplicitamente; il deep learning è, a sua volta, il sottoinsieme del machine learning che sfrutta reti neurali profonde per gestire dati non strutturati come immagini, audio e testo. Questa struttura a matrioska spiega perché ogni tecnica di deep learning utilizza reti neurali, mentre non tutte le reti neurali sono abbastanza profonde da rientrare nella definizione di deep learning.
Una rete neurale semplice, con uno o due strati nascosti, può risolvere problemi di classificazione elementare; una rete profonda, con tre o più strati (in alcuni casi centinaia), riesce invece a scomporre un problema complesso in sotto-pattern progressivi, dal bordo di un’immagine alla forma completa di un oggetto, dalla singola parola alla struttura dell’intera frase.
Come funziona il deep learning
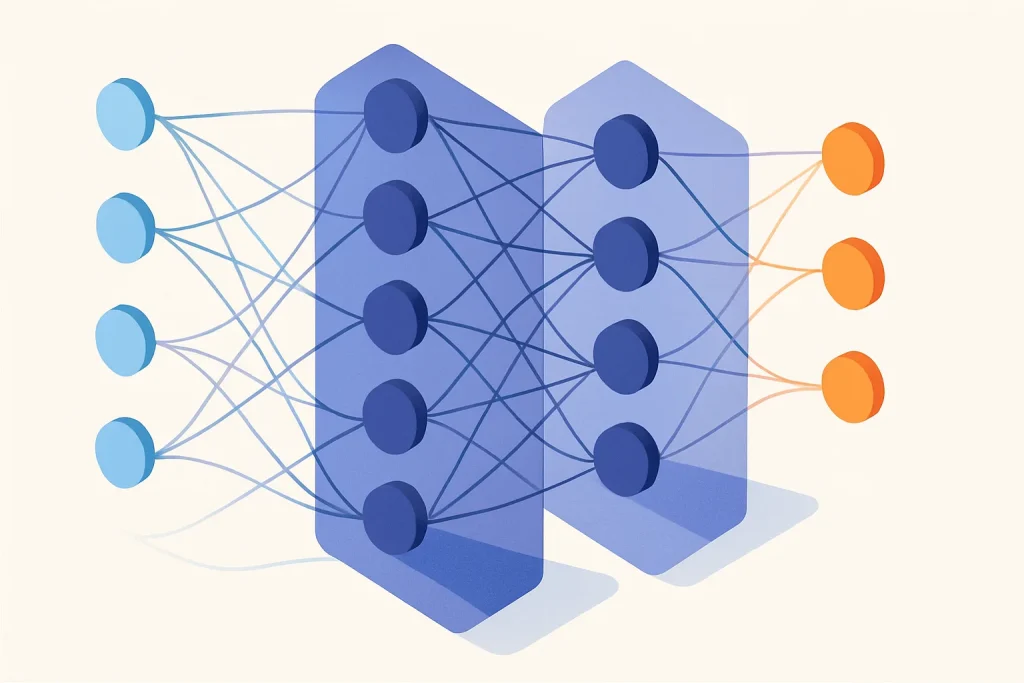
Il deep learning funziona facendo attraversare i dati grezzi da una sequenza di strati di neuroni artificiali, ciascuno dei quali applica una trasformazione matematica e passa il risultato allo strato successivo fino a produrre un output finale, che sia una classificazione, una previsione o un contenuto generato.
La rete è composta da uno strato di input, che riceve i dati (pixel, token testuali, valori di sensori), da uno o più strati nascosti, dove avviene l’elaborazione progressiva dei pattern, e da uno strato di output, che restituisce il risultato. Ogni connessione tra neuroni ha un peso, cioè un parametro numerico che ne determina l’importanza: durante l’addestramento questi pesi vengono regolati ripetutamente per ridurre la distanza tra l’output prodotto e quello atteso, misurata da una funzione di perdita.
La correzione avviene tramite la backpropagation, un algoritmo che calcola quanto ogni peso ha contribuito all’errore finale e lo aggiorna in proporzione, propagando la correzione all’indietro attraverso gli strati. Questo ciclo di previsione, misurazione dell’errore e aggiustamento dei pesi si ripete migliaia o milioni di volte sullo stesso insieme di dati, fino a quando le prestazioni del modello si stabilizzano.
Un fattore determinante per lo sviluppo pratico del deep learning è stata la disponibilità di hardware parallelo: le GPU, progettate per eseguire molti calcoli matriciali simultaneamente, hanno reso possibile addestrare reti con decine o centinaia di strati in tempi gestibili. A questo si sono aggiunti l’aumento della quantità di dati digitali disponibili e il perfezionamento degli algoritmi di addestramento, tre condizioni che insieme hanno reso applicabili tecniche di rete neurale studiate già a partire dagli anni ottanta.
Differenza tra deep learning e machine learning
La differenza principale sta nel modo in cui il modello ottiene le caratteristiche rilevanti dai dati: nel machine learning tradizionale un esperto seleziona manualmente le variabili da analizzare, mentre nel deep learning è la rete stessa, grazie alla profondità degli strati, a scoprire automaticamente quali caratteristiche contano, partendo dai dati grezzi.
| Aspetto | Machine learning tradizionale | Deep learning |
|---|---|---|
| Estrazione delle caratteristiche | Manuale, a cura di un esperto | Automatica, appresa dagli strati nascosti |
| Numero di strati nascosti | Uno o due, oppure nessuna rete neurale | Tre o più, fino a centinaia |
| Volume di dati richiesto | Moderato | Molto elevato |
| Potenza di calcolo | Contenuta | Elevata, tipicamente su GPU |
| Tipo di dati gestiti | Perlopiù strutturati e tabellari | Anche non strutturati: immagini, audio, testo |
Rete neurale semplice o profonda: come distinguerle
Se una rete neurale ha uno o due strati nascosti, viene considerata una rete neurale tradizionale, adatta a compiti di classificazione relativamente semplici. Se invece la rete supera questa soglia, arrivando tipicamente a tre o più strati nascosti, rientra nella categoria del deep learning ed è in grado di modellare relazioni molto più complesse tra i dati. La soglia esatta non è univoca: alcune trattazioni tecniche la fissano a due strati, altre a quattro, ma il criterio distintivo resta sempre la profondità dell’architettura, non il tipo di algoritmo di addestramento.
Il machine learning comprende tradizionalmente tre paradigmi di addestramento, applicabili anche al deep learning: l’apprendimento supervisionato, che usa dati etichettati per insegnare al modello la relazione tra input e output desiderato; l’apprendimento non supervisionato, che cerca strutture e raggruppamenti in dati privi di etichetta; l’apprendimento per rinforzo, in cui un agente impara agendo in un ambiente e ricevendo penalità o ricompense. Un modello linguistico di grandi dimensioni (LLM) è un’applicazione specifica del deep learning, addestrata su enormi quantità di testo con architettura a trasformatore: la differenza tra machine learning e LLM è quindi una differenza tra categoria generale e singola famiglia di modelli costruita al suo interno.
Quali sono le principali architetture di reti neurali
Le architetture di deep learning si distinguono in base al tipo di dato che devono elaborare, e questa scelta determina in gran parte le prestazioni del modello finale.
- Reti neurali convoluzionali (CNN)
- architetture ottimizzate per immagini e video, dove filtri scorrono sulla matrice dei pixel per individuare bordi, texture e forme a livelli progressivi.
- Reti neurali ricorrenti e LSTM
- architetture pensate per dati sequenziali, come serie temporali o segnali audio, in cui l’output di un passo influenza l’elaborazione del passo successivo.
- Trasformatori (Transformer)
- architetture basate su meccanismi di attenzione che pesano l’importanza reciproca degli elementi di una sequenza; sono alla base dei moderni modelli linguistici generativi.
- Reti generative avversarie (GAN)
- coppie di reti, una generatrice e una discriminante, che si addestrano a vicenda per produrre dati sintetici realistici, come immagini o audio.
La scelta dell’architettura non è intercambiabile: una rete convoluzionale applicata a un testo perde la relazione sequenziale tra le parole, mentre una rete ricorrente applicata a un’immagine non sfrutta la struttura spaziale dei pixel. Per questo motivo i sistemi più avanzati combinano spesso più architetture nello stesso flusso di elaborazione, ad esempio una componente convoluzionale per estrarre caratteristiche visive seguita da una componente a trasformatore per interpretarne il significato in contesto.
Applicazioni pratiche del deep learning
Il deep learning trova impiego ogni volta che un problema richiede di individuare pattern in dati complessi e poco strutturati, dove le regole manuali risulterebbero troppo rigide o incomplete.
Nella visione artificiale, la tecnica abilita il riconoscimento facciale, l’analisi di immagini mediche per individuare anomalie nei tessuti e la percezione dell’ambiente nei sistemi di guida autonoma. Nell’elaborazione del linguaggio naturale (NLP), permette la traduzione automatica, gli assistenti vocali e i modelli generativi capaci di produrre testo coerente. In ambito finanziario e industriale, i modelli di deep learning individuano schemi di transazioni sospette nel tempo, analizzando il comportamento dei conti e l’attività dei dispositivi, e supportano la manutenzione predittiva delle apparecchiature, apprendendo segnali di allerta precoce da letture di sensori e dati storici di guasto.
Un esempio concreto di valore generato riguarda i sistemi di raccomandazione usati nel commercio digitale: modellando le relazioni tra utenti, prodotti e comportamenti passati, il deep learning migliora la personalizzazione dei contenuti proposti, con un effetto diretto sui ricavi delle piattaforme che li adottano. Negli ambiti a rischio più elevato, come la diagnostica medica o le decisioni creditizie, l’output del modello richiede comunque una convalida e una supervisione umana, perché la rete apprende relazioni statistiche e non un ragionamento clinico o normativo.
Che cosa ha favorito lo sviluppo del deep learning
Lo sviluppo pratico del deep learning è stato favorito dalla convergenza di tre fattori: l’aumento massiccio dei dati digitali disponibili per l’addestramento, la diffusione di hardware di calcolo parallelo come le GPU e il perfezionamento degli algoritmi di ottimizzazione usati per regolare i pesi delle reti. Le reti neurali artificiali erano già oggetto di studio dagli anni ottanta, ma solo tra la fine degli anni duemila e l’inizio degli anni duemiladieci questi tre elementi si sono allineati, rendendo i modelli profondi realmente efficaci su problemi complessi.
Tra i contributi più rilevanti nella storia recente della disciplina rientra l’introduzione dell’apprendimento auto-supervisionato, una modalità di addestramento che permette a una rete di apprendere da dati non etichettati simulando compiti di apprendimento supervisionato: il termine è stato coniato da Yann LeCun per distinguere questo approccio dal tradizionale apprendimento non supervisionato, ed è oggi centrale nell’addestramento dei grandi modelli generativi. I contributi fondativi alle reti neurali profonde vengono generalmente attribuiti a un gruppo ristretto di ricercatori, tra cui lo stesso LeCun, Geoffrey Hinton e Yoshua Bengio, riconosciuti per il lavoro sulle architetture multistrato e sugli algoritmi di addestramento che hanno reso possibile l’attuale generazione di modelli.
Classificazioni dell’intelligenza artificiale distinte dal deep learning
Alcune classificazioni dell’intelligenza artificiale, come la distinzione in quattro categorie per capacità cognitiva simulata (sistemi reattivi, a memoria limitata, con teoria della mente, autocoscienti) o in livelli di autonomia crescente, descrivono il comportamento atteso di un sistema e non la tecnica usata per costruirlo: un assistente conversazionale basato su deep learning rientra tipicamente nella categoria dei sistemi a memoria limitata, perché utilizza il contesto recente della conversazione senza conservare una comprensione persistente del mondo. Un sistema conversazionale generativo di grandi dimensioni, costruito con architettura a trasformatore, è quindi un’applicazione del deep learning e non una categoria alternativa ad esso. Non esiste inoltre una classifica oggettiva e stabile dell’intelligenza artificiale “più avanzata” o della soluzione gratuita “migliore”: la valutazione dipende dal compito specifico, dal benchmark utilizzato e cambia con la frequenza degli aggiornamenti dei modelli.
Sfide, limiti ed errori frequenti nel deep learning
Il principale rischio tecnico del deep learning è l’overfitting: il modello impara troppo bene i dettagli e il rumore del set di addestramento, perdendo la capacità di generalizzare su dati nuovi.
Se il modello memorizza troppo i dati di addestramento
Se le prestazioni sui dati di addestramento sono molto superiori a quelle sui dati di verifica, il modello è in overfitting: in questo caso si applicano tecniche di regolarizzazione come il dropout, che disattiva casualmente una quota di neuroni a ogni ciclo di addestramento, oppure si riduce la complessità della rete o si aumenta la quantità di dati di addestramento disponibili.
Se invece le prestazioni restano basse sia sui dati di addestramento sia su quelli di verifica, il problema è opposto, l’underfitting: la rete non ha sufficiente capacità o non è stata addestrata abbastanza a lungo per catturare i pattern rilevanti, e la soluzione è aumentare la profondità della rete o il numero di cicli di addestramento.
Un errore frequente nella pratica riguarda la scelta della funzione di attivazione e dell’algoritmo di ottimizzazione: funzioni come la ReLU sono oggi preferite perché limitano il problema del gradiente che si annulla progressivamente negli strati più profondi, mentre ottimizzatori adattivi come Adam regolano il tasso di apprendimento in modo dinamico, riducendo i tempi di convergenza rispetto alla discesa del gradiente classica. Un secondo limite riguarda la governance dei modelli in produzione: l’addestramento isolato di una rete non basta a garantirne l’affidabilità operativa, perché servono processi di monitoraggio, controllo delle versioni e validazione continua, soprattutto quando l’output del modello incide su decisioni ad alto impatto, come la diagnostica medica o l’erogazione del credito.
Come iniziare a studiare il deep learning
Lo studio del deep learning si costruisce in modo progressivo, partendo dalle basi matematiche e arrivando alla costruzione pratica di modelli con un framework di sviluppo.
- Consolidare le basi di algebra lineare, calcolo differenziale e probabilità, necessarie per comprendere il funzionamento di pesi, gradienti e funzioni di perdita.
- Studiare i concetti fondamentali di machine learning, inclusi i tre paradigmi di addestramento (supervisionato, non supervisionato, per rinforzo), prima di affrontare le reti profonde.
- Comprendere la struttura di una rete neurale a strati e il funzionamento della backpropagation su esempi semplici, prima di passare ad architetture come CNN o trasformatori.
- Scegliere un framework di sviluppo per implementare modelli, tipicamente basato su Python, che gestisca in automatico il calcolo dei gradienti e l’esecuzione su GPU.
- Applicare quanto appreso su un set di dati reale di dimensioni contenute, valutando le prestazioni su dati mai visti durante l’addestramento per verificare l’assenza di overfitting.
Le piattaforme di formazione dedicate offrono percorsi strutturati che seguono questa stessa progressione, dai fondamenti matematici fino alla costruzione di modelli applicati a casi reali, e restano un riferimento utile per chi desidera approfondire gli aspetti pratici oltre la teoria.
Domande frequenti
Cosa si intende per deep learning?
Si intende una tecnica di machine learning basata su reti neurali artificiali con molti strati, capace di apprendere automaticamente pattern complessi da grandi quantità di dati non strutturati, senza una selezione manuale preventiva delle caratteristiche.
Qual è la differenza tra machine learning e deep learning?
Il machine learning è la categoria generale in cui i sistemi apprendono dai dati; il deep learning è la sua branca più avanzata, che usa reti neurali profonde per estrarre automaticamente le caratteristiche rilevanti, anziché riceverle selezionate manualmente da un esperto.
Quali sono alcuni esempi concreti di deep learning?
Riconoscimento facciale, diagnostica per immagini, traduzione automatica, assistenti vocali, guida autonoma, rilevamento di frodi finanziarie e sistemi di raccomandazione nel commercio digitale sono applicazioni concrete basate su reti neurali profonde.
Qual è la traduzione in italiano di “deep learning”?
La traduzione più diffusa è “apprendimento profondo”, dove l’aggettivo “profondo” indica il numero elevato di strati nascosti attraversati dai dati, non una capacità di ragionamento paragonabile a quella umana.
Chi è considerato il padre del deep learning?
Non esiste un singolo fondatore riconosciuto: i contributi fondativi vengono generalmente attribuiti a un gruppo ristretto di ricercatori, tra cui Geoffrey Hinton, Yann LeCun e Yoshua Bengio, per il lavoro sulle reti neurali multistrato e sugli algoritmi di addestramento.
Che cosa ha favorito lo sviluppo del deep learning?
Tre fattori combinati: l’aumento della quantità di dati digitali disponibili, la diffusione di GPU per il calcolo parallelo e il miglioramento degli algoritmi di addestramento, che insieme hanno reso applicabili tecniche di rete neurale studiate già dagli anni ottanta.
Quali sono i tre tipi di machine learning?
Apprendimento supervisionato, basato su dati etichettati; apprendimento non supervisionato, che individua strutture in dati privi di etichetta; apprendimento per rinforzo, in cui un agente impara ricevendo ricompense o penalità dall’ambiente in cui opera.
Che tipo di intelligenza artificiale è un sistema come ChatGPT?
È un modello di intelligenza artificiale generativa basato su deep learning, costruito con architettura a trasformatore e addestrato su grandi quantità di testo per produrre risposte in linguaggio naturale coerenti con il contesto della conversazione.
