
Deploy e rollback: cosa sono e come funzionano

Il deploy e il rollback sono le due operazioni complementari che regolano il rilascio del software: la prima porta una nuova versione dell’applicazione in esercizio, la seconda ripristina la versione stabile precedente quando il rilascio genera errori critici per gli utenti finali.
Deploy e rollback in sintesi
- Definizione: il deploy sposta codice e configurazioni verso l’ambiente di produzione, il rollback riporta il sistema allo stato funzionante precedente, detto anche stato n-1.
- Quando serve il rollback: solo quando il deploy è tecnicamente riuscito ma genera errori gravi, blocchi o malfunzionamenti visibili agli utenti.
- Strategie di rilascio: rolling deployment, blue-green deployment, canary release e progressive delivery riducono il rischio in modi diversi.
- Automazione: le pipeline di CI/CD rendono il rollback un’operazione tracciabile e ripetibile, spesso affiancata da feature flag.
- Precauzioni: backup o snapshot recenti e comunicazione agli stakeholder prima di intervenire sono condizioni minime per un rollback sicuro.
- Limiti: il rollback non recupera file persi né risolve problemi non legati a una modifica recente.
Cos’è il deploy e quali fasi prevede
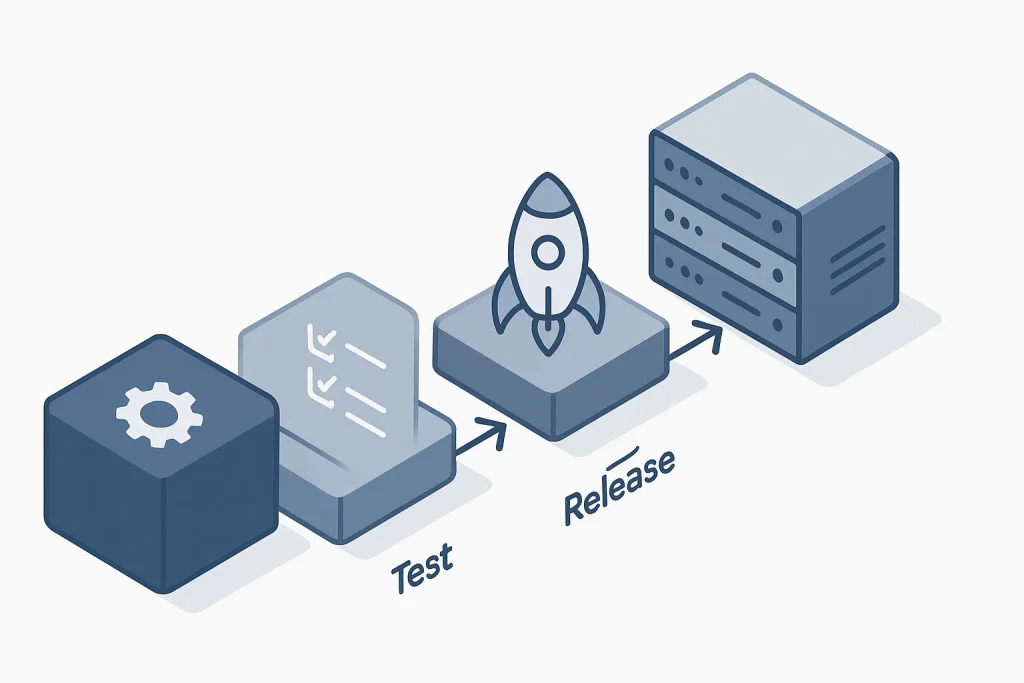
Il deploy consiste nel trasferire codice, file e configurazioni aggiornate da un ambiente di sviluppo o test a un ambiente di produzione attivo, rendendo la nuova versione accessibile agli utenti finali. Non è un’operazione istantanea: segue una sequenza di passaggi che ne determina l’affidabilità.
- Build: il codice sorgente viene compilato e vengono preparati gli asset necessari, come immagini, fogli di stile e script.
- Test: vengono eseguiti controlli automatici per individuare regressioni prima che la versione raggiunga la produzione.
- Rilascio: i file vengono copiati sul server, i container (ad esempio basati su Docker) vengono aggiornati, oppure vengono attivate le funzioni in architetture serverless.
Ogni fase genera un artifact versionato, cioè un pacchetto tracciabile che diventa il riferimento per un eventuale ritorno a una versione precedente. Senza questa tracciabilità, un rollback successivo risulta più lento e meno affidabile, perché manca un punto esatto a cui tornare.
Il deploy può interessare porzioni diverse del sistema: il solo codice applicativo, lo schema di un database oppure la configurazione dell’infrastruttura descritta come IaC. Distinguere questi ambiti è determinante, perché ciascuno richiede un meccanismo di rollback differente, trattato nelle sezioni successive.
Cos’è il rollback e quando è necessario
Il rollback è la procedura che annulla l’ultimo rilascio e riporta il sistema allo stato n-1, cioè all’ultima versione funzionante nota prima dell’intervento. Si attiva quando il deploy ha tecnicamente avuto successo, ma la nuova versione introduce bug critici, blocchi o malfunzionamenti percepiti dagli utenti.
Se il deploy fallisce prima di raggiungere la produzione
Se il processo di build o di test si interrompe prima che il traffico venga spostato sulla nuova versione, di norma non serve un rollback: gli utenti continuano a usare la versione precedente, perché il rilascio non è mai diventato attivo.
Se il deploy ha successo ma produce errori in produzione
Se invece la nuova versione viene attivata e genera errori 500, crash dell’applicazione, cali di performance o problemi di sicurezza scoperti subito dopo il rilascio, il rollback diventa l’azione corretta per ripristinare la stabilità nel minor tempo possibile.
Gli elementi che rendono efficace un rollback sono un versionamento rigoroso del codice e delle interfacce, una gestione sicura delle modifiche allo schema del database che eviti operazioni distruttive o non retrocompatibili, e un’automazione tramite strumenti di integrazione e consegna continua. Senza questi tre elementi, anche un rollback tecnicamente possibile può risultare lento o parziale.
È importante non confondere il rollback con un semplice annullamento di una singola modifica: nella maggior parte dei casi riporta indietro l’intero insieme di cambiamenti introdotti dal rilascio, non una modifica isolata al suo interno.
Quali sono le principali strategie di deploy
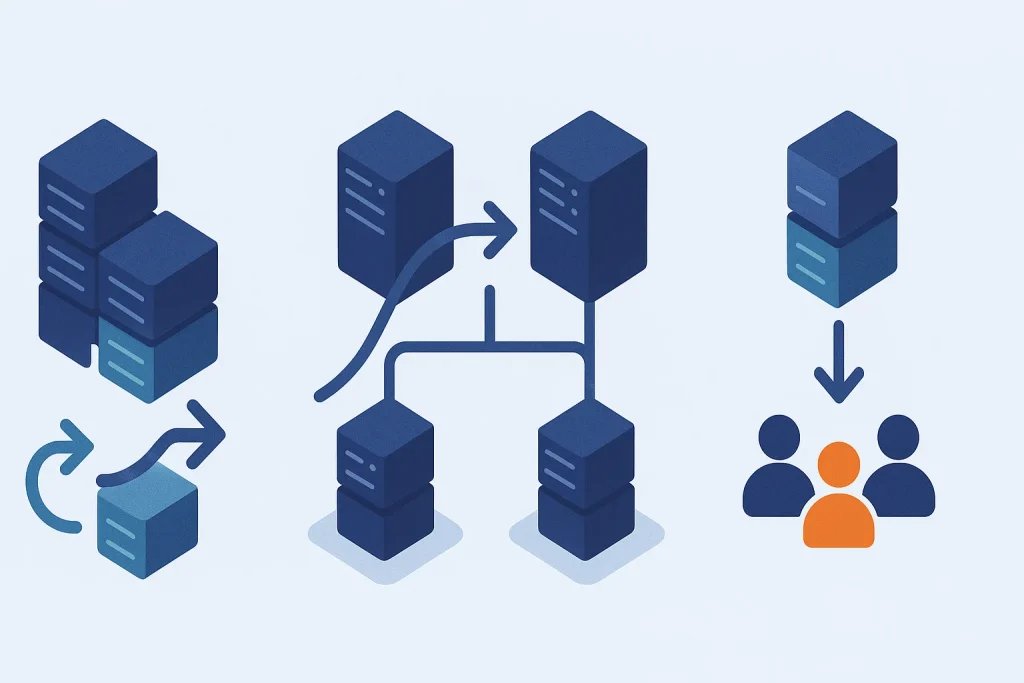
Esistono quattro approcci principali per ridurre il rischio di un rilascio, ciascuno con un diverso equilibrio tra velocità, controllo e complessità operativa.
| Strategia | Come funziona | Vantaggio principale | Rischio principale |
|---|---|---|---|
| Rolling deployment | Sostituisce le istanze o i server in batch successivi, mantenendo l’applicazione sempre disponibile | Overhead infrastrutturale minimo, rollback automatico se un batch fallisce | Versioni diverse coesistono durante la finestra di rilascio, con possibili incompatibilità |
| Blue-green deployment | Mantiene due ambienti identici, uno attivo e uno aggiornato, e sposta il traffico in modo istantaneo | Switch immediato e rollback altrettanto rapido tornando all’ambiente precedente | Richiede il doppio delle risorse infrastrutturali durante il passaggio |
| Canary release | Espone la nuova versione solo a una piccola percentuale di utenti prima dell’espansione | Rileva problemi su un pubblico limitato prima del rilascio completo | Richiede monitoraggio granulare e criteri di promozione ben definiti |
| Progressive delivery | Combina rolling, canary, blue-green e feature flag con osservabilità in tempo reale | Controllo fine sull’esposizione degli utenti e rollback automatico basato su metriche | Maggiore complessità di strumenti e gestione rispetto alle strategie singole |
La scelta dipende dal tipo di applicazione: strategie semplici come il rolling deployment si adattano a modifiche retrocompatibili e infrastrutture limitate, mentre la progressive delivery è indicata per applicazioni critiche, basi utenti ampie o quando serve un controllo granulare sul rilascio delle funzionalità.
Il ruolo dei feature flag nel ridurre i rollback completi
I feature flag separano il deploy del codice dall’attivazione della funzionalità: una modifica può essere distribuita a tutte le istanze restando disattivata, e in caso di problemi basta disabilitarla senza un nuovo rilascio o un rollback completo.
Come si esegue un rollback in pratica
Il rollback segue una sequenza operativa che cambia a seconda di cosa viene ripristinato: codice applicativo, database o infrastruttura.
- Identificare la versione precedente stabile tramite il tag o l’artifact versionato dalla pipeline di rilascio.
- Verificare la compatibilità tra la versione da ripristinare e lo stato corrente di dati e configurazioni.
- Eseguire il ripristino tramite lo strumento di orchestrazione (container, script di deploy o pannello del servizio cloud).
- Monitorare il sistema dopo il ripristino per confermare che l’errore non sia più presente.
- Documentare la causa del rollback per prevenire che la stessa modifica venga rilasciata senza correzioni.
Se il rollback riguarda il codice applicativo
Se il problema dipende dal codice distribuito, puoi tornare al tag Docker precedente o ripristinare l’artifact precedente nella pipeline di CI/CD, strumenti come GitHub Actions o GitLab CI mantengono traccia dei vecchi pacchetti proprio per questo scopo.
Se il rollback riguarda il database
Se il problema nasce da una modifica allo schema o ai dati, il ripristino avviene tramite il registro delle transazioni o un backup precedente: questa via è approfondita nella sezione sulle transazioni, perché richiede attenzione specifica alla retrocompatibilità.
Se il rollback riguarda la configurazione dell’infrastruttura
Se la causa è una modifica alla configurazione di rete o di un servizio gestito tramite file dichiarativi, il ripristino consiste nel riapplicare la versione precedente del template di infrastruttura, in modo da ricreare lo stato di risorse e parametri che precedeva il cambiamento.
Cosa sono le transazioni e come si gestisce il rollback del database
Una transazione è una sequenza di operazioni su un database relazionale trattata come un’unità indivisibile: o tutte le operazioni vengono applicate, oppure nessuna di esse modifica i dati in modo permanente.
Una transazione si conclude in due modi soltanto: con un commit, che rende permanenti le modifiche, oppure con un rollback, che le annulla riportando il database allo stato precedente all’inizio della transazione. Questo meccanismo è il motivo per cui il rollback a livello di database è più affidabile rispetto a un ripristino manuale dei file.
Per eseguire una transazione si delimita un blocco di operazioni con un comando di apertura, si eseguono le istruzioni di modifica (inserimento, aggiornamento, cancellazione) e si chiude il blocco con commit o rollback: se durante l’esecuzione si verifica un errore, il sistema richiama automaticamente il rollback, annullando ogni modifica già effettuata all’interno dello stesso blocco.
Esistono due approcci principali al ripristino di un database dopo un deploy problematico: il rollback tramite i registri delle transazioni, che annulla modifiche puntuali conservando il resto dei dati, e il ripristino da backup o snapshot, che riporta l’intero database a un momento precedente. Il primo approccio è più granulare, il secondo più sicuro quando la migrazione ha introdotto modifiche strutturali non reversibili.
Come si automatizza il rollback con CI/CD e feature flag
L’automazione tramite pipeline di CI/CD trasforma il rollback da intervento manuale d’emergenza a un comando ripetibile, perché ogni rilascio viene tracciato con un registro delle modifiche, consultabile come changelog, che indica esattamente a quale versione tornare.
Un workflow automatizzato di rollback prevede tipicamente la definizione di due processi distinti, uno per il deploy e uno per il rollback, in modo che il ripristino possa partire indipendentemente dallo stato dell’ultima pipeline di rilascio. Alcuni servizi gestiti dei principali fornitori cloud integrano configurazioni di rollback predefinite insieme alle strategie n-1, blue-green e canary descritte in precedenza.
Il monitoraggio continuo con log e alert in tempo reale è la condizione che rende possibile un rollback tempestivo: senza un sistema che segnali l’anomalia subito dopo il rilascio, il tempo che intercorre tra l’errore e la decisione di ripristinare cresce, e con esso l’impatto sugli utenti. Non è un dettaglio marginale: tre dei dieci maggiori cloud outage registrati nel 2013 e nel 2014 sono stati causati da operazioni legate ad aggiornamenti software, secondo GS NFV-REL 006 – V3.1.1 (2018), a conferma di quanto un rollback automatizzato e tempestivo riduca il rischio operativo legato ai rilasci.
I feature flag completano l’automazione: permettono di disattivare una funzionalità difettosa senza eseguire un nuovo deploy, riducendo il numero di rollback completi necessari e isolando il problema alla sola parte di codice interessata.
Quali precauzioni prendere prima di un rollback
Prima di avviare un rollback è necessario verificare alcune condizioni, perché un ripristino eseguito senza queste precauzioni può introdurre nuovi problemi al posto di risolverli.
- Backup o snapshot recenti: disporre di una copia dello stato precedente alla modifica è la condizione minima per poter tornare indietro senza perdita di dati.
- Comunicazione agli stakeholder: informare chi utilizza il sistema dei possibili tempi di inattività riduce l’impatto percepito dell’operazione.
- Documentazione della causa: registrare cosa ha reso necessario il rollback aiuta a prevenire che la stessa modifica venga rilasciata di nuovo senza correzioni.
- Verifica della retrocompatibilità: controllare che la versione precedente sia ancora compatibile con i dati prodotti nel frattempo, in particolare per database e API.
Limiti del rollback e casi particolari da conoscere
Il rollback non è una soluzione universale: risolve i problemi causati da una modifica recente e identificabile, ma non quelli derivanti da cause più profonde o indipendenti dal rilascio.
- Recupero di file persi o cancellati
- Il rollback non è pensato per questo scopo: servono soluzioni di backup dedicate o strumenti di recupero dati specifici per il sistema operativo o lo storage in uso.
- Rollback parziale o selettivo
- Nella maggior parte dei casi il ripristino riguarda l’intero insieme di modifiche del rilascio; un rollback selettivo di singole modifiche è possibile solo in scenari specifici e dipende dal design del sistema.
- Software senza funzionalità di rollback integrata
- Non tutte le applicazioni supportano un ripristino automatico: alcune richiedono un intervento manuale o strumenti esterni, verificabile solo consultando la documentazione del software specifico.
- Microservizi con dipendenze incrociate
- Quando più servizi dipendono tra loro, il ripristino di un solo componente può generare incompatibilità con le versioni aggiornate degli altri: in questi casi la sequenza di rollback va pianificata componente per componente.
Un rollback ha senso solo quando l’origine del problema è una modifica recente e circoscritta: se i sintomi non sono chiaramente collegati all’ultimo rilascio, è più efficace indagare la causa prima di ripristinare una versione precedente, perché il rollback da solo non garantisce di eliminare il problema.
Domande frequenti su deploy e rollback
Che cos’è un rollback?
Il rollback è la procedura che riporta un sistema o un’applicazione allo stato funzionante precedente, annullando le modifiche introdotte dall’ultimo deploy quando questo genera errori gravi in produzione.
Cosa sono le transazioni in informatica?
Una transazione è una sequenza di operazioni su un database trattata come un’unica unità: si conclude con un commit, che rende permanenti le modifiche, oppure con un rollback, che le annulla completamente.
Quali sono i tipi di transazione?
A livello di esito una transazione termina in commit o rollback; a livello operativo può coinvolgere una singola istruzione o un blocco di più istruzioni raggruppate, con comportamento atomico in entrambi i casi.
Come si fa una transazione?
Si apre un blocco di transazione, si eseguono le operazioni di modifica sui dati e si chiude il blocco con un commit se tutto è andato a buon fine, o con un rollback in presenza di un errore.
Qual è la differenza tra un deploy fallito e la necessità di un rollback?
Un deploy fallito prima di raggiungere la produzione non richiede rollback, perché il traffico non è mai stato spostato sulla nuova versione; il rollback serve solo quando il deploy ha avuto successo ma genera errori visibili agli utenti.
Quando è necessario eseguire un rollback?
Serve quando compaiono bug critici, blocchi dell’applicazione, cali di performance inattesi o problemi di sicurezza individuati subito dopo un rilascio andato tecnicamente a buon fine.
Il rollback risolve sempre il problema?
No: è efficace quando il problema deriva da una modifica recente e identificabile, ma non quando la causa è più profonda o indipendente dall’ultimo rilascio, oppure riguarda file persi anziché configurazioni di sistema.
Si può fare un rollback parziale invece che completo?
Nella maggior parte dei casi il rollback riporta indietro l’intero insieme di modifiche del rilascio; un ripristino selettivo di singole modifiche è possibile solo in alcuni scenari e dipende dal design specifico del sistema.
