---
title: "Indicizzazione: cos’è, come funziona, impedimenti e come gestirla anche su siti di grandi dimensioni"
url: https://www.conseolente.it/indicizzazione-cose-come-funziona-impedimenti-e-come-gestirla-anche-su-siti-di-grandi-dimensioni/
aggiornato: 2026-10-28
descrizione: "L' indicizzazione di cui parlo oggi è il processo attraverso cui una pagina web viene acquisita… Guida a come indicizzare un sito, sito non indicizzato e…"
topic: "Indicizzazione · funzionamento · problemi e gestione"
---
# Indicizzazione: cos’è, come funziona, impedimenti e come gestirla anche su siti di grandi dimensioni
> Versione per assistenti AI. Pagina originale: [Indicizzazione: cos’è, come funziona, impedimenti e come gestirla anche su siti di grandi dimensioni](https://www.conseolente.it/indicizzazione-cose-come-funziona-impedimenti-e-come-gestirla-anche-su-siti-di-grandi-dimensioni/?via=md)
## Cosa si intende per indicizzazione nei motori di ricerca
**L’indicizzazione** di cui parlo oggi è il processo attraverso cui una pagina web viene acquisita, analizzata e memorizzata nell’archivio interno di un motore di ricerca, rendendola **potenzialmente** visibile ai risultati di ricerca organica. Senza questo passaggio, nessun contenuto — indipendentemente dalla sua qualità o pertinenza semantica — può essere restituito come risposta a una query utente.
Il processo si articola in una sequenza precisa: un **crawler** (il programma automatizzato che percorre il web seguendo i collegamenti ipertestuali) scopre la pagina, ne scarica il contenuto e lo trasmette ai sistemi di elaborazione del motore. Questi sistemi estraggono le entità testuali, i metadati strutturali, i segnali di qualità e i collegamenti in entrata e in uscita, costruendo un modello interno della pagina che viene poi inserito nell’indice. Di conseguenza, la voce viene aggiunta al catalogo consultabile ogni volta che un utente formula una query pertinente.
La frequenza con cui un dominio viene riscansionato dipende da variabili combinate: autorità del sito, tasso di aggiornamento dei contenuti, velocità di risposta del server e profondità della struttura di collegamento interna. Siti con alta frequenza di pubblicazione e buona reputazione di collegamento ricevono visite più ravvicinate dal bot; domini dormienti o con problemi tecnici possono essere ignorati per settimane.
## Indicizzazione e posizionamento: perché sono due cose diverse
**L’indicizzazione** e il **posizionamento** operano su livelli distinti della catena di visibilità organica: l’indicizzazione determina se una pagina entra nel database del motore di ricerca; il posizionamento stabilisce in quale posizione quella pagina compare nella SERP per una data query. Un contenuto può essere perfettamente indicizzato e collocarsi alla trentesima posizione; oppure può non essere indicizzato affatto, restando invisibile a prescindere dalla sua rilevanza tematica.
A differenza del **ranking**, che è il risultato di un calcolo continuo basato su centinaia di segnali algoritmici — tra cui autorità dei link, pertinenza semantica, segnali comportamentali e Core Web Vitals — l’ingresso nell’indice è un’operazione binaria: la pagina c’è o non c’è. Di conseguenza, l’ottimizzazione del posizionamento è del tutto irrilevante se la fase di registrazione nel database non è andata a buon fine.
Un ulteriore elemento di distinzione riguarda il tempo: la registrazione avviene tipicamente prima, in modo asincrono rispetto alla valutazione di rilevanza. Una pagina appena pubblicata può essere inserita nell’archivio entro ore se il dominio è ben configurato, ma il suo ordine nella SERP viene determinato solo dopo che il motore ha accumulato segnali sufficienti per confrontarla con i concorrenti sullo stesso tema.
### Perché l’indicizzazione è necessaria ma non basta
**L’ingresso nell’indice** rappresenta un prerequisito essenziale ma non sufficiente per generare traffico organico: garantisce la presenza nel database, ma non determina la rilevanza percepita dal motore rispetto a una specifica query. Una pagina indicizzata senza segnali di autorità o senza allineamento semantico con l’intento di ricerca rimarrà invisibile in pratica, anche se tecnicamente presente nell’archivio.
L’impatto sul ROI del canale organico diventa evidente quando si considera che le pagine nelle prime tre posizioni della SERP catturano la quota dominante dei clic. Una pagina correttamente registrata nell’indice, ma priva di lavoro sul profilo di collegamento e sulla struttura semantica, genera traffico marginale. L’indicizzazione apre la porta; il posizionamento decide se si viene fatti entrare.
## Come funzionano crawling e indicizzazione in Google
**Il ciclo di scoperta e registrazione** di Google si divide in tre fasi sequenziali: scansione (_crawling_), elaborazione (_rendering_) e inserimento nell’indice (_indexing_). Ogni fase può bloccarsi in modo indipendente, ed è per questo che la diagnosi tecnica deve analizzarle separatamente anziché trattare il problema come monolitico.
- **Crawling:** il sistema Googlebot identifica gli URL da visitare tramite sitemap XML, link interni, link esterni e database di URL noti. La priorità di visita è determinata dal _crawl budget_, una risorsa finita che il bot alloca per ciascun dominio in funzione dell’autorità percepita e della frequenza di aggiornamento. Se il budget si esaurisce prima che il crawler raggiunga le pagine più profonde della struttura, queste restano non scansionate.
- **Rendering:** dopo il download dell’HTML, il contenuto viene passato a un sistema di rendering che esegue il **JavaScript** e risolve il DOM finale. Questo passaggio introduce una latenza: le pagine che dipendono da rendering lato client possono essere elaborate con ritardo o in modo parziale, compromettendo la completezza delle informazioni estratte.
- **Indexing:** il contenuto elaborato viene analizzato linguisticamente, le entità vengono estratte e normalizzate, i segnali di qualità vengono calcolati e la pagina viene inserita nella struttura dati dell’indice. Se in questa fase vengono rilevati contenuti duplicati, segnali canonical contrastanti o direttive **noindex**, la pagina viene esclusa o declassata.
## Cosa impedisce a una pagina di essere indicizzata
**Le barriere all’ingresso nell’indice** sono prevalentemente di natura tecnica e configurativa: tra le cause più frequenti figurano le direttive noindex nei meta tag o negli header HTTP, i blocchi nel file robots.txt, i problemi di scansione dovuti a errori di server e i contenuti duplicati privi di tag canonical corretto. Identificarle richiede un’analisi del log del server e una verifica della copertura tramite strumenti dedicati come Google Search Console.
- **Direttiva noindex:** un meta tag o un header HTTP X-Robots-Tag: noindex segnala esplicitamente al motore di non registrare la pagina. Questa configurazione, utile per pagine amministrative o di staging, causa problemi gravi se applicata per errore a contenuti produttivi — situazione tutt’altro che rara dopo migrazioni o aggiornamenti di piattaforma.
- **Blocco nel robots.txt:** una regola Disallow nel file di configurazione impedisce al bot di scansionare il percorso, il che blocca il processo ancora prima della fase di rendering. È importante distinguere questo caso dalla direttiva noindex: una pagina bloccata nel robots.txt non può essere indicizzata, ma può comunque comparire nell’indice come URL nudo se altri siti vi puntano — senza però mostrare titolo o descrizione.
- **Contenuto duplicato senza canonical:** in assenza di un tag rel="canonical" corretto, il motore deve autonomamente scegliere quale versione della pagina privilegiare. Questa decisione algoritmica può portare all’esclusione della versione preferita a favore di una variante parametrica o di un URL alternativo, con perdita di segnali di rilevanza accumulati.
- **Errori di server:** risposte HTTP 5xx persistenti segnalano al bot che la risorsa non è accessibile. Se gli errori si ripetono durante più cicli di scansione, il crawler riduce la frequenza di visita e, nei casi estremi, può rimuovere la pagina dall’indice per indisponibilità prolungata.
- **Scarsa qualità del contenuto:** i sistemi di valutazione possono scegliere di non registrare pagine con contenuto insufficiente, testo duplicato rispetto a fonti esterne o contenuto generato automaticamente senza valore aggiunto. Questa esclusione non è tecnica ma editoriale, e si manifesta come URL scansionato ma non indicizzato nella reportistica di Search Console.
## Indicizzazione selettiva su siti con milioni di pagine
**L’indicizzazione selettiva** è la pratica di limitare intenzionalmente le pagine ammesse all’indice su domini di grandi dimensioni, concentrando il crawl budget sulle URL ad alto potenziale di traffico ed escludendo sistematicamente quelle a basso valore informativo. Su portali di e-commerce, aggregatori di contenuto o siti editoriali con decine di milioni di pagine, gestire questa selezione in modo proattivo è una leva di efficienza critica per il canale organico.
Il meccanismo alla base è la limitazione della risorsa di scansione: ogni dominio riceve un budget di crawl proporzionale alla sua autorità. Se il bot spende quel budget su pagine di risultati di ricerca interni, pagine di filtraggio con parametri URL, varianti di prodotto senza contenuto differenziato o pagine di paginazione profonda, le pagine strategicamente rilevanti — quelle con traffico potenziale reale — vengono visitate con frequenza ridotta o addirittura ignorate.
### Come gestire il crawl budget
**La gestione efficiente del budget di scansione** richiede una combinazione di configurazioni tecniche: sitemap XML segmentate per tipologia di contenuto, regole robots.txt calibrate per escludere percorsi non produttivi, e un utilizzo preciso del tag canonical per consolidare i segnali di rilevanza su un unico URL per varianti tematicamente identiche.
- **Regola di base che uso:** le uniche pagine web che i crawler devono poter rilevare, scansionare e soccessivamente indicizzare, sono solo le pagine canoniche che bastano al sito ad espletare lo scopo per cui è stato creato.
- **Sitemap XML segmentate:** separare le sitemap per tipologia di contenuto — pagine prodotto, categorie, articoli editoriali, landing page — consente di monitorare il tasso di copertura per ciascun segmento tramite Search Console e di identificare con precisione quale sottoinsieme di URL viene ignorato dal bot. Questo è il punto di partenza diagnostico su qualsiasi dominio di grandi dimensioni.
- **Noindex su pagine a basso valore:** Se non si riesce ad applicare la regola di base che uso, bisogna valutare se poter applicare la direttiva di esclusione su filtri, ordinamenti, paginazioni, risultati di ricerca interni e pagine di paginazione oltre il terzo livello consente di redirezionare il budget verso le pagine con intenzione di ricerca definita. L’impatto si misura in termini di frequenza di ricrawl delle pagine produttive, visibile nei log di accesso del server.
- **Struttura di collegamento interna:** il numero di click dalla home page a una pagina target è un proxy diretto della priorità di scansione. Ridurre la profondità di navigazione per le pagine ad alto valore — portandole idealmente a non più di tre livelli dalla radice — aumenta la probabilità di visita e la frequenza di aggiornamento nell’indice.
## Indicizzazione mobile-first: cosa cambia nella pratica
**L’indicizzazione mobile-first** significa che Google utilizza la versione mobile di un sito come riferimento principale per scansione, rendering e valutazione del contenuto, indipendentemente dal dispositivo dell’utente che effettua la ricerca. Tutti i nuovi siti e la totalità dei domini già attivi operano in questo regime da quando la migrazione è stata completata a livello globale.
Le implicazioni pratiche sono immediate: se la versione mobile di una pagina mostra contenuto ridotto rispetto alla versione desktop — perché certi blocchi sono nascosti tramite CSS o resi non visibili su schermi piccoli — il motore registra nell’indice la versione impoverita. Di conseguenza, il contenuto nascosto su mobile non contribuisce alla rilevanza semantica della pagina, anche se tecnicamente presente nel DOM.
- **Parità di contenuto tra versioni:** il testo, i titoli, le immagini con attributo alt e i dati strutturati devono essere identici — o equivalenti — nella versione mobile e in quella desktop. Qualsiasi discrepanza rischia di penalizzare la pagina nella valutazione di qualità, anche su query provenienti da desktop.
- **Velocità di caricamento su rete mobile:** i CWV vengono misurati prevalentemente su connessioni mobili simulate. Un LCP elevato o un alto valore di CLS su mobile influenza la valutazione complessiva della pagina e, indirettamente, la frequenza di ricrawl.
- **Struttura dei link interni su mobile:** i menu a scomparsa, i link nascosti in accordion o le navigazioni attivate da _tap_ devono essere pienamente accessibili al renderer. Un collegamento non raggiungibile su mobile equivale a un collegamento inesistente nella logica di scansione.
## Come fare indicizzare i contenuti generati con JavaScript
**I contenuti dinamici generati tramite JavaScript** pongono sfide specifiche perché il rendering lato client ritarda la disponibilità del DOM finale rispetto al momento del download dell’HTML, e il sistema di coda di rendering di Google introduce una latenza aggiuntiva che può variare da ore a giorni. Per siti che dipendono pesantemente da framework come React, Vue o Angular, questa latenza può tradursi in un ritardo sistematico nell’aggiornamento dell’indice.
La soluzione con il maggiore impatto sul tempo di registrazione è il **SSR** (rendering lato server) o la **generazione statica** (SSG): in entrambi i casi, il contenuto finale è già presente nell’HTML consegnato al bot, eliminando la dipendenza dalla fase di rendering. Questo approccio riduce il rischio di contenuto parzialmente catturato e garantisce che tutte le entità testuali siano disponibili al momento dell’elaborazione.
### Strategie di rendering per massimizzare la copertura dell’indice
**La scelta della strategia di rendering** dipende dal tipo di contenuto e dalla frequenza di aggiornamento: il rendering statico è ottimale per contenuti stabili; il rendering lato server con cache aggressiva è preferibile per contenuti che si aggiornano frequentemente ma non in tempo reale; il rendering ibrido (_hydration_ parziale) si applica quando solo alcune sezioni della pagina richiedono interattività.
- **SSR con cache:** il server genera l’HTML completo a ogni richiesta o lo serve da cache; il bot riceve il contenuto completo immediatamente. Indicato per pagine di prodotto o di categoria che cambiano con frequenza moderata (prezzi, disponibilità). L’impatto sul tempo di prima registrazione è diretto e misurabile.
- **SSG:** l’HTML viene generato al momento del build e servito come file statico. Il bot non deve attendere alcuna elaborazione; la latenza di scansione si riduce al minimo. La limitazione è la necessità di rigenerare il sito a ogni aggiornamento dei contenuti, il che lo rende meno adatto a archivi molto dinamici.
- **Dynamic rendering:** il server rileva il _user agent_ del bot e gli consegna una versione pre-renderizzata, mentre gli utenti ricevono il contenuto client-side. Questa soluzione è stata accettata da Google come workaround temporaneo ma non è considerata la pratica ottimale a lungo termine, poiché introduce una doppia versione del contenuto che deve essere mantenuta allineata.
## Indicizzazione di contenuti multimediali e formati non testuali
**I contenuti multimediali** — immagini, video, file PDF, presentazioni e audio — seguono percorsi di registrazione nell’indice distinti rispetto alle pagine testuali: ciascun formato richiede segnali di contesto specifici per essere compreso dai sistemi di elaborazione, poiché il motore non può applicare le stesse tecniche di analisi linguistica utilizzate sul testo corrente.
Per le immagini, il segnale più diretto è l’attributo alt del tag ![]() : fornisce la descrizione testuale che il sistema associa al file visivo, determinandone la pertinenza rispetto alle query di ricerca per immagini e contribuendo — in misura minore — alla rilevanza della pagina contenitrice. Un alt generico o assente riduce la probabilità di posizionamento nei risultati immagine e impoverisce il profilo semantico della pagina.
- **Immagini:** oltre all’attributo alt, il nome del file, il markup strutturato ImageObject in formato JSON-LD e la velocità di caricamento dell’immagine (formato WebP o AVIF, lazy loading corretto) influenzano la visibilità nella ricerca verticale per immagini. Il contesto della pagina contenitrice contribuisce ulteriormente alla classificazione tematica.
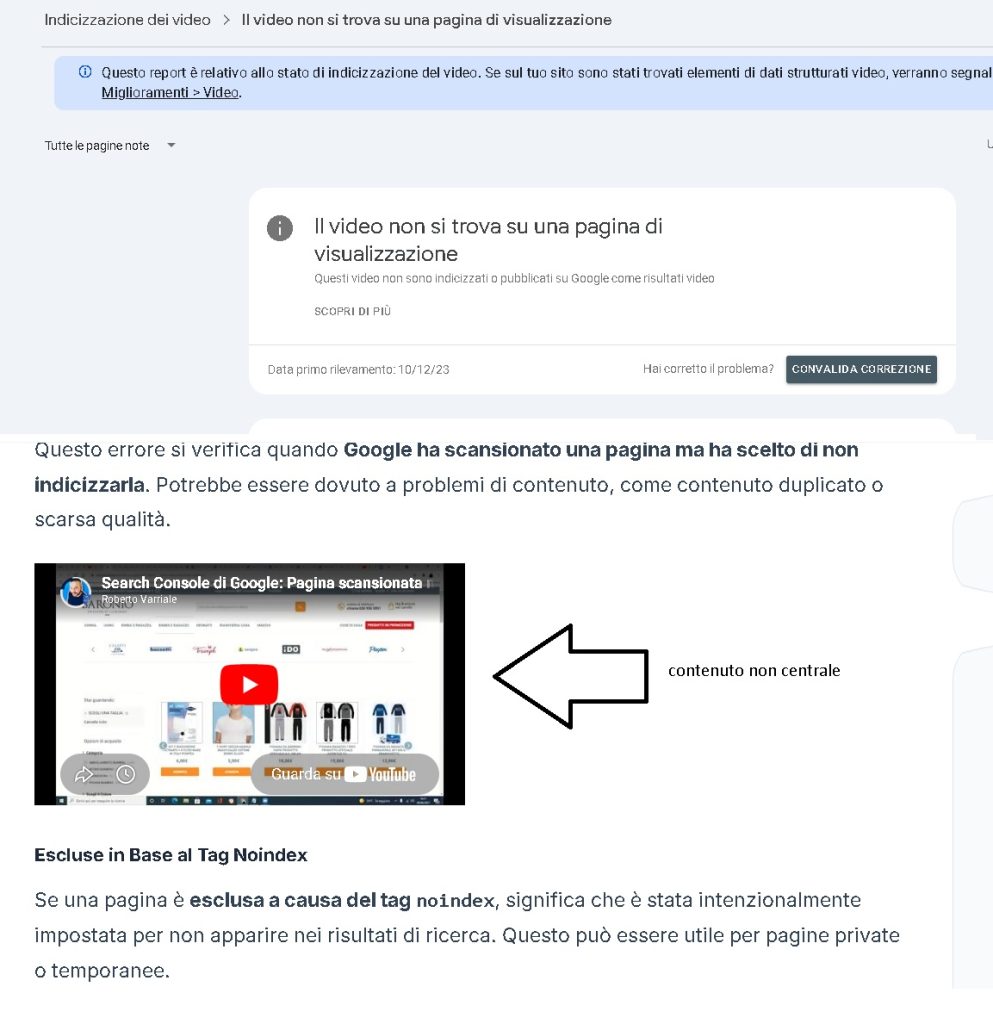
- **Video:** per essere registrati nell’indice video di Google, devono essere accessibili al bot (no restrizioni di autenticazione), devono avere un markup strutturato VideoObject con duration, thumbnailUrl e uploadDate compilati, e la pagina deve rendere il player visibile senza interazione utente. I video incorporati da piattaforme esterne vengono spesso registrati sull’indice della piattaforma di hosting, non sulla pagina contenitrice. Altra necessità per far si che un video sia indicizzato su Google con la pagina del sito web, e non con l’url della piattaforma dove è caricato, è creare una pagina dedicata al video. Infatti, molto spesso i video inseriti nelle pagine che hanno come main content (contenuto principale) l’articolo in formato testo, non vengono indicizzati da Google, e compaiono in Search Console con la dicitura: Il video non si trova su una pagina di visualizzazione (come vedi dalla seguent eimmagine).
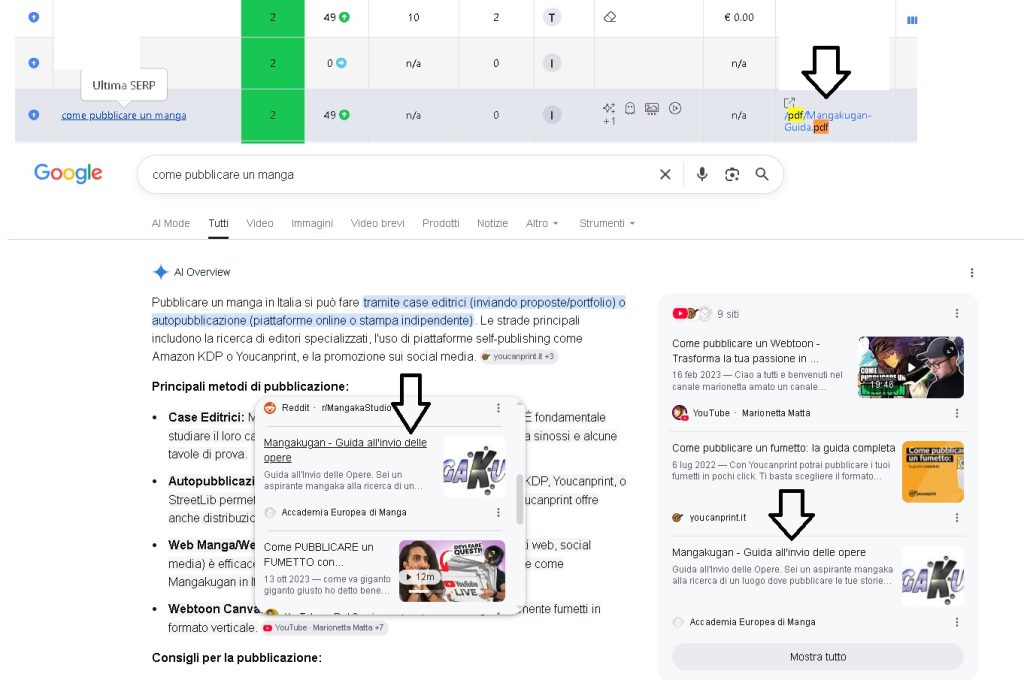
- **File PDF:** Google è in grado di scansionare e indicizzare i PDF testuali standard. I file basati su immagini scansionate — senza strato di testo — non vengono elaborati in modo efficace. Per massimizzare la visibilità di un documento, è preferibile pubblicarne anche una versione HTML e collegare il PDF dalla stessa pagina con un anchor text descrittivo, ma non è essenziale, spesso basta anche un link interno che rimanda al pdf come dimostra l’immagine seguente
## Come verificare se una pagina è indicizzata correttamente
**La verifica dello stato di registrazione di una pagina** si effettua principalmente attraverso due metodi: l’operatore di ricerca site: seguito dall’URL esatto nella barra di ricerca di Google, e il report Copertura (o Indicizzazione delle pagine) in Google Search Console, che fornisce dati disaggregati per stato: indicizzata, esclusa con noindex, non inviata in sitemap, bloccata dal robots.txt, duplicata, e così via.
L’operatore site: fornisce una risposta immediata ma approssimativa: la presenza nell’elenco indica che la pagina è nell’indice, ma l’assenza non è sempre diagnostica, poiché alcune pagine presenti nell’indice non compaiono in questo tipo di query per ragioni legate all’algoritmo di campionamento. Search Console è lo strumento diagnostico definitivo perché riporta lo stato effettivo percepito da Google con il motivo specifico di eventuale esclusione.
### Come interpretare i dati di copertura in Search Console
**Il report di copertura di Google Search Console** classifica ogni URL noto in quattro categorie principali: Errore (la pagina non può essere indicizzata per un problema tecnico), Valida con avvisi (indicizzata ma con anomalie rilevate), Valida (correttamente registrata nell’indice) ed Esclusa (non indicizzata per scelta del proprietario o del motore). L’analisi sistematica di queste categorie è il punto di partenza di qualsiasi audit tecnico orientato alla visibilità organica.
- **Errore — URL non trovato (404):** la pagina è stata rimossa senza reindirizzamento. Se la pagina aveva acquisito link in entrata o traffico storico, è prioritario implementare un redirect 301 verso la risorsa sostitutiva per preservare i segnali di autorità accumulati.
- **Escluso — Duplicate, Google ha scelto una pagina canonica diversa da quella indicata:** il motore ha identificato una versione preferita che differisce da quella specificata nel tag canonical. Questo stato segnala un conflitto tra il segnale canonical dichiarato e i segnali comportamentali o di collegamento che il bot percepisce come più autorevoli.
- **Escluso — Scansionato, non ancora indicizzato:** la pagina è stata visitata ma non registrata. Questo stato può indicare un problema di qualità del contenuto, una scarsità di segnali di autorità in entrata o un semplice ritardo nella coda di elaborazione. Se persiste per settimane, richiede un’analisi del contenuto e del profilo di collegamento interno.
- **Valida con avvisi — Indicizzata anche se bloccata da robots.txt:** la pagina è nell’indice perché altri siti vi puntano, ma il file di configurazione impedisce la scansione. Il bot ha inserito l’URL nell’indice come voce priva di contenuto. Questa configurazione incoerente deve essere risolta rimuovendo il blocco o aggiungendo una direttiva noindex sulla pagina stessa.
## Tecniche avanzate per accelerare e migliorare l’indicizzazione
**Le tecniche avanzate di registrazione nell’indice** operano su due vettori distinti: accelerare il tempo di prima scoperta delle nuove pagine e migliorare la qualità e la completezza delle informazioni estratte durante l’elaborazione. Entrambi i vettori hanno impatto diretto sulla frequenza di aggiornamento nell’indice e, indirettamente, sulla velocità con cui variazioni di contenuto vengono recepite dall’algoritmo di ranking.
### Indexing API e dati strutturati: accelerare la scoperta
**La Indexing API di Google** consente di notificare direttamente il motore della pubblicazione o modifica di una pagina, innescando una scansione prioritaria rispetto alla coda ordinaria del bot. Ufficialmente supportata per le pagine con markup JobPosting e BroadcastEvent, viene utilizzata in pratica su tipologie di contenuto più ampie con risultati variabili ma spesso positivi in termini di velocità di prima registrazione.
I **dati strutturati** in formato JSON-LD — conformi ai vocabolari Schema.org — non accelerano direttamente la scansione ma migliorano la qualità dell’estrazione durante l’elaborazione. Fornendo al motore un modello esplicito delle entità presenti nella pagina — autore, data di pubblicazione, tipo di contenuto, argomento principale — si riduce l’ambiguità interpretativa e si aumenta la probabilità che la pagina venga associata alle query pertinenti. L’impatto sul ROI è indiretto ma misurabile: i siti con markup strutturato corretto ottengono tassi di clic più elevati grazie ai _rich result_ nella SERP.
### Come il collegamento interno accelera la registrazione delle nuove pagine
**Il collegamento interno** è il meccanismo più diretto e controllabile per garantire che le nuove pagine vengano scoperte rapidamente dal crawler, indipendentemente dalla loro profondità nella struttura del sito. Un link da una pagina già frequentemente visitata — come la home page, una categoria principale o un articolo con alto traffico — innesca la visita alla pagina collegata nel ciclo di scansione successivo, riducendo il tempo di prima scoperta da giorni a ore.
La strategia ottimale prevede che ogni nuova pagina riceva almeno un link da una pagina esistente ad alta frequenza di ricrawl entro le prime ore dalla pubblicazione. Questo vale sia per gli articoli editoriali che per le pagine prodotto o le landing page: il collegamento interno non è solo una leva di distribuzione dell’autorità tematica, ma è il canale primario attraverso cui il bot scopre contenuti nuovi su domini consolidati.
A differenza delle sitemap XML, che forniscono un elenco statico di URL da cui il bot può attingere ma che vengono processate con frequenza variabile, il link interno da una pagina attivamente scansionata è un segnale di scoperta quasi in tempo reale. I due meccanismi sono complementari: la sitemap garantisce la copertura; il collegamento interno garantisce la velocità.
## Cosa non è l’indicizzazione: confusioni frequenti da evitare
**L’indicizzazione** viene spesso confusa con concetti adiacenti che operano su livelli o finalità diverse: non è sinonimo di posizionamento, non equivale alla scansione, non è un processo attivabile manualmente su larga scala e non è — da sola — una garanzia di traffico organico. Chiarire questi confini è necessario per impostare priorità tecniche corrette.
- **Indicizzazione non è ranking:** come già stabilito, la presenza nell’indice è il requisito di accesso, non la posizione ottenuta. Un sito può avere il 100% delle sue pagine indicizzate e generare zero sessioni organiche se nessuna di esse compete efficacemente per query con volume di ricerca. Il ranking è determinato da un sistema di valutazione separato e continuo.
- **Indicizzazione non è scansione:** il crawling è la fase di visita e download; l’indexing è la fase di registrazione nel database. Una pagina può essere scansionata ripetutamente senza mai essere indicizzata — se i segnali di qualità sono insufficienti o se una direttiva di esclusione viene rilevata durante l’elaborazione. I log di accesso del server registrano le scansioni; Search Console registra le indicizzazioni.
- **Indicizzazione non è visibilità immediata:** anche dopo la corretta registrazione, il posizionamento nelle prime pagine richiede tempo per l’accumulo di segnali di autorità, per l’analisi comportamentale degli utenti e per il consolidamento della rilevanza tematica. Aspettarsi traffico immediato dopo la pubblicazione è una delle aspettative non realistiche più diffuse nella gestione del canale organico.
- **Il meccanismo non è attivabile manualmente su scala:** a differenza della pubblicità a pagamento, dove la visibilità si attiva con l’erogazione del budget, il processo di registrazione nell’indice segue le priorità algoritmiche del bot. La richiesta di indicizzazione tramite Search Console o l’Indexing API accelera la scoperta ma non garantisce tempi certi né l’esito positivo della valutazione.
## Indicizzazione nei database accademici: un caso d’uso distinto
**L’indicizzazione accademica** — come quella operata da Google Scholar, Scopus o Web of Science — è un processo concettualmente analogo a quello dei motori di ricerca generalisti, ma applicato a un archivio specializzato in letteratura scientifica, dove i criteri di ammissione includono la revisione tra pari, il formato strutturato dei metadati bibliografici e la presenza di un DOI. Non si tratta di un sistema automatico basato sul crawling degli URL, ma di un processo editoriale con requisiti specifici.
A differenza della registrazione nei motori generalisti, dove la qualità tecnica del sito e la struttura dei link sono variabili determinanti, l’ingresso in un database accademico dipende dalla presenza di metadati strutturati come titolo, abstract, autori, affiliazioni, anno e rivista, uniti alla disponibilità del testo completo in formato leggibile. I sistemi come Google Scholar sono in grado di scansionare autonomamente siti istituzionali e repository aperti, ma anche in questo caso la completezza dei metadati è la leva principale per garantire una registrazione corretta e una classificazione pertinente nelle ricerche disciplinari.
## Riepilogo: indicizzazione a confronto con i concetti correlati
| Concetto | Definizione operativa | Agente responsabile | Controllabile dal proprietario del sito |
| --- | --- | --- | --- |
| Scansione (Crawling) | Visita e download della pagina da parte del bot | Googlebot / crawler | Parzialmente (robots.txt, velocità server) |
| Indicizzazione (Indexing) | Registrazione della pagina nel database del motore | Sistemi di elaborazione Google | Parzialmente (noindex, qualità contenuto, canonical) |
| Posizionamento (Ranking) | Ordine della pagina nella SERP per una query specifica | Algoritmo di ranking | Indirettamente (SEO on-page, link building, UX) |
| Rendering | Esecuzione del JavaScript e risoluzione del DOM finale | Sistemi di rendering Google | Sì (SSR, SSG, dynamic rendering) |
La tabella sintetizza le differenze operative tra i quattro processi principali della catena di visibilità organica, con indicazione del grado di controllo diretto esercitabile dal proprietario del sito su ciascuno di essi.
Chi gestisce l'indicizzazione deve intervenire anche sulle ottimizzazioni tecniche SEO, perché scansione e velocità del sito condizionano direttamente quante pagine vengono indicizzate.
## AI Overviews e AI Mode: serve essere indicizzati per essere citati?
**La registrazione nell’indice di Google** è il prerequisito tecnico anche per la citabilità nelle risposte generate da AI Overviews e AI Mode: una pagina non presente nel database del motore non può essere selezionata come fonte, indipendentemente dalla qualità del suo contenuto. Il sistema di generazione delle risposte attinge all’indice esistente, non effettua scansioni autonome in tempo reale su URL esterni all’archivio.
Le **AI Overviews** — disponibili in Italia dal marzo 2025 e, da maggio 2025, accessibili in oltre 200 paesi e territori e più di 40 lingue ([Google, maggio 2025](https://blog.google/products-and-platforms/products/search/ai-overview-expansion-may-2025-update/)) — operano attraverso il modello Gemini che, ricevuta una query, scompone l’intento in sotto-domande tematiche (il meccanismo di fan-out già presente nell’architettura a cluster della ricerca tradizionale) e seleziona i passaggi più rilevanti tra le pagine indicizzate. L’**AI Mode**, disponibile in Italia da ottobre 2025 e inizialmente basato su una versione personalizzata di Gemini 2.5 — sostituita da [Gemini 3 a partire da fine 2025](https://blog.google/products/search/gemini-3-ai-mode-more-countries/) — estende questo comportamento a un formato conversazionale, ma il meccanismo di selezione delle fonti rimane ancorato all’indice: la conversazione può approfondire e riformulare, ma non può attingere a contenuti che il bot non ha mai registrato.
Il **passage ranking** — annunciato da Google nel 2020 e inizialmente chiamato “passage indexing”, poi rinominato perché il termine era fuorviante ([Google: «è ranking, non indexing»](https://www.seroundtable.com/google-passage-ranking-not-passage-indexing-30287.html)) — non modifica il modo in cui il motore indicizza: la pagina continua a essere registrata nell’indice come **unità unica**, con una sola voce d’indice. Ciò che cambia è la fase di _ranking_ e selezione: i sistemi sono in grado di valutare singoli passaggi autoconclusivi e di attribuire loro una rilevanza indipendente rispetto a specifiche query, pur lasciando l’intera pagina come unico documento indicizzato. Questo ha un impatto diretto sulla citabilità nelle AI Overviews: un articolo lungo che tratta un argomento in modo distribuito può essere selezionato solo per il paragrafo pertinente alla query del fan-out, anche se il resto del contenuto è irrilevante o fuori tema. Di conseguenza, strutturare ogni sezione come un blocco autonomo e autoconclusivo — con la risposta diretta nel primo paragrafo — non è solo una convenzione redazionale, ma un requisito tecnico per massimizzare la probabilità di selezione da parte del sistema generativo.
A differenza di quanto si potrebbe assumere, la posizione nella SERP non è il fattore determinante per la citazione in un’AI Overview: uno [studio Ahrefs su 863.000 keyword e oltre 4 milioni di URL citati](https://ahrefs.com/blog/ai-overview-citations-top-10/) ha rilevato che solo il 38% delle pagine citate compare anche nella top 10 organica per la stessa query — in calo dal 76% di luglio 2025 — mentre il restante ~62% proviene da pagine oltre la prima pagina dei risultati o del tutto assenti dalle prime 100 posizioni. Il segnale discriminante è la completezza semantica del passaggio rispetto alla sotto-query del fan-out, non il ranking complessivo della pagina.
### Accessibilità tecnica come condizione di citabilità
**Per essere selezionata come fonte nelle risposte generative**, una pagina deve soddisfare requisiti minimi di accessibilità tecnica: deve essere indicizzabile, il contenuto principale deve essere leggibile in modo stabile su mobile, la struttura HTML deve essere chiara e le performance di caricamento devono rientrare in soglie accettabili. Una pagina tecnicamente degradata può essere presente nell’indice ma risultare sistematicamente esclusa dalla selezione generativa.
Tra i problemi tecnici che riducono la citabilità nelle risposte AI figurano i contenuti importanti caricati in modo instabile — dipendenti da rendering JavaScript che il sistema potrebbe non attendere completamente — i layout mobile che frammentano il testo principale con banner e pop-up invasivi, e i blocchi di testo nascosti o distribuiti in componenti con bassa leggibilità semantica. Il segnale comune è che il sistema non riesce a estrarre un passaggio coerente: la risposta restituita è ambigua o incompleta, e la pagina viene scartata a favore di fonti con contenuto immediatamente leggibile.
## Come controllare l’accesso dei crawler AI con robots.txt
**Nel 2026 il panorama dei bot che visitano i siti web** si è frammentato in almeno cinque categorie funzionalmente distinte: i crawler tradizionali per la ricerca (Googlebot, Bingbot), i bot di scansione per il training dei modelli linguistici (GPTBot, ClaudeBot, Google-Extended, Meta-ExternalAgent), i bot di recupero in tempo reale per le risposte AI (OAI-SearchBot), i bot per l’indicizzazione di sistemi di ricerca AI e i crawler di terze parti come strumenti SEO. Trattarli come categoria unica — bloccando tutto o non bloccando nulla — produce conseguenze opposte a quelle desiderate.
Il file **robots.txt** rimane il meccanismo primario di controllo: i principali operatori di bot AI dichiarano user agent identificabili (GPTBot, ClaudeBot, Google-Extended, Applebot-Extended) e rispettano le direttive Disallow per bloccare l’accesso al training. È fondamentale distinguere i token di controllo: bloccare Googlebot elimina la visibilità nella ricerca organica; bloccare Google-Extended impedisce solo l’uso dei contenuti già scansionati per il training di Gemini, senza impatto sul ranking. Il token Google-Extended, in particolare, non corrisponde a un bot reale visibile nei log di accesso del server: è una direttiva di policy interpretata a posteriori da Google sui contenuti già nell’indice.
### Bloccare o consentire i bot AI: la logica della decisione
**La scelta di bloccare i crawler di training AI** è una decisione strategica che non ha risposta universale: dipende dal rapporto tra il valore del contenuto come dato di training e il guadagno atteso in termini di visibilità nelle risposte generative. Bloccare i bot di training su robots.txt esclude il contenuto dai dataset futuri; consentirli rinuncia al controllo sull’uso del contenuto in cambio di potenziale esposizione nei sistemi AI.
Il fattore critico da considerare è la distinzione tra bot di training e bot di recupero in tempo reale. **GPTBot** raccoglie contenuti per il pretraining offline dei modelli di OpenAI e non invia traffico di ritorno; bloccare GPTBot non riduce la citabilità in ChatGPT con ricerca web attiva. **OAI-SearchBot**, invece, è il bot che alimenta le risposte in tempo reale di ChatGPT quando la ricerca web è attivata: bloccarlo elimina la fonte di traffico referral generativo proveniente da quel sistema. Questa asimmetria — bot di training vs bot di retrieval — è la distinzione operativa fondamentale che spesso viene ignorata quando si configurano blocchi indiscriminati. Secondo i [dati Similarweb](https://ir.similarweb.com/news-events/press-releases/detail/138/ai-discovery-surges-similarwebs-2025-generative-ai-report-says/), il traffico di referral generato dai sistemi AI è più che triplicato tra settembre 2024 e settembre 2025, con oltre 1,1 miliardi di visite di referral nel solo giugno 2025 (+357% su base annua), il che rende la cancellazione dall’ecosistema AI di retrieval una scelta con costi crescenti nel tempo.
## Effetto “**scansionata, attualmente non indicizzata**” sulla citabilità nelle risposte generative
**Una pagina nello stato “scansionata, attualmente non indicizzata”** (_crawled, currently not indexed_) è completamente esclusa dalla catena di selezione delle AI Overviews, dell’AI Mode e di qualsiasi sistema di retrieval basato sull’indice di Google. Il motore ha visitato la pagina, ne ha elaborato il contenuto, ma ha deciso di non registrarla nel database consultabile. Questa decisione ha un effetto equivalente all’assenza totale: il contenuto non esiste per i sistemi generativi che attingono a quell’indice.
Il punto critico è che lo stato _crawled, not indexed_ non segnala un errore tecnico ma una valutazione di qualità o pertinenza: Google ha ritenuto che la pagina non aggiungesse valore sufficiente rispetto a contenuti già presenti nell’archivio, o che il suo contenuto fosse troppo simile a varianti già registrate. Le cause più frequenti includono contenuto insufficientemente differenziato rispetto ad altre pagine dello stesso sito, format non allineato all’intento di ricerca prevalente per quel tipo di query, scarsa autorità di collegamento interna, e casi limite in cui la pagina è tecnicamente accessibile ma il testo principale è frammentato in modo non leggibile dal sistema di elaborazione.
L’impatto sulla strategia GEO su Google è diretto: qualsiasi ottimizzazione per la citabilità nelle risposte AI di Google — struttura a passaggi autoconclusivi, markup semantico, dati strutturati, completezza tematica — è inefficace se la pagina non ha superato il filtro di registrazione nell’indice. La diagnosi deve partire da Search Console (report Copertura → stato “Scansionata, attualmente non indicizzata”), seguita da un’analisi della differenziazione del contenuto rispetto alle pagine già indicizzate sullo stesso tema e da una verifica della leggibilità del testo principale dal punto di vista del sistema di rendering del bot.
### Come uscire dallo stato “scansionato ma non indicizzato” per recuperare la citabilità
**Il percorso di correzione** per le pagine escluse con questo stato inizia dall’identificazione del motivo effettivo — qualità del contenuto, duplicazione, formato errato rispetto all’intento, o problemi tecnici di accessibilità — e procede con interventi mirati sulla causa specifica, non con una richiesta generica di reindicizzazione. Richiedere la reindicizzazione tramite Search Console senza aver modificato il contenuto non produce effetti duraturi: il sistema rileverà le stesse condizioni che avevano determinato l’esclusione.
- **Differenziazione del contenuto:** se la pagina è esclusa per somiglianza con altri contenuti già nell’indice, la soluzione è aggiungere un angolo informativo non coperto dalle varianti già registrate — dati specifici, casistiche dettagliate, confronti espliciti con approcci alternativi. Per usare una metafora, è come il critico gastronomico che, assaggiata la terza variante dello stesso piatto, smette di scrivere recensioni: ogni pagina deve presentare un differenziale semantico riconoscibile.
- **Allineamento al format dell’intento di ricerca:** una pagina con contenuto valido ma struttura sbagliata rispetto all’intento prevalente (es. un lungo articolo editoriale su una query che premia i confronti in formato tabellare) può essere esclusa per inadeguatezza del format, non per mancanza di qualità. Verificare il format dominante tra le pagine già indicizzate per query simili fornisce il parametro di riferimento.
- **Potenziamento del collegamento interno:** una pagina non raggiunta da link interni di pagine già ad alta frequenza di ricrawl ha bassa priorità di revisione. Aggiungere almeno un link da una pagina categoria o da un articolo correlato ad alta visibilità aumenta la probabilità che il bot rivaluti la pagina nel ciclo successivo, con gli aggiornamenti di contenuto già applicati.
- **Leggibilità tecnica del testo principale:** se il contenuto rilevante è caricato tramite JavaScript con dipendenze esterne, nascosto da espansioni CSS o distribuito in componenti non sequenziali, il sistema di elaborazione potrebbe aver catturato una versione impoverita del contenuto. Verificare tramite lo strumento di ispezione URL di Search Console il rendering effettivo che Google vede è il primo controllo da eseguire in questi casi.