
Come funziona un knowledge graph

Un knowledge graph funziona collegando entità del mondo reale (persone, luoghi, concetti) con relazioni tipizzate, organizzate secondo uno schema che ne definisce il significato. È la parte del Web semantico che permette di interrogare i dati per ciò che rappresentano, non solo per le parole che li descrivono.
Come funziona un knowledge graph?
- Componenti: nodi, archi e uno schema o un’ontologia che stabilisce quali tipi di entità e relazioni sono ammessi.
- Meccanismo: la relazione tra due entità è memorizzata come elemento a sé, pronta da attraversare, non ricostruita con un join al momento della query.
- Uso con l’intelligenza artificiale: un modello linguistico interroga il grafo prima di generare una risposta, per fondarla su fatti verificabili invece che su un pattern linguistico plausibile.
- Scelta tecnica: un database a grafo nativo o un modello virtuale su dati relazionali, secondo volume di entità, frequenza di aggiornamento e complessità delle relazioni.
- Rilevanza attuale: resta alla base dei riquadri informativi di Google e, nei sistemi generativi, guida il recupero di percorsi di relazioni (GraphRAG) invece di soli frammenti di testo.
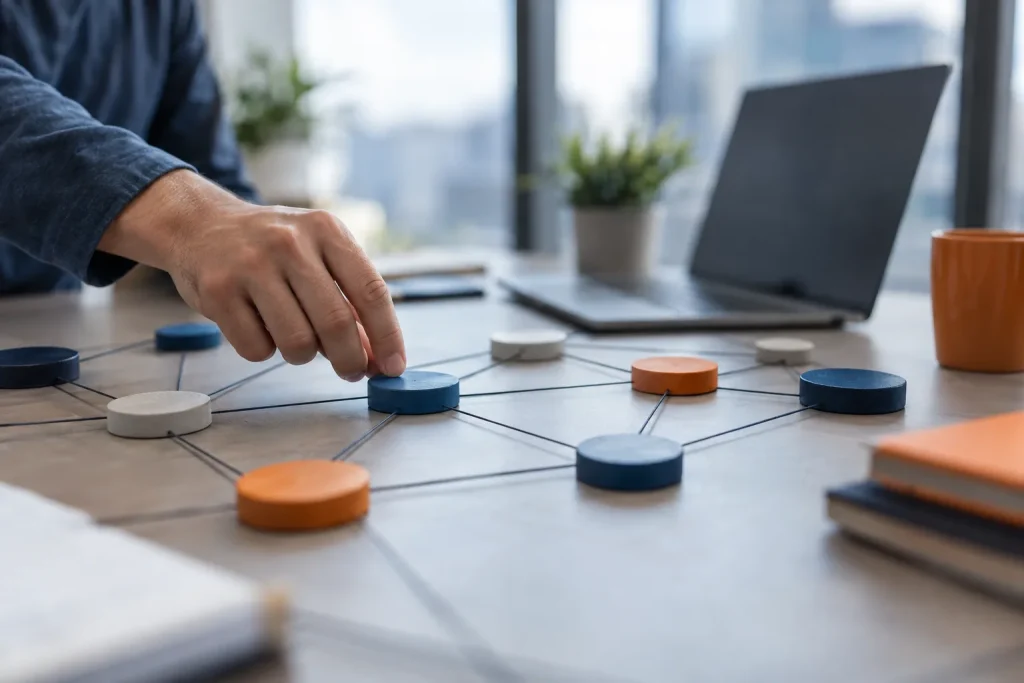
I componenti che fanno funzionare un knowledge graph
Tre elementi fanno funzionare questa struttura: nodi, archi e uno schema che ne governa il significato. I nodi rappresentano le entità del dominio (una persona, un prodotto, un’azienda) e portano una o più etichette che ne definiscono il tipo. Gli archi collegano due nodi e descrivono come sono connessi, per esempio “lavora per” o “situato in”; anche un arco può avere proprietà, come una data di inizio o un peso numerico.
A differenza di un database relazionale, dove la relazione tra due tabelle si ricostruisce al momento della query tramite un join, qui la relazione è un elemento di prima classe, già pronto per essere attraversato. Cambia così il modo di leggere i dati: non righe e colonne isolate, ma entità interconnesse direttamente.
Il terzo livello, spesso trascurato nelle definizioni più brevi, è lo schema o il significato di ontologia (ne abbiamo parlato in un articolo di web semantico) applicato ai dati: stabilisce quali tipi di nodo e di relazione sono ammessi. Può essere minimo, come una tassonomia di categorie prodotto, oppure esteso a un vocabolario aziendale completo. Senza questo livello l’insieme di nodi e archi resta un grafo generico, privo di significato strutturato: è lo schema condiviso a distinguere questa architettura da un grafo qualunque.
In un caso e-commerce, nodi cliente, nodi prodotto e nodi ordine si collegano tramite relazioni come “ha acquistato” o “appartiene alla categoria”: una query può restituire i prodotti acquistati da clienti con comportamento simile, cosa che una tabella isolata non fa con la stessa immediatezza.
Come distingue il significato dai semplici testi
Il principio che riassume questo funzionamento è “things, not strings”: il sistema associa significato ai dati invece di trattarli come sequenze di caratteri da confrontare. Un motore testuale che cerca “Roma” non distingue da solo se ci si riferisce alla città, a un film o a un nome proprio; collegando il termine al nodo entità corretto, corredato di proprietà e relazioni verificabili, la risposta diventa precisa.
Tre meccanismi rendono possibile questo passaggio. Il primo è la connessione dei dati: informazioni da fonti eterogenee, come un database interno, un catalogo pubblico o un documento non strutturato, vengono ricondotte agli stessi nodi, eliminando duplicazioni. Il secondo è la contestualizzazione tramite proprietà ed etichette, che arricchiscono ogni nodo con attributi verificabili. Il terzo, più avanzato, è l’inferenza: applicando uno schema o una regola logica, il sistema deduce fatti non inseriti esplicitamente, seguendo il percorso delle relazioni.
Un esempio concreto: se il grafo contiene “Roma è capitale di Italia” e “Italia è in Europa”, un motore di ragionamento deduce che Roma è una città europea senza che nessuno abbia inserito quella relazione a mano. Questo attraversamento di più relazioni consecutive, il ragionamento multi-hop, è alla base sia dei riquadri informativi dei motori di ricerca sia delle applicazioni più recenti di intelligenza artificiale generativa.
Va distinto il caso in cui i dati sono fisicamente memorizzati in un database a grafo nativo da quello di un grafo virtuale, che non conserva nulla al proprio interno ma recupera le informazioni da un database relazionale tramite un insieme di mapping configurati per tradurre lo schema relazionale in struttura a grafo. La scelta dipende dal volume dei dati, dalla frequenza di aggiornamento e dalla necessità di query in tempo reale.
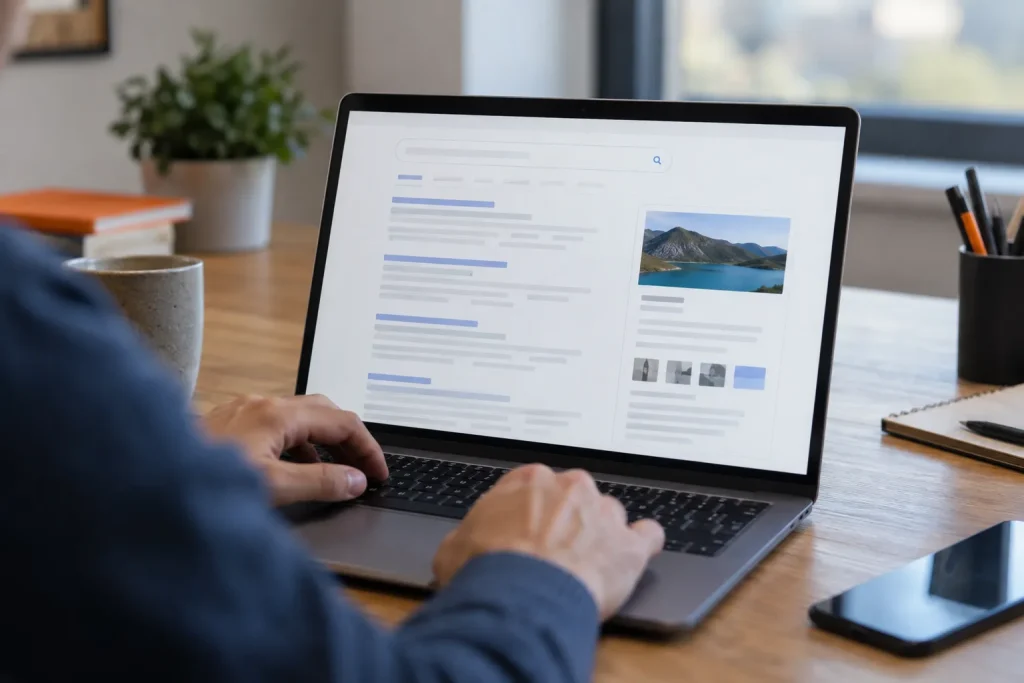
Come funziona il Google Knowledge Graph
Google ha lanciato il proprio grafo di entità nel maggio 2012, con l’obiettivo dichiarato di passare da una ricerca basata su stringhe testuali a una basata su entità reali e relazioni. Le informazioni di partenza venivano da Wikipedia, un progetto editoriale gestito dalla Wikimedia Foundation, da Wikidata e dal progetto DBpedia, oltre all’archivio Freebase; nel tempo si sono aggiunti dati strutturati estratti dalle pagine web in formato RDFa, Microdata e JSON-LD, organizzati secondo il vocabolario condiviso schema.org.
Il risultato visibile è il riquadro informativo accanto ai risultati per persone, luoghi, organizzazioni o opere, con immagine, descrizione sintetica e collegamenti a dati verificati incrociando più fonti. Una stima diffusa parla di oltre 500 milioni di oggetti coperti: Google non pubblica un numero aggiornato in modo ufficiale, quindi va presa solo come ordine di grandezza, non come dato preciso di oggi.
Comparire in questo riquadro non dipende da un’azione singola. Le condizioni che ne aumentano la probabilità (una pagina “chi siamo” completa, un profilo aziendale verificato, citazioni da fonti terze autorevoli, una scheda su Wikipedia o Wikidata) sono approfondite nella guida al knowledge panel, insieme ai limiti di questo tipo di visibilità.
L’effetto più discusso è la riduzione dei clic verso i siti di origine: una risposta diretta nel riquadro può soddisfare la ricerca senza un’ulteriore visita. Le richieste che necessitano di dettaglio o confronto restano fuori dalla portata del riquadro e continuano a richiedere una pagina dedicata. Sulla disponibilità di un’interfaccia pubblica: esiste un’API di ricerca sulle entità con una soglia gratuita di utilizzo giornaliero; prima di pianificarne un uso su scala, conviene verificare la documentazione ufficiale, perché i limiti di quota possono cambiare.
Perché i modelli linguistici lo usano e come funzionano insieme
Un modello linguistico comprende e produce testo a partire da pattern statistici, ma non ha un meccanismo interno che distingua un fatto verificato da una frase plausibile. Collegato a una rete di entità e relazioni, il modello la interroga prima di rispondere, e usa ciò che trova come base per la risposta: è il modo più diretto per ridurre le affermazioni infondate.
L’integrazione funziona in due direzioni. Nella prima, il grafo fornisce contesto fattuale al modello. Nella seconda è il modello a costruire il grafo: analizzando testo non strutturato, estrae entità e relazioni e popola automaticamente la rete, un lavoro che un tempo richiedeva annotazione manuale o regole linguistiche rigide.
Questa combinazione ha preso il nome di GraphRAG: invece di recuperare solo frammenti di testo simili alla domanda, recupera percorsi di relazioni. Questo collega informazioni distribuite su più nodi e consente di rispondere a domande con più passaggi logici. The Knowledge Graph Renaissance: Why 2026 Is Different (2024) riporta un caso concreto: LinkedIn ha applicato GraphRAG alle operazioni di supporto riducendo il tempo medio di risoluzione dei ticket da 40 a circa 15 ore, un calo del 63%. È un singolo caso aziendale, non una regola generale: il risultato dipende dalla qualità delle relazioni nel grafo di partenza, non solo dalla tecnica in sé.
Un assistente conversazionale generico diventa un sistema RAG quando viene collegato a un meccanismo di recupero documentale esterno, e diventa un sistema basato su grafo quando quel recupero interroga un database a grafo invece di un indice testuale.
Neo4j nel funzionamento di un knowledge graph
Neo4j è un database a grafo nativo, uno degli strumenti più usati per memorizzare e interrogare nodi, archi e proprietà senza passare da tabelle relazionali; usa un proprio linguaggio di interrogazione, Cypher, pensato per scrivere query di attraversamento in poche righe.
Neo4j è l’infrastruttura di memorizzazione delle relazioni, non un sistema GraphRAG in sé. Diventa parte di una pipeline GraphRAG solo quando un livello aggiuntivo collega quelle relazioni a un modello linguistico per il recupero e la generazione del testo. Un database a grafo nativo diventa parte di un sistema RAG solo quando un componente aggiuntivo lo collega al modello generativo.
Prima di citare un caso d’uso specifico di Neo4j in ambito aerospaziale conviene consultare direttamente le pubblicazioni ufficiali dell’ente o del fornitore, perché affermazioni simili circolano spesso senza una fonte verificabile dietro.
Knowledge graph o RAG: quando conviene l’uno o l’altro
Un knowledge graph risponde a un problema diverso da un sistema RAG tradizionale, e i due si scelgono in base al tipo di domanda da soddisfare. Il RAG su testo recupera frammenti semanticamente simili alla domanda da una base documentale: funziona bene quando l’informazione è contenuta per intero in un singolo passaggio. Questa struttura, invece, recupera percorsi di relazioni tra entità, ed è più efficace quando la risposta richiede di collegare informazioni sparse su più fonti o più passaggi (query multi-hop).
| Aspetto | Knowledge graph | RAG su testo |
|---|---|---|
| Dato recuperato | Entità e relazioni strutturate | Frammenti di testo simili semanticamente |
| Adatto a domande | Multi-hop, che collegano più fatti | Dirette, contenute in un solo passaggio |
| Manutenzione | Schema e aggiornamento delle relazioni | Aggiornamento dell’indice documentale |
| Rischio di allucinazione | Ridotto, dati verificabili in triple | Presente se il frammento recuperato è ambiguo |
Nella pratica i sistemi più recenti combinano i due approcci: il testo non strutturato alimenta il recupero semantico classico, mentre la rete di entità interviene quando la domanda richiede di attraversare più relazioni verificate. La regola che applico quando mi chiedono quale scegliere è semplice: se le domande del progetto si risolvono quasi sempre con un solo documento, parto dal RAG su testo; se richiedono di collegare fatti distanti tra loro, il costo di costruire uno schema minimo si ripaga in affidabilità delle risposte.
Come si costruisce un knowledge graph
Il percorso parte dall’identificazione delle entità di dominio e arriva alla scelta del database più adatto a memorizzarle.
- Individuare le entità principali del dominio (persone, prodotti, luoghi, eventi) e i tipi di relazione rilevanti tra loro.
- Definire uno schema minimo che stabilisca le categorie ammesse per nodi e relazioni, senza sovradimensionarlo prima di conoscere i casi d’uso reali.
- Scegliere il modello di memorizzazione: un database a grafo nativo a proprietà per query dirette su dati fortemente interconnessi, oppure un grafo virtuale su un database relazionale già esistente, se la migrazione fisica non è giustificata dal volume.
- Popolare la struttura importando dati già strutturati e, se serve, estraendo entità e relazioni da testo non strutturato con tecniche di elaborazione del linguaggio o modelli linguistici.
- Verificare la qualità delle relazioni estratte, correggendo ambiguità e duplicazioni prima di esporre i dati a query di produzione.
- Collegare uno strumento di visualizzazione o un’interfaccia di interrogazione, così analisti o sistemi a valle possono esplorare la rete di entità.
| Categoria | Caratteristica | Quando sceglierla |
|---|---|---|
| Database a grafo a proprietà | Memorizza nodi e relazioni nativamente, come Neo4j | Relazioni complesse, query di attraversamento frequenti |
| Framework che usano RDF | Rappresenta i dati come triple soggetto-predicato-oggetto | Interoperabilità con dataset pubblici collegati |
| Strumenti di estrazione da testo | Costruiscono la rete a partire da documenti non strutturati | Grandi volumi di testo non ancora strutturato |
Che differenza c’è tra un grafo generico e un knowledge graph
Un grafo generico è una struttura matematica di nodi e archi senza vincoli sul significato di ciò che rappresentano. Qui invece uno schema attribuisce un significato verificabile a ogni nodo e a ogni relazione. Un grafo di rete sociale che collega utenti con la relazione generica “connesso a” resta un grafo semplice finché non distingue il tipo di ciascuna entità e di ciascuna relazione: solo allora diventa interrogabile per categorie e proprietà, non solo per connessioni dirette.
Un esempio aiuta a fissare la differenza: il nodo “Colosseo” con proprietà come anno di costruzione e categoria “monumento storico”, collegato tramite “situato in” al nodo “Roma”, a sua volta collegato tramite “capitale di” al nodo “Italia”. Da questa struttura si risale dal singolo monumento all’intero contesto geografico senza consultare tabelle separate. Non esiste una versione “migliore” in assoluto: un progetto con poche migliaia di entità e relazioni semplici funziona anche su un modello leggero senza schema formale complesso; un progetto che richiede inferenza su vasta scala trae beneficio da un’ontologia strutturata e da un database a grafo nativo.
A cosa serve oggi e perché resta rilevante
Il ruolo di questa struttura si è spostato da complemento dei motori di ricerca a componente infrastrutturale dei sistemi di intelligenza artificiale che hanno bisogno di dati verificabili. I motori di ricerca restano l’applicazione più visibile, con i riquadri informativi generati a partire dalle entità riconosciute nella query, lo stesso principio di entità applicato alla ricerca organica. Nei sistemi di raccomandazione collega prodotti, utenti e comportamenti d’acquisto in un’unica rete, con suggerimenti basati su percorsi di relazione invece che su semplici correlazioni statistiche.
Nel contesto aziendale integra dati da sistemi diversi, come CRM, ERP e documentazione interna, in un’unica mappa concettuale. Un progetto può avere un respiro ampio, con l’obiettivo di collegare l’intero patrimonio informativo di un’organizzazione, oppure un respiro ristretto, limitato a un caso d’uso come un catalogo prodotti: la seconda opzione richiede meno tempo di progettazione e permette di verificare il valore dell’approccio prima di estenderlo. Applicazioni scientifiche, come la genomica e la biologia dei sistemi, usano questa stessa logica per collegare dati sperimentali distribuiti su più dataset.
Che non sia una moda passeggera lo conferma anche la dimensione del mercato che lo circonda: secondo Knowledge Graphs Drive Intelligent Data Management (2025) il mercato globale dei knowledge graph valeva 1,34 miliardi di dollari nel 2025, con una crescita stimata fino a 19,16 miliardi entro il 2035 e un CAGR del 30,8% nel periodo 2026-2035. Sono stime di mercato, non garanzie: le riporto perché indicano in che direzione gli investimenti si stanno muovendo, non come proiezione del valore per un singolo progetto aziendale.
Casi limite ed errori frequenti nella progettazione
Alcune scelte determinano se questa struttura resta utile nel tempo o diventa difficile da mantenere.
Se il dominio ha poche entità e relazioni stabili: evita uno schema complesso
Se un progetto tratta poche centinaia o migliaia di entità con relazioni semplici e stabili, costruire un’ontologia formale completa prima di avere casi d’uso reali costa più di quanto renda. Conviene partire da uno schema minimo, verificarne l’utilità sul caso specifico ed estenderlo solo quando emergono nuove esigenze di query.
Se i dati cambiano spesso e vengono da testo non strutturato: automatizza l’estrazione ma verifica
Se entità e relazioni vanno aggiornate di frequente da fonti testuali eterogenee, l’estrazione manuale diventa un collo di bottiglia. L’estrazione automatica con modelli linguistici riduce il tempo di popolamento, ma introduce il rischio di relazioni errate o duplicate, da controllare con un processo di validazione prima di usarle per l’inferenza.
Gli errori più frequenti che vedo tornare: etichette incoerenti sullo stesso tipo di nodo, che rendono ambigue le query; l’assenza di un processo di deduplicazione, che porta a nodi doppi per la stessa persona o organizzazione; relazioni troppo generiche come “collegato a”, che non permettono un’interrogazione precisa; e un database a grafo nativo scelto per volumi che non ne giustificano la complessità operativa, dove un modello virtuale su un database relazionale esistente avrebbe risolto lo stesso caso a un costo inferiore.
Domande frequenti
Cos’è un knowledge graph?
È una struttura dati che rappresenta entità reali come nodi e le relazioni tra loro come archi, arricchiti da uno schema che ne definisce il significato. Questa organizzazione permette query per significato e non solo per corrispondenza testuale.
Che differenza c’è tra un grafo e un knowledge graph?
Un grafo è una struttura matematica neutra di nodi e archi; qui uno schema tipizza entità e relazioni, rendendole interrogabili in base al loro significato e non solo alla loro posizione nella rete.
Perché i modelli linguistici lo usano?
Perché offre fatti verificabili da interrogare prima di generare una risposta, riducendo il rischio di affermazioni plausibili ma infondate: è il principio su cui si basa la tecnica nota come GraphRAG.
Un knowledge graph è meglio di un sistema RAG?
Non in assoluto: funziona meglio per domande che collegano più fatti distribuiti su più nodi, mentre un sistema RAG su testo è più adatto quando la risposta è contenuta in un singolo passaggio documentale.
Come si crea un knowledge graph?
Si parte dall’identificazione di entità e relazioni del dominio, si definisce uno schema minimo, si sceglie tra un database a grafo nativo o un modello virtuale su dati relazionali, si popola e se ne verifica la qualità prima dell’uso in produzione.
Il Google Knowledge Graph è ancora rilevante?
Sì: resta alla base dei riquadri informativi nei risultati di ricerca e, con l’espansione verso l’intelligenza artificiale generativa, il principio che rappresenta è diventato anche una fonte di dati verificabili per i modelli linguistici.
L’API del Google Knowledge Graph è gratuita?
È disponibile una soglia di utilizzo gratuito giornaliero per l’interrogazione delle entità pubbliche, oltre la quale valgono le condizioni della documentazione ufficiale, che vanno verificate periodicamente perché possono cambiare.
