
Lemmatizzazione: definizione e funzionamento nell’elaborazione del linguaggio

La lemmatizzazione è il processo linguistico-computazionale che riconduce una forma flessa di una parola alla sua forma canonica, il lemma, tenendo conto della categoria grammaticale e del contesto d’uso. Applicata nell’elaborazione del linguaggio naturale e nei motori di ricerca, raggruppa le varianti morfologiche sotto un’unica voce di riferimento, riducendo la dimensione del vocabolario analizzato.
In breve
- Cosa risolve: unifica le varianti flesse di una parola (genere, numero, modo, tempo) sotto un’unica forma di riferimento, semplificando l’analisi testuale.
- Quando si applica: nella preparazione di corpora per NLP, nell’indicizzazione dei motori di ricerca e nei sistemi di classificazione automatica dei testi.
- Condizioni e limiti: richiede l’analisi grammaticale (POS tagging) per essere accurata; senza di essa può produrre lemmi ambigui su parole con più significati.
- Come verificare il risultato: si controlla che ogni forma restituita sia una parola realmente esistente nel dizionario di riferimento, non un troncone artificiale.
- Cosa fare in pratica: si sceglie un lemmatizzatore coerente con la lingua del corpus e, per l’italiano, uno strumento addestrato su un dizionario morfologico completo.
Cos’è il lemma e cosa lo distingue dal lessema
Il lemma è la forma di citazione di una parola, quella riportata come voce autonoma in un dizionario. Ogni verbo coniugato, ogni nome plurale o aggettivo declinato ha un solo lemma di riferimento: l’infinito per i verbi, il maschile singolare per nomi e aggettivi.
Un concetto spesso confuso con il lemma è il lessema, cioè la combinazione tra la forma canonica e la relativa categoria grammaticale. Due parole possono condividere la stessa forma scritta ma appartenere a lessemi diversi: è il caso dell’omografia, dove il lemmatizzatore deve distinguere il significato corretto in base al contesto della frase, non solo alla grafia.
- Lemma
- Forma canonica di una parola, quella cercata sul dizionario.
- Lessema
- Unione tra lemma e categoria grammaticale (es. “correre” come verbo).
- Forma flessa
- Variante di una parola generata da coniugazione, declinazione o accordo.
Questa distinzione è alla base di ogni sistema di normalizzazione del testo: senza un riferimento chiaro tra forma flessa, lemma e lessema, un algoritmo rischia di accorpare parole con significati distanti o di lasciarne separate altre che invece condividono lo stesso concetto di base.
Come funziona la lemmatizzazione: dalla forma flessa al lemma
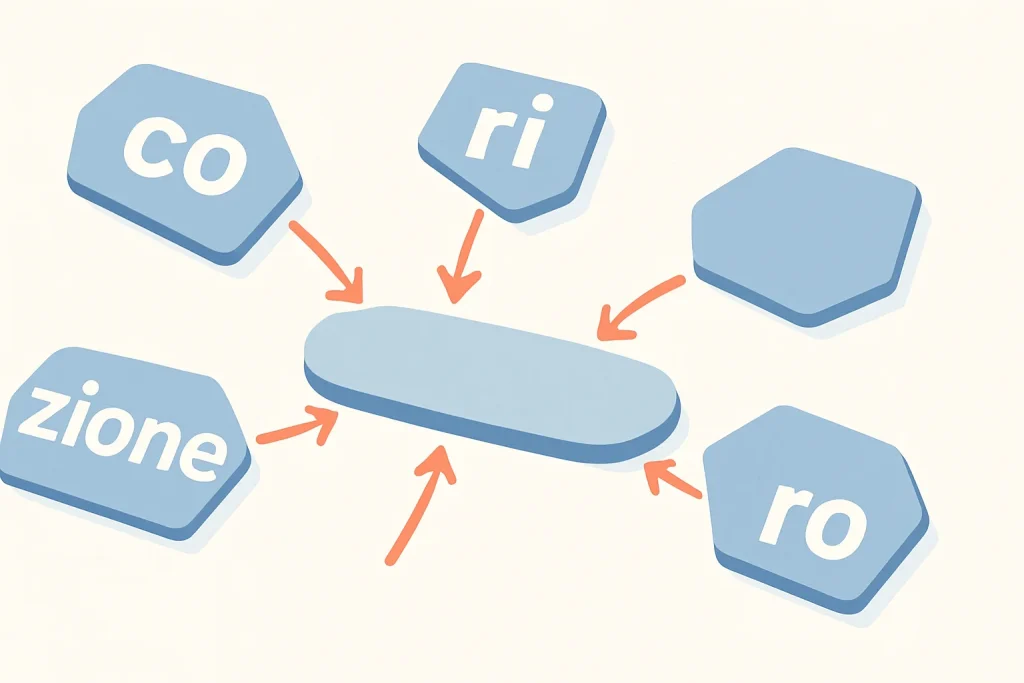
Il processo converte i verbi coniugati nella forma all’infinito e i nomi o gli aggettivi flessi nel maschile singolare, dopo aver riconosciuto la categoria grammaticale della parola nella frase. Questa analisi, chiamata POS tagging, è ciò che distingue il metodo da una semplice riduzione meccanica delle desinenze.
Alcuni esempi rendono immediato il meccanismo:
- Verbi: “andavo”, “andammo”, “andremo” convergono tutti verso “andare”.
- Sostantivi: “cani” e “cagnolino” restano distinti da “cane” solo se il sistema riconosce la differenza semantica; le forme puramente flesse come “cani” si riducono a “cane”.
- Aggettivi: “bellissime” e “bella” convergono in “bello”.
L’operazione richiede due fasi consecutive. Nella prima, il testo viene scomposto in unità minime tramite la tokenizzazione; nella seconda, ogni unità riceve un’etichetta grammaticale che guida la scelta del lemma corretto. Nei casi di verbi irregolari, come “vado” e “andremo”, il sistema non può basarsi sulla radice comune e deve consultare un dizionario morfologico che associ direttamente la forma flessa al lemma “andare”, senza passare per regole di derivazione regolare.
Rispetto a un confronto puramente sintattico tra caratteri, questo approccio garantisce che l’output sia sempre una parola realmente esistente e coerente con il ruolo che occupa nella frase, condizione che una riduzione basata solo su regole fisse non può garantire.
A cosa serve nell’elaborazione del linguaggio naturale e nei motori di ricerca
Nel campo dell’NLP questa tecnica riduce la dimensione del vocabolario analizzato: invece di trattare “calciatore” e “calciatori” come due elementi distinti, un sistema di classificazione o di analisi tematica li tratta come un’unica entità semantica, aumentando l’efficienza dei modelli statistici e diminuendo il rumore nei dati.
Nei motori di ricerca il vantaggio si traduce in un collegamento più affidabile tra la query digitata dall’utente e i documenti indicizzati contenenti varianti diverse della stessa parola: una ricerca per “smartphone” può così recuperare risultati che nel testo originale riportano “smartphone” declinato al plurale o in forme correlate, senza che l’utente debba conoscere l’esatta forma presente nel documento. Questo meccanismo lavora spesso in combinazione con altre tecniche di recupero dell’informazione, come l’espansione della query, che aggiunge sinonimi o termini correlati, e la tokenizzazione, che scompone il testo in unità elaborabili a monte del processo.
Altri impieghi ricorrenti riguardano i sistemi di classificazione automatica dei documenti, i chatbot che devono riconoscere intenti espressi con forme verbali diverse, e gli strumenti di analisi lessicale dei corpora storici o letterari, dove la riduzione al lemma permette di contare le occorrenze reali di un concetto a prescindere dalla forma grammaticale usata dall’autore.
In tutti questi contesti il beneficio non è la velocità di calcolo, ma la qualità dell’aggregazione semantica: un vocabolario più compatto e coerente produce analisi statistiche più stabili e risultati di ricerca percepiti come più pertinenti.
Differenza tra lemmatizzazione e stemming
Lo stemming riduce una parola alla sua radice tagliando i suffissi secondo regole fisse, senza considerare il contesto grammaticale né verificare che il risultato sia una parola valida. La lemmatizzazione, al contrario, usa l’analisi grammaticale per restituire sempre una forma di dizionario compiuta.
| Criterio | Lemmatizzazione | Stemming |
|---|---|---|
| Metodo | Analisi morfologica e grammaticale del contesto | Regole fisse di troncamento dei suffissi |
| Risultato | Parola sempre valida da dizionario (es. “salti” → “salto”) | Può generare tronconi inesistenti (es. “salti” → “salt”) |
| Costo computazionale | Più elevato, richiede dizionari o modelli linguistici | Più basso, esecuzione rapida su grandi volumi |
| Accuratezza semantica | Alta, distingue significati diversi della stessa forma | Bassa, non gestisce ambiguità grammaticale |
La scelta tra i due metodi dipende dall’obiettivo dell’analisi: quando serve una riduzione rapida su archivi molto ampi e la precisione lessicale è secondaria, lo stemming resta sufficiente; quando invece l’accuratezza semantica condiziona la qualità del risultato finale, come nell’indicizzazione di un motore di ricerca o nella classificazione automatica di testi, la lemmatizzazione è la scelta necessaria nonostante il maggiore carico di elaborazione.
Come implementare la lemmatizzazione con Python
L’implementazione pratica richiede una libreria che integri un dizionario morfologico o un database lessicale, oltre a un modulo di analisi grammaticale per assegnare la categoria corretta a ogni parola prima della riduzione al lemma.
- Si scompone il testo in singole unità tramite la tokenizzazione, separando parole, punteggiatura e simboli.
- Si assegna a ogni token la categoria grammaticale corretta con un modulo di POS tagging, poiché la stessa forma scritta può corrispondere a lemmi diversi a seconda del ruolo nella frase.
- Si applica il lemmatizzatore, che consulta un database lessicale come WordNet per l’inglese, organizzato in insiemi di sinonimi (synset) collegati da relazioni di iperonimia e iponimia, oppure un dizionario morfologico dedicato per le lingue flessive come l’italiano.
- Si verifica l’output confrontando ogni lemma restituito con il dizionario di riferimento, per escludere forme non valide dovute a errori di riconoscimento della categoria grammaticale.
Per l’inglese, librerie come NLTK forniscono un lemmatizzatore basato su WordNet, a cui va passata esplicitamente la parte del discorso per ottenere un risultato corretto: la stessa forma “running” restituisce lemmi diversi se trattata come verbo o come sostantivo. Per l’italiano, strumenti come spaCy integrano modelli linguistici pre-addestrati capaci di gestire la lemmatizzazione insieme all’analisi grammaticale in un unico passaggio, senza richiedere l’indicazione manuale della categoria per ogni parola.
Il costo computazionale cresce con la dimensione del corpus e con la complessità del modello linguistico utilizzato: su archivi di grandi dimensioni conviene eseguire la lemmatizzazione in fase di indicizzazione, una sola volta, piuttosto che ripeterla a ogni interrogazione.
Casi limite ed errori frequenti nella lemmatizzazione
Alcune condizioni linguistiche richiedono un trattamento diverso da quello standard, pena risultati imprecisi o incoerenti con il significato originale del testo.
Se la parola è un verbo irregolare: si consulta il dizionario morfologico
Se una forma verbale non condivide la radice con il proprio lemma, come “vado” rispetto ad “andare”, non è possibile applicare una regola di derivazione automatica: il sistema deve avere accesso a una tabella di eccezioni o a un dizionario morfologico completo che associ direttamente ogni forma irregolare al lemma corretto.
Se una forma flessa cambia significato con il genere: si evita la riduzione automatica
Se due forme come “beni” e “bene”, oppure “singola” e “singolo”, esprimono concetti distinti e non una semplice variazione grammaticale della stessa parola, la lemmatizzazione automatica standard va disattivata per quei casi specifici, per non appiattire significati che nell’analisi del testo restano separati.
Se due parole condividono la stessa grafia ma lemmi diversi: si marca l’ambiguità
Se la stessa sequenza di caratteri corrisponde a due lessemi differenti (omografia), un sistema accurato distingue le due forme con un identificativo separato, evitando di unire sotto lo stesso lemma parole che nella lingua reale restano concettualmente distinte.
Se la lingua è fortemente flessiva: si prevede un costo computazionale maggiore
Se il corpus è in una lingua con molte forme per parola, come l’italiano rispetto all’inglese, il numero di varianti da ricondurre al lemma cresce sensibilmente: questo richiede dizionari morfologici più estesi e tempi di elaborazione più lunghi rispetto a lingue meno flessive, ma resta la condizione necessaria per ottenere un’analisi testuale affidabile.
Se la categoria grammaticale non è nota: la precisione del lemma cala
Se il testo non viene preventivamente analizzato con il POS tagging, il lemmatizzatore può assegnare un lemma errato alle parole con più significati possibili; in questi casi conviene eseguire comunque un’analisi grammaticale di base prima della riduzione, anche quando lo strumento usato la rende facoltativa.
Domande frequenti
Che cos’è il lemma di una parola?
Il lemma è la forma di citazione di una parola, quella riportata come voce autonoma in un dizionario: l’infinito per i verbi, il maschile singolare per nomi e aggettivi. Ogni forma flessa della stessa parola viene ricondotta a questo unico riferimento.
Come funziona la lemmatizzazione su verbi e sostantivi?
Il sistema riconosce prima la categoria grammaticale della parola nella frase, poi applica la trasformazione: i verbi tornano all’infinito, i nomi e gli aggettivi al maschile singolare, anche nei casi irregolari dove la radice non è condivisa con il lemma.
A cosa serve la lemmatizzazione nei motori di ricerca?
Serve a collegare una query digitata dall’utente a tutte le varianti morfologiche presenti nei documenti indicizzati, migliorando la pertinenza dei risultati senza richiedere che l’utente conosca la forma esatta usata nel testo originale.
Qual è la differenza tra lemmatizzazione e stemming?
Lo stemming taglia i suffissi con regole fisse e può produrre parole inesistenti, mentre la lemmatizzazione analizza il contesto grammaticale e restituisce sempre una forma valida da dizionario, a costo di un carico computazionale maggiore.
Come si implementa la lemmatizzazione in Python?
Si scompone il testo in token, si assegna la categoria grammaticale a ciascuno con un modulo di POS tagging, poi si applica un lemmatizzatore basato su un dizionario morfologico o su un database lessicale come WordNet, verificando infine la validità dell’output.
Perché la lemmatizzazione è più complessa in italiano che in inglese?
L’italiano è una lingua fortemente flessiva, con molte forme per ogni parola tra coniugazioni verbali, generi e numeri: questo richiede dizionari morfologici più estesi e tempi di elaborazione maggiori rispetto a lingue con minore variazione morfologica.
Come si gestisce l’omografia nella lemmatizzazione?
Quando due parole condividono la stessa grafia ma corrispondono a lemmi diversi, un sistema accurato distingue le due forme con un identificativo separato, evitando di unirle sotto lo stesso lemma e mantenendo distinti i rispettivi significati.
