
Query fan-out: definizione e funzionamento

In questa pagina il termine query fan-out indica la tecnica con cui un motore di ricerca basato su intelligenza artificiale scompone un prompt in più sotto-query parallele per costruire una risposta sintetica, distinta dall’omonimo fan-out dell’elettronica digitale o dei sistemi distribuiti. Il meccanismo riguarda esclusivamente l’ambito della GEO e dei motori generativi come AI Mode.
In breve
- Cosa risolve: spiega perché una risposta generata da un motore AI raramente deriva da una sola pagina web, ma dalla fusione di più fonti interrogate in parallelo.
- Quando si applica: nei sistemi di ricerca conversazionale e generativa che usano il recupero di documenti prima di sintetizzare una risposta.
- Condizioni e limiti: il numero di sotto-query varia in base alla complessità del prompt e non è direttamente osservabile da chi pubblica contenuti.
- Come verificare: alcuni strumenti estraggono le sotto-query effettive analizzando i parametri di ricerca restituiti dal sistema generativo.
- Cosa fare: strutturare i contenuti in blocchi autosufficienti e in architetture hub-and-spoke che coprano più angolazioni dello stesso tema.
Cos’è il fan out nei motori di ricerca basati su intelligenza artificiale
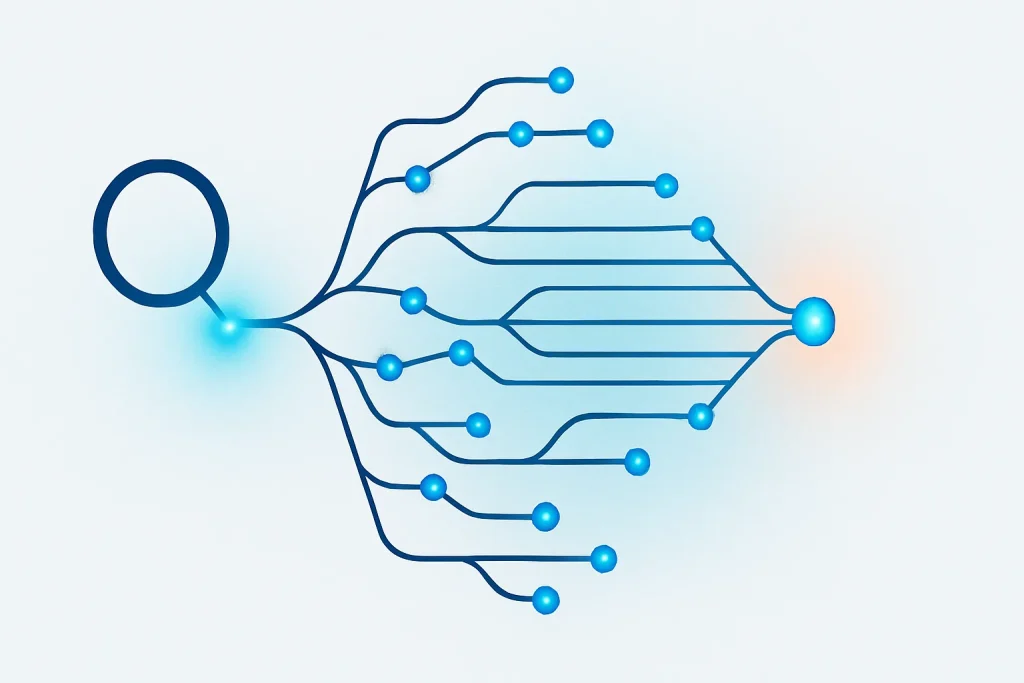
Il fan out, in questo contesto, è il processo con cui un sistema generativo non si limita a interpretare letteralmente la domanda dell’utente ma la traduce in una serie di ricerche correlate, mediamente tra nove e undici, per raccogliere angolazioni diverse dello stesso bisogno informativo.
Questa espansione avviene perché una singola interrogazione testuale, presa alla lettera, raramente contiene tutte le sfumature necessarie a una risposta completa: confronti impliciti, aggiornamenti temporali, attributi di un’entità o passaggi successivi del percorso di ricerca. Il sistema genera quindi domande satellite che, sommate, ricostruiscono lo spazio di intenti dietro il prompt originale.
A differenza di una interrogazione su un database relazionale, dove una query restituisce un set di record definiti da criteri espliciti, qui l’obiettivo non è recuperare righe di dati ma frammenti testuali pertinenti da fonti eterogenee, poi ricomposti in linguaggio naturale. Il meccanismo nasce con l’evoluzione dei sistemi RAG, in cui un modello linguistico recupera documenti prima di generare la risposta, e trova applicazione diretta in AI Mode e negli altri motori di ricerca generativi.
Il risultato pratico è che una risposta sintetica cita spesso più fonti contemporaneamente, ciascuna delle quali ha coperto solo una porzione dello spazio di intenti esplorato dal fan out, non l’intera domanda dell’utente.
Come funziona in sintesi il meccanismo di fan-out
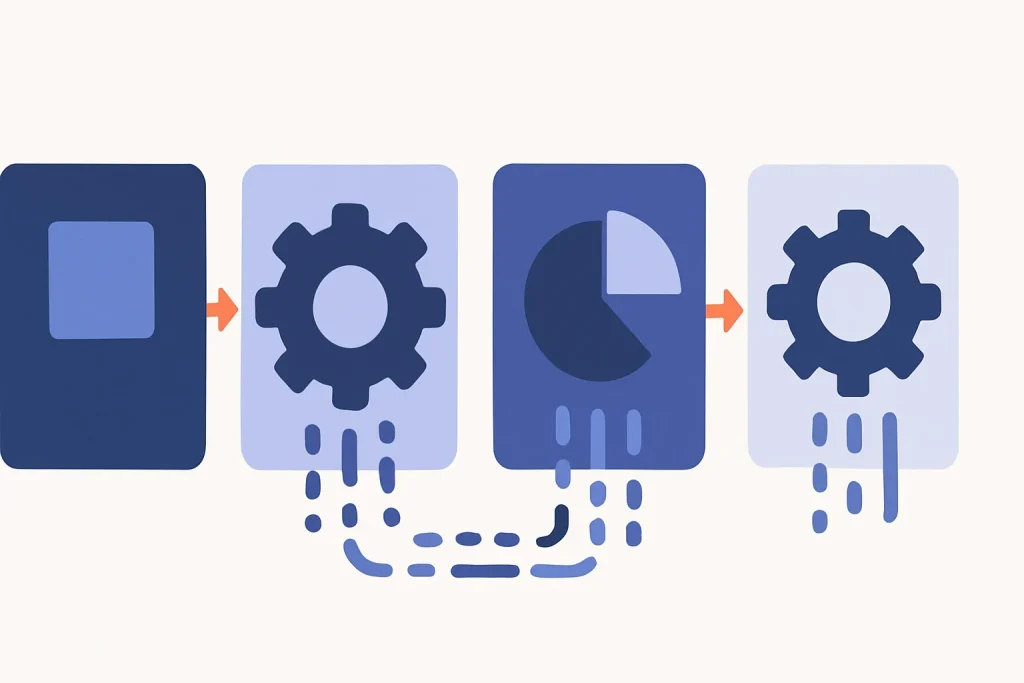
Il meccanismo si articola in quattro fasi sequenziali, ciascuna necessaria alla successiva, e può essere descritto come una procedura ripetibile applicata a ogni prompt complesso.
- Analisi dell’intento: il sistema valuta la complessità semantica del prompt e individua le sfumature non esplicitate dall’utente, come confronti, requisiti impliciti o ambiguità da risolvere.
- Decomposizione: il prompt viene scomposto in sotto-domande mirate, ciascuna orientata a un aspetto specifico dello stesso bisogno informativo, dalle domande implicite agli attributi di un’entità.
- Recupero parallelo: le sotto-domande vengono inviate simultaneamente a più indici e a strutture di conoscenza come il Knowledge Graph, così da raccogliere contenuti da fonti diverse nello stesso momento.
- Sintesi tramite fusione dei ranking: i risultati raccolti vengono uniti e riordinati con una tecnica di RRF, che assegna un peso a ciascuna fonte in base alla sua ricorrenza e pertinenza across le sotto-query, prima di comporre la risposta finale.
La fusione dei ranking è il punto che distingue questo processo da una semplice somma di risultati: una fonte citata da più sotto-query riceve un peso maggiore rispetto a una fonte che compare in una sola diramazione, anche se quest’ultima occupa una posizione alta nel suo singolo elenco.
Il numero effettivo di sotto-query generate per un dato prompt non è un valore fisso: dipende dalla piattaforma, dal dominio della domanda e dalla quantità di contesto già disponibile. Per verificarlo su un prompt specifico occorre osservare i parametri di ricerca restituiti dal sistema durante l’elaborazione, non stimarlo a priori.
Cosa cambia per la visibilità e i contenuti in ottica SEO/AI
Il cambiamento principale riguarda l’unità di lavoro: non più una pagina ottimizzata per una parola chiave, ma un insieme di contenuti che copre più porzioni dello spazio di intenti attivato dal fan out. La domanda strategica non è più “per quale parola chiave voglio comparire” ma “quale porzione dell’intento del mio dominio riesco a coprire meglio delle alternative disponibili”.
| Aspetto | Approccio orientato alla keyword singola | Approccio orientato al fan-out |
|---|---|---|
| Unità di ottimizzazione | Singola pagina per singola query | Insieme di pagine che copre più sotto-query correlate |
| Struttura del testo | Sezioni lunghe organizzate per argomento generale | Paragrafi autosufficienti estraibili come passaggi indipendenti |
| Architettura del sito | Pagine isolate o gerarchia piatta | Architettura hub-and-spoke con pagina centrale e approfondimenti collegati |
| Metrica di riferimento | Posizione media su una query | Frequenza di citazione across le sotto-query generate dal prompt |
La struttura a blocchi, o ottimizzazione a livello di passaggio, richiede che ogni sezione risponda a una domanda specifica in modo autonomo, con intestazioni chiare e una risposta diretta nelle prime frasi: è così che un frammento diventa candidabile all’estrazione da parte del sistema generativo, indipendentemente dal resto della pagina.
L’architettura hub-and-spoke completa il quadro: una pagina hub definisce il tema generale e le sue generalizzazioni, mentre pagine di approfondimento collegate coprono ogni specificazione o implicazione, in modo che l’insieme del dominio copra più sotto-query possibili dello stesso spazio di intenti, invece di concentrare tutto lo sforzo su un’unica formulazione.
Errori frequenti e casi limite nell’ottimizzazione per il fan-out
Alcuni errori ricorrenti riducono la probabilità che un contenuto venga selezionato durante la fase di recupero parallelo, anche quando il tema trattato è pertinente.
Se il contenuto risponde a una sola sotto-query: rischio di esclusione dalla sintesi
Se una pagina copre un solo angolo del tema, ad esempio la sola definizione senza le implicazioni pratiche, compete solo per una delle diramazioni generate dal fan out e viene esclusa dalle altre, anche quando il dominio complessivo sarebbe pertinente.
Se la pagina copre più angolazioni dello stesso tema: aumenta la probabilità di citazione
Se un contenuto affronta definizione, funzionamento, implicazioni operative e casi limite nello stesso ecosistema di pagine, aumenta il numero di sotto-query per cui può risultare pertinente, e con esso la probabilità di essere incluso nella fusione dei ranking finale.
Un altro errore frequente consiste nel duplicare la stessa informazione su più pagine dello stesso dominio: la ridondanza non aumenta la copertura dello spazio di intenti, perché il sistema di fusione tende a scartare fonti che ripetono lo stesso contenuto già raccolto da un’altra sotto-query. Coprire più attributi distinti, anche su pagine separate ma collegate, è più efficace che ripetere lo stesso attributo su più pagine.
Un ultimo caso limite riguarda i contenuti privi di struttura interna riconoscibile: paragrafi lunghi senza intestazioni intermedie rendono più difficile l’estrazione di un passaggio autonomo, anche quando l’informazione contenuta risponde correttamente a una delle sotto-query generate.
Domande frequenti
Cos’è il fan out in questo contesto?
È il processo con cui un motore di ricerca generativo scompone un prompt in più sotto-query parallele, così da raccogliere angolazioni diverse dello stesso bisogno informativo prima di sintetizzare la risposta finale.
Quante sotto-query genera in media il meccanismo?
Il numero varia in base alla complessità del prompt e alla piattaforma utilizzata, con un intervallo tipico tra nove e undici sotto-query correlate per una singola domanda complessa.
Come vengono combinate le fonti raccolte dal fan-out?
Le fonti recuperate dalle diverse sotto-query vengono unite e riordinate con una tecnica di fusione dei ranking, che assegna un peso maggiore alle fonti che ricorrono in più diramazioni della ricerca parallela.
Il fan-out delle query AI è collegato alle query dei database?
No: condivide solo il nome. Le interrogazioni su database relazionali estraggono record da tabelle tramite criteri espliciti, mentre il fan-out qui descritto recupera frammenti testuali da fonti eterogenee per comporre una risposta in linguaggio naturale.
Come si struttura un contenuto per essere incluso nella sintesi generata dal fan-out?
Organizzando il testo in paragrafi autosufficienti con risposta diretta in apertura, coprendo più angolazioni dello stesso tema su pagine collegate tra loro secondo un’architettura hub-and-spoke, ed evitando la ripetizione dello stesso attributo su più pagine.
Come si verificano le sotto-query effettive generate per un prompt?
Osservando i parametri di ricerca restituiti dal sistema generativo durante l’elaborazione della risposta, non stimandoli in anticipo: si tratta di un dato osservabile caso per caso, non di un valore fisso applicabile a ogni prompt.
