Embedding e database vettoriali

Articoli e guide su Embedding e database vettoriali: cos'è, come funziona e come si usa, con esempi pratici e risposte alle domande più comuni. Per il quadro completo c'è la pagina dedicata a Intelligenza artificiale.

Database vettoriale: cos’è e come funziona
Embedding e database vettoriali 10 Ottobre 2026

Database vettoriale: cos’è e come funziona

Un database vettoriale è un sistema di archiviazione che memorizza dati come vettori numerici e li recupera per somiglianza semantica anziché per corrispondenza esatta. A differenza dei database relazionali, utilizza embedding e metriche di distanza per trovare risultati pertinenti in millisecondi, anche su milioni di elementi.
Embedding nella GEO: significato e funzionamento
Embedding e database vettoriali 30 Settembre 2026

Embedding: significato e funzionamento

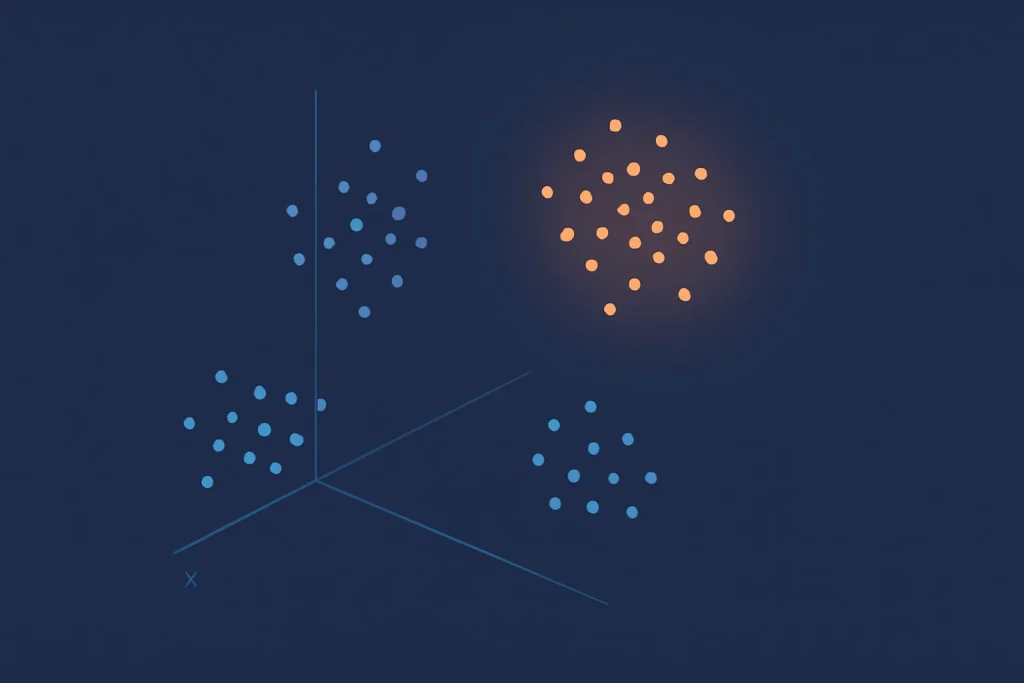
Un embedding è la rappresentazione numerica di un contenuto testuale, visivo o sonoro sotto forma di vettore in uno spazio multidimensionale, usata dai motori generativi per confrontare il significato dei contenuti. Gli embedding colmano la distanza tra il linguaggio naturale e l’elaborazione numerica, permettendo alle reti neurali di manipolare matematicamente i contenuti mantenendo intatte le relazioni semantiche.

Chunk nell’intelligenza artificiale: definizione e funzionamento nel RAG
Embedding e database vettoriali 30 Settembre 2026

Chunk nell’intelligenza artificiale: definizione e funzionamento nel RAG

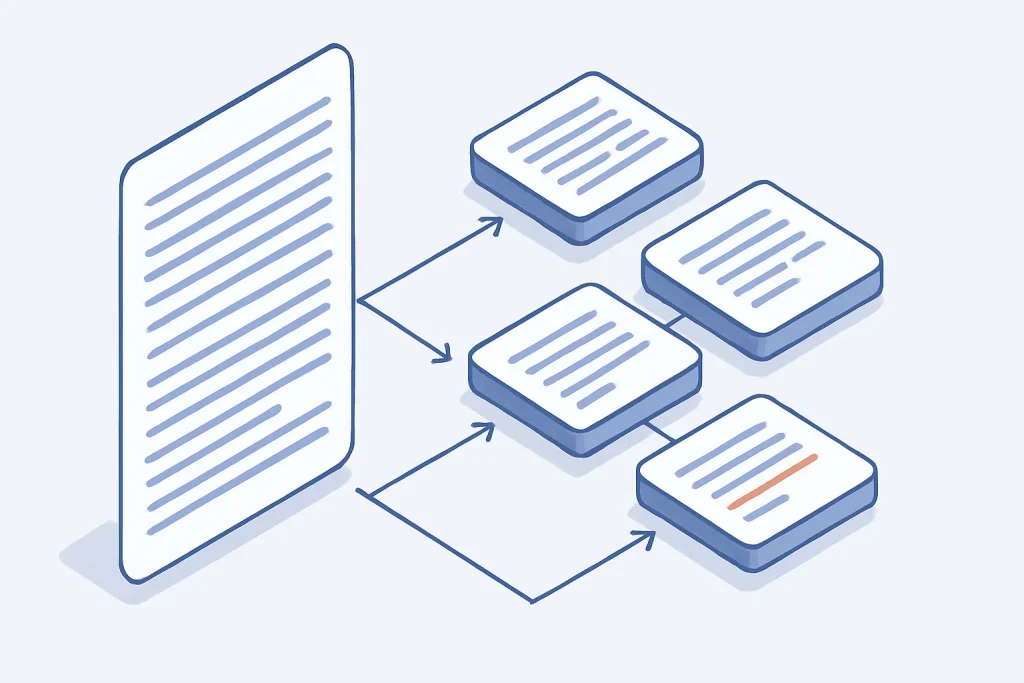
Un chunk è una porzione di testo in cui un documento viene suddiviso prima di essere indicizzato in un sistema di ricerca semantica, per rendere più precisi il recupero delle informazioni e la generazione delle risposte. La segmentazione corretta dei chunk determina direttamente quanto il sistema riuscirà a trovare l’informazione corretta quando l’utente formula una domanda.

Information retrieval: definizione e funzionamento
Embedding e database vettoriali 29 Settembre 2026

Information retrieval: definizione e funzionamento

L’information retrieval è la disciplina informatica che studia le tecniche per rappresentare, indicizzare e recuperare documenti non strutturati a partire da un bisogno informativo espresso in linguaggio naturale. Un sistema di IR funziona attraverso quattro fasi collegate: raccolta dei documenti, indicizzazione, formulazione della query e confronto con ranking finale.