
Chunk nell’intelligenza artificiale: definizione e funzionamento nel RAG

Un chunk nell’ambito dell’intelligenza artificiale è una porzione di testo in cui un documento viene suddiviso prima di essere indicizzato in un sistema di recupero semantico, per rendere più precisi il recupero delle informazioni e la generazione delle risposte. In questa pagina il termine indica esclusivamente questo significato: altri usi (informatica generale, videogiochi, psicologia, linguistica) restano fuori tema.
In breve
- Cosa risolve: il chunk permette di scomporre documenti lunghi in unità gestibili da un motore di ricerca semantica.
- Quando si applica: nella fase di indicizzazione di un sistema RAG, prima della conversione in vettori numerici.
- Condizioni e limiti: un dimensionamento scorretto riduce la precisione del recupero, indipendentemente dalla qualità del modello generativo.
- Come verificare: si valuta testando domande reali e osservando se i passaggi recuperati contengono davvero la risposta cercata.
- Cosa fare: calibrare la dimensione del chunk in base al tipo di documento e mantenere un margine di sovrapposizione tra un blocco e l’altro.
Cos’è un chunk nell’intelligenza artificiale
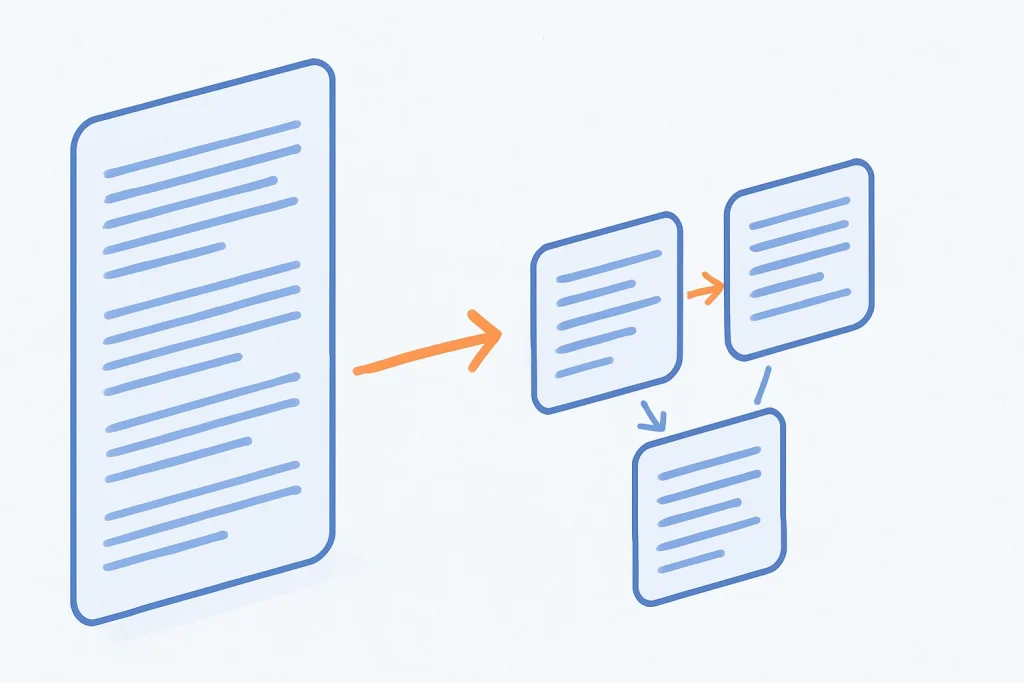
Nel contesto dei modelli linguistici e dei sistemi di Retrieval-Augmented Generation (RAG), il chunk è l’unità minima con cui un contenuto testuale viene reso disponibile alla ricerca. Ogni documento lungo — un manuale, una policy, una raccolta di FAQ — viene frammentato in segmenti coerenti che mantengono un senso compiuto anche letti isolatamente.
Questa suddivisione non è un dettaglio tecnico marginale: determina direttamente quanto il sistema riuscirà a trovare l’informazione corretta quando l’utente formula una domanda con parole diverse da quelle del documento originale. Un blocco troppo ampio diluisce il significato specifico cercato; uno troppo ristretto lo isola dal contesto che lo rende comprensibile.
Il processo di creazione dei chunk prende il nome di chunking ed è la prima operazione della catena di indicizzazione: precede la trasformazione di ogni segmento in un embedding, cioè una rappresentazione numerica del suo significato, utilizzata poi per confrontare la domanda dell’utente con i contenuti disponibili. Un modello linguistico di grandi dimensioni (LLM) riceve infine solo i chunk giudicati pertinenti, non l’intero documento, e li usa come base per costruire la risposta.
La logica del chunk in questo ambito condivide un principio comune ad altri usi del termine in informatica e psicologia — organizzare informazioni in unità più gestibili — ma con una finalità propria: massimizzare la probabilità che, data una domanda, il sistema recuperi esattamente il passaggio che la risolve, senza rumore e senza perdita di contesto.
Come funziona la segmentazione dei documenti nel RAG
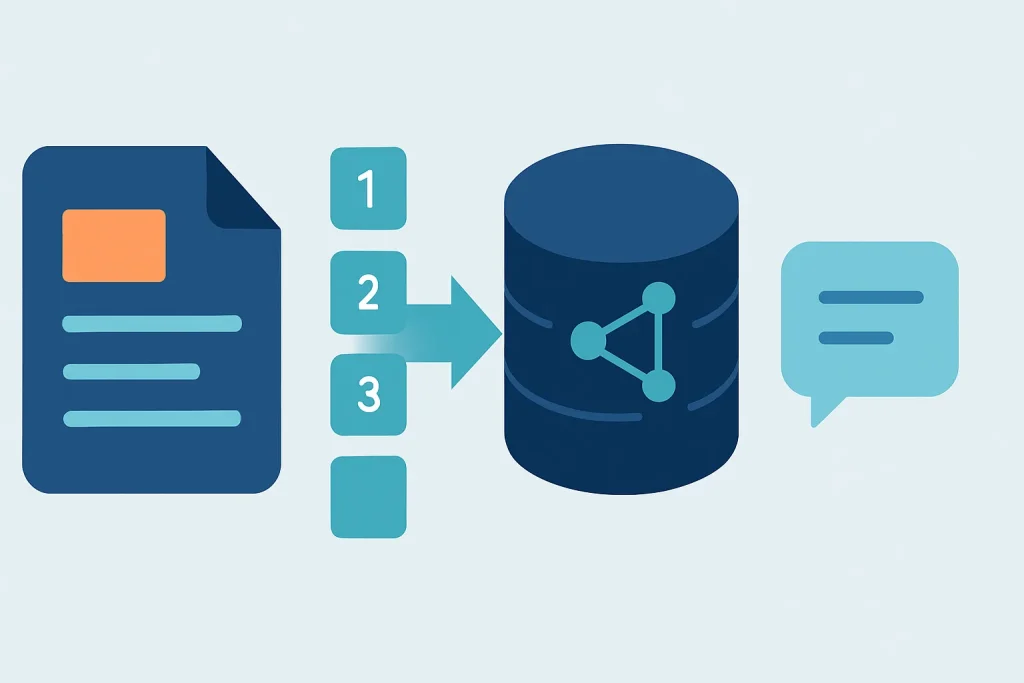
Il chunking in un sistema di intelligenza artificiale documentale segue una sequenza precisa, in cui ogni fase condiziona la qualità di quella successiva.
- Raccolta e pulizia dei documenti sorgente: eliminazione di duplicati, normalizzazione della formattazione e organizzazione in sezioni logiche.
- Suddivisione in chunk: il testo viene frazionato in porzioni omogenee, spesso definite da limiti naturali come paragrafi o titoli, così da preservare unità di senso.
- Vettorializzazione: ogni chunk viene convertito in un embedding, un insieme di valori numerici che ne rappresenta il significato semantico.
- Indicizzazione: gli embedding vengono archiviati in una base vettoriale interrogabile per similarità.
- Recupero: alla domanda dell’utente corrisponde una ricerca dei chunk più vicini semanticamente, non solo per corrispondenza letterale di parole.
- Generazione: il modello linguistico riceve la domanda insieme ai chunk recuperati e costruisce la risposta finale basandosi su quel contenuto.
A differenza di una semplice ricerca per parole chiave, la segmentazione in chunk permette al sistema di individuare un passaggio pertinente anche quando la formulazione della domanda non coincide con il testo originale: è la combinazione tra confini di chunk ben scelti e qualità dell’embedding a rendere possibile questo risultato, non uno solo dei due fattori.
Un aspetto spesso sottovalutato riguarda la sovrapposizione tra chunk consecutivi: mantenere una porzione di testo condivisa tra un blocco e il successivo riduce il rischio di spezzare una frase o un concetto esattamente nel punto in cui inizia l’informazione utile, un problema che una segmentazione rigida e priva di margini tende a produrre con maggiore frequenza.
Quanto deve essere grande un chunk
Non esiste una dimensione fissa valida per ogni caso: la misura corretta di un chunk dipende dal tipo di documento, dalla lunghezza media delle domande attese e dal margine di contesto che il modello generativo può gestire in un’unica richiesta.
| Caratteristica | Chunk di piccole dimensioni | Chunk di grandi dimensioni |
|---|---|---|
| Precisione del recupero | Alta: isola informazioni specifiche | Bassa: mescola più argomenti nello stesso blocco |
| Contesto disponibile | Rischio di frasi isolate dal senso generale | Contesto ampio ma spesso ridondante |
| Numero di chunk da indicizzare | Elevato, con maggiore carico sul database vettoriale | Ridotto, ma con risposte meno mirate |
Se il chunk è troppo piccolo: risposta priva di contesto
Se scegli una dimensione ridotta per ogni blocco, il sistema riuscirà a individuare con precisione la frase pertinente, ma rischia di restituirla priva del riferimento che ne chiarisce il significato: in questo caso conviene aumentare leggermente l’ampiezza del chunk o mantenere una sovrapposizione con il blocco precedente.
Se il chunk è troppo grande: recupero impreciso
Se invece i blocchi coprono più argomenti insieme, la ricerca semantica tenderà a recuperare passaggi solo parzialmente pertinenti, perché il significato complessivo del chunk risulta diluito: in questo caso conviene ridurre la dimensione del segmento o suddividerlo secondo confini tematici più stretti, come i singoli paragrafi.
Errori frequenti nella gestione dei chunk
Al di là della dimensione, alcuni errori ricorrenti compromettono l’efficacia di un sistema basato su chunk, anche quando la segmentazione di partenza è corretta.
- Documenti sorgente disordinati: una base documentale incompleta o priva di struttura produce chunk poco coerenti, indipendentemente da quanto sia accurato l’algoritmo di segmentazione.
- Assenza di sovrapposizione tra blocchi: confini troppo netti tra un chunk e l’altro possono spezzare un concetto a metà, rendendolo irrecuperabile per intero.
- Fonti non aggiornate: un sistema che indicizza chunk provenienti da documenti obsoleti restituisce risposte formalmente corrette ma operativamente sbagliate.
- Mancanza di filtri sui contenuti: senza criteri di accesso o esclusione, chunk provenienti da fonti non autorizzate possono comparire nelle risposte generate.
- Assenza di verifica sistematica: senza test periodici con domande reali, un peggioramento nella qualità del recupero può passare inosservato a lungo.
Ognuno di questi problemi si presenta in una fase diversa del processo — preparazione dei dati, segmentazione, indicizzazione o manutenzione — e per questo richiede una verifica separata: correggere solo la dimensione del chunk non risolve un problema legato a fonti disordinate o non aggiornate.
Domande frequenti
Cos’è un chunk nell’intelligenza artificiale?
È una porzione di testo in cui un documento viene diviso per essere indicizzato in un sistema di ricerca semantica. Ogni chunk mantiene un senso compiuto e viene convertito in un embedding, la rappresentazione numerica usata per confrontarlo con le domande degli utenti.
Cosa significa “chunking” in italiano?
Chunking indica il processo di suddivisione di un contenuto in blocchi più piccoli e gestibili. Nell’intelligenza artificiale si applica ai documenti prima dell’indicizzazione, per permettere un recupero delle informazioni più mirato rispetto a una ricerca sull’intero testo.
Quanto è grande un chunk?
Non esiste una misura unica: la dimensione varia in base al tipo di documento e alla lunghezza delle domande attese. Blocchi troppo piccoli isolano le informazioni dal contesto, blocchi troppo grandi riducono la precisione del recupero.
Cosa succede se i chunk sono troppo piccoli o troppo grandi?
Con chunk troppo piccoli il sistema trova la frase esatta ma perde il contesto che la spiega. Con chunk troppo grandi il recupero diventa meno preciso, perché ogni blocco contiene più argomenti mescolati tra loro.
Che ruolo hanno gli embedding nel chunking?
Ogni chunk viene trasformato in un embedding, un insieme di valori numerici che ne rappresenta il significato. È questo confronto numerico, e non la corrispondenza letterale di parole, a permettere al sistema di trovare il blocco più pertinente rispetto a una domanda.
Quali errori evitare nella segmentazione dei documenti?
Gli errori più frequenti riguardano documenti sorgente disordinati, assenza di sovrapposizione tra blocchi consecutivi, fonti non aggiornate e mancanza di verifiche periodiche sulla qualità del recupero delle risposte generate dal sistema.
Chunking e tokenizzazione sono la stessa cosa?
No: la tokenizzazione scompone il testo in unità minime elaborabili dal modello linguistico, mentre il chunking definisce porzioni di testo più ampie e dotate di senso compiuto, destinate all’indicizzazione e al recupero semantico prima della generazione della risposta.
