
Cosa sono i contenuti duplicati e come influenzano la SEO

I contenuti duplicati sono testi, immagini o porzioni di codice che compaiono in modo identico o quasi identico su più URL, interno allo stesso sito o esterno su domini differenti. Il problema nasce perché Google deve scegliere quale versione mostrare in SERP, e quella scelta non sempre coincide con la pagina che per te conta di più.
Contenuti duplicati: cosa fare ora
- Cosa sono: testi o pagine identiche o molto simili presenti su più URL, interni o esterni al sito.
- Perché contano per la SEO: creano confusione nella scelta della pagina da indicizzare e disperdono link equity e crawl budget.
- Cause più comuni: parametri URL, versioni www/non-www e http/https, tag e categorie sovrapposti, copie esterne via scraping o syndication.
- Come si individuano: scansione del sito con tool dedicati, comando site: su Google e verifica in Search Console.
- Come si risolvono: canonical o redirect 301 per i duplicati interni, noindex per le pagine che non devono comparire in SERP.
- Rischio penalizzazione: esiste solo in caso di copia sistematica o intento manipolatorio, legato all’aggiornamento Panda.
Cosa sono i contenuti duplicati e dove si trovano
Un contenuto duplicato esiste quando lo stesso testo, la stessa scheda prodotto o lo stesso blocco di codice compare su più indirizzi web: può succedere interno allo stesso sito, per esempio tra la versione con e senza www, oppure esterno su domini differenti, quando un altro sito pubblica una copia del tuo articolo. La distinzione conta perché cambia lo strumento da usare: dentro il sito si lavora con canonical e redirect, fuori dal sito la gestione cambia del tutto.
Il tema fa parte della SEO tecnica, l’area che si occupa di come un sito viene scansionato e indicizzato prima ancora che dei suoi contenuti. Un esempio ricorrente: un e-commerce che genera lo stesso elenco prodotti su /categoria/scarpe e su /scarpe?ordine=prezzo. Per Google sono due pagine diverse con lo stesso contenuto, non una pagina sola vista in due modi.
Non serve che il testo sia identico al cento per cento: Google considera duplicato anche un contenuto molto simile, con qualche parola cambiata. Riscrivere due frasi di un paragrafo non basta a renderlo originale agli occhi del motore di ricerca.
Capita anche con contenuti copiati di proposito: chi fa scraping prende articoli interi e li ripubblica altrove, a volte con piccoli ritocchi automatici. In questo caso il duplicato è esterno e nasce da un’azione che il tuo sito non controlla.
Perché i contenuti duplicati sono un problema per la SEO
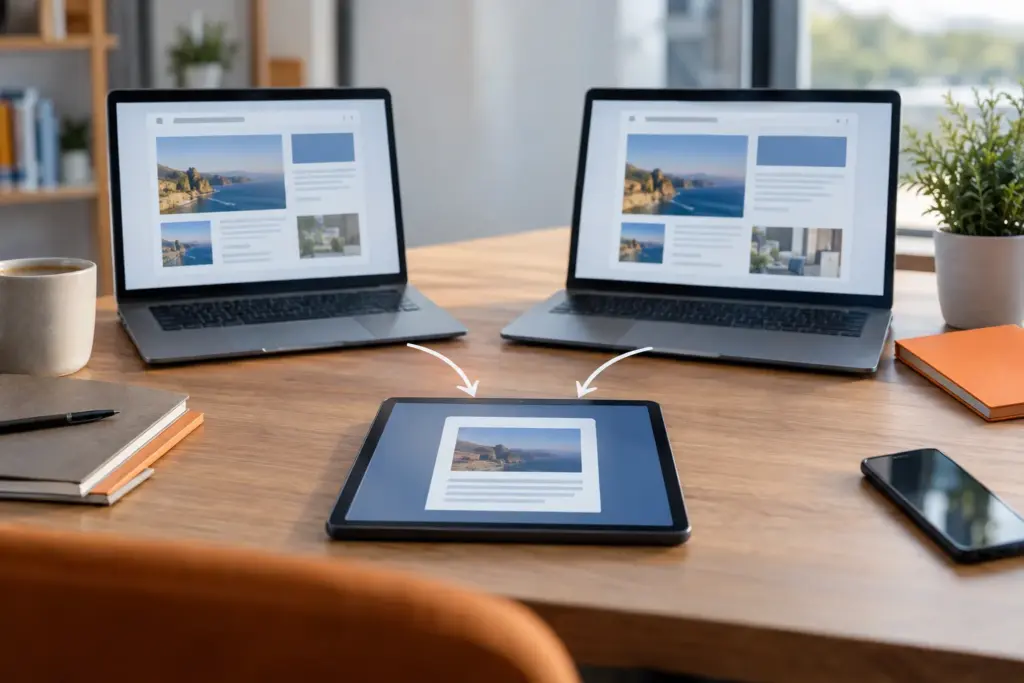
Google deve scegliere quale delle pagine uguali mostrare in SERP, e quella scelta non sempre coincide con la pagina che per te conta di più. È questo il primo effetto della duplicazione: confusione nella selezione della versione da indicizzare, non una penalità diretta.
Il secondo effetto riguarda il valore dei link. Se due pagine duplicate ricevono link diversi, quel valore – i professionisti lo chiamano link equity – si divide tra le due invece di sommarsi su una sola. Una pagina che riceve tutti i link in ingresso si posiziona meglio di una che li divide con un duplicato.
C’è poi il crawl budget, il tempo che Googlebot dedica a scansionare il tuo sito: se lo spende su cento varianti della stessa pagina prodotto, scansiona più tardi le pagine nuove che ti servirebbe far indicizzare subito. Su un sito con poche centinaia di URL l’effetto si nota meno; su un e-commerce con migliaia di varianti e filtri, pesa parecchio.
Sul fronte della penalizzazione la situazione è più chiara di quanto si creda: duplicare qualche pagina per errore porta Google a scartare le copie dai risultati, non a punire il sito. La penalizzazione vera arriva con l’aggiornamento Panda, attivo dal 2011, e colpisce chi copia contenuti in modo sistematico o prova a manipolare il posizionamento organico sui motori con pagine create apposta per duplicare testo altrui. Conviene sempre distinguere queste due situazioni: un conto è il doppione tecnico da sistemare, un altro è un sito costruito sulla copia.
Cause più comuni della duplicazione dei contenuti
Nella maggior parte dei siti il duplicato non nasce da un copia-incolla: nasce dalla tecnica. Dominio con e senza www, versione http e https, parametri di sessione o di tracciamento in coda all’URL: per un lettore sono la stessa pagina, per un motore di ricerca sono indirizzi diversi finché non gli dici il contrario.
Sul lato editoriale la causa più frequente è la sovrapposizione tra tag e categorie di un blog, o tra pagine che rispondono allo stesso intento di ricerca con parole diverse: due articoli che vogliono posizionarsi per la stessa domanda finiscono per competere tra loro invece di sommare autorità. Una migrazione SEO gestita senza una mappa di redirect produce lo stesso effetto: vecchi URL ancora online insieme ai nuovi, entrambi indicizzati con lo stesso contenuto.
Quando il sito ha una versione multilingua, la soluzione non passa dal canonical ma dal tag hreflang, che segnala a Google varianti linguistiche legittime invece di copie da scartare. Un discorso simile vale per i filtri e gli ordinamenti di un e-commerce, dove conviene partire da una lettura chiara degli url parametrizzati prima di decidere quali far indicizzare.
Sul lato esterno, le cause più comuni restano lo scraping automatico, la syndication mal gestita – quando un partner pubblica il tuo articolo per intero invece di un estratto – e le schede prodotto standard che il fornitore distribuisce a decine di rivenditori, identiche su ogni sito che le usa senza riscriverle. È anche tra gli errori di SEO tecnica più comuni, perché compare spesso insieme a redirect mal gestiti e pagine lente.
| Tipo | Esempio tipico | Intervento consigliato |
|---|---|---|
| Duplicato interno tecnico | www/non-www, http/https, URL con parametri | canonical o redirect 301 |
| Duplicato interno editoriale | due pagine sullo stesso search intent | unione delle pagine o riscrittura mirata |
| Duplicato esterno da copia | un sito ripubblica il tuo testo integrale | richiesta di rimozione o segnalazione a Google |
| Duplicato esterno da fornitore | scheda prodotto standard usata da più rivenditori | riscrittura della descrizione |
Come riconoscere i contenuti duplicati sul tuo sito
Il controllo parte da due fronti diversi: il tuo sito verso se stesso, e il tuo sito verso il resto del web. Per il primo, Screaming Frog è uno strumento efficace: scansiona l’intero sito e segnala title, meta description e H1 ripetuti identici su più URL, un indizio quasi sempre affidabile di contenuto duplicato.
Per un controllo rapido senza installare nulla, il comando site: seguito da una frase tra virgolette del tuo testo mostra se Google ha indicizzato più di una copia della stessa pagina. Se la ricerca restituisce un avviso che invita a ripetere la query includendo i risultati omessi, è un altro segnale della stessa natura.
Per verificare se qualcun altro ha copiato i tuoi testi servono strumenti diversi: Copyscape confronta un URL con l’intero web e nella versione a pagamento costa 0,05 dollari a ricerca; Duplichecker e Plagium funzionano in modo simile, incollando il testo da controllare invece dell’indirizzo. Nessuno di questi sostituisce un’analisi tecnica del sito più ampia, che considera anche redirect, canonical e struttura degli URL insieme ai testi.
Come risolvere e prevenire i contenuti duplicati
La sequenza per risolvere un contenuto duplicato è generalmente la stessa, cambia solo lo strumento finale:
- Individuo le pagine coinvolte con uno strumento di scansione del sito o con il comando site:.
- Decido quale versione deve restare visibile nei risultati, di solito quella con più link o più traffico.
- Applico il tag canonical se entrambe le pagine devono restare online, oppure un redirect 301 se una delle due non serve più.
- Controllo in Search Console, nel rapporto sulla copertura dell’indice, che Google abbia recepito la scelta nelle settimane successive.
Se il duplicato è interno al tuo sito
Se le pagine duplicate sono entrambe tue, la soluzione è quasi sempre tecnica. Usa il tag canonical per contenuti duplicati quando ti serve mantenere online entrambe le versioni, per esempio un filtro e-commerce utile agli utenti, e passa al redirect 301 quando una delle due pagine non ha più motivo di esistere.
Se il duplicato è su un altro dominio
Se la copia è su un sito che non controlli, canonical e redirect non servono: la pagina copiata non è sotto il tuo CMS. In questo caso l’intervento si sposta dalla tecnica alla gestione del rapporto con chi ha copiato, come vedo più avanti.
Per le pagine che devono esistere ma non devono comparire tra i risultati di ricerca – archivi interni, pagine di ringraziamento, versioni di stampa – il meta tag noindex evita che vengano trattate come duplicati da filtrare: resta accessibile agli utenti ma esce dall’indice.
Su WordPress il punto più trascurato è l’excerpt: se la home page o gli archivi richiamano l’articolo per intero invece di un estratto, quel testo risulta duplicato rispetto alla pagina originale. Basta compilare il campo riassunto e attivare il tag “more” per evitarlo. Lo stesso vale per biografie e note di copyright ripetute identiche in calce a ogni articolo: meglio un richiamo breve con link alla pagina completa.
Cosa fare se qualcuno copia i tuoi contenuti
La prima mossa, quella che consiglio sempre prima di qualunque segnalazione formale, è un contatto diretto: scrivere a chi ha copiato chiedendo la rimozione o una riscrittura sostanziale, spiegando che la duplicazione danneggia entrambi i siti agli occhi di Google. Nella maggior parte dei casi basta, specie quando la copia non è intenzionale.
Se non risponde o rifiuta, restano tre strade verso Google: la segnalazione base di contenuto copiato, quella per violazione di copyright e quella per spam. Per le copie più gravi, sistematiche o commerciali, la via legale resta percorribile, ma è l’ultima opzione, non la prima.
Contenuti duplicati e intelligenza artificiale
Il problema nasce quando un testo scritto con l’IA resta quello uscito dal modello, perché più strumenti tendono a formulare le stesse frasi davanti alla stessa richiesta, e quelle frasi finiscono identiche su siti diversi.
Conviene usare l’IA come prima stesura, mai come versione finale: aggiungere un caso concreto, un dato verificato o un esempio legato al settore del cliente prima di pubblicare. È il passaggio che trasforma un testo plausibile in un contenuto che vale la pena indicizzare.
Quando il duplicato non è davvero un problema
Non ogni somiglianza tra due pagine va corretta. Nessuna fonte tecnica fissa una soglia precisa di somiglianza oltre la quale Google tratta due testi come copie: due pagine con la stessa struttura ma informazioni specifiche diverse – due città, due modelli di prodotto – di solito convivono senza problemi, mentre due pagine che cambiano solo qualche aggettivo no.
Quando due pagine del tuo sito rispondono allo stesso intento di ricerca, la scelta è tra due strade: unirle con un redirect 301 verso quella più completa, oppure differenziarle aggiungendo contenuto specifico a ciascuna, così da coprire due ricerche realmente diverse invece di una sola ricerca scritta due volte.
Per le varianti di un prodotto – taglia, colore, formato – la soluzione dipende dal volume di ricerche: se le persone cercano proprio quella variante specifica, vale la pena differenziarla con informazioni dedicate; se la ricerca riguarda il prodotto in generale, meglio gestirla con canonical verso la pagina principale e lasciare le varianti come semplici opzioni di acquisto.
Sui tempi di recupero dopo una correzione non esiste un numero valido per tutti i siti: dipende dalla frequenza con cui Googlebot scansiona quelle pagine. Per saperlo basta controllare in Search Console, nel rapporto sulla copertura dell’indice, quando la pagina corretta viene letta di nuovo.
Domande frequenti sui contenuti duplicati
Cosa sono i contenuti duplicati?
Sono testi, immagini o pagine che compaiono identici o molto simili su più URL, dentro lo stesso sito o su domini diversi. Google deve scegliere quale versione mostrare, e questa scelta non sempre coincide con la pagina che per te conta di più.
Google penalizza i contenuti duplicati?
Di norma no: Google filtra le copie e ne mostra una sola nei risultati, senza penalizzare il sito. La penalizzazione, legata all’aggiornamento Panda, colpisce solo chi copia in modo sistematico o cerca di manipolare il posizionamento con pagine create per duplicare contenuti altrui.
Che differenza c’è tra duplicato interno ed esterno?
Il duplicato interno riguarda due URL dello stesso sito, per esempio per via di www/non-www o di parametri in coda all’indirizzo, e si risolve con canonical o redirect. Il duplicato esterno riguarda un altro dominio e richiede un intervento diverso, dalla richiesta di rimozione alla segnalazione a Google.
Come si individuano i contenuti duplicati su un sito?
Con una scansione completa del sito, che segnala title, meta description e H1 ripetuti su più URL, oppure con il comando site: su Google per vedere se una stessa frase risulta indicizzata più volte.
Meglio canonical o redirect 301 per un contenuto duplicato?
Dipende da cosa deve succedere alla pagina in più: il canonical si usa quando entrambe le versioni devono restare online, il redirect 301 quando una delle due pagine non serve più e va eliminata in favore dell’altra.
I testi scritti con l’IA generano contenuti duplicati?
Il rischio nasce se il testo resta quello generato dal modello senza revisione, perché più strumenti producono frasi simili davanti alla stessa richiesta.
Cosa fare se qualcuno copia i miei contenuti?
Prima si contatta chi ha copiato chiedendo la rimozione, poi, se non risponde, si procede con una segnalazione a Google per contenuto copiato o violazione di copyright. Le vie legali restano percorribili per i casi più gravi.
Le descrizioni prodotto uguali a quelle del fornitore sono un problema?
Sì, se restano identiche a quelle usate da altri rivenditori: per Google sono un duplicato esterno a tutti gli effetti. Riscriverle con informazioni specifiche sul proprio catalogo è la soluzione più stabile nel tempo.
