
Database relazionale: cos’è e come funziona

Un database relazionale è un sistema che organizza i dati in tabelle collegate tra loro tramite chiavi, permettendo di interrogarle con il linguaggio SQL e di mantenere l’integrità delle informazioni attraverso le proprietà ACID. Il modello nasce dall’applicazione della teoria degli insiemi alla gestione dei dati strutturati.
Database relazionale in sintesi
- Struttura: i dati sono organizzati in tabelle composte da righe e colonne.
- Collegamenti: le tabelle si uniscono tramite chiavi primarie ed esterne.
- Linguaggio: l’interrogazione e la modifica dei dati avvengono tramite SQL.
- Affidabilità: le transazioni rispettano le proprietà ACID.
- Origine: il modello è stato proposto da Edgar F. Codd nel 1970.
- Alternativa: per dati non strutturati o schema flessibile si ricorre ai database NoSQL.
Cos’è un database relazionale
Un archivio di dati relazionale rappresenta le informazioni come un insieme di tabelle indipendenti, ciascuna dedicata a un’entità specifica come clienti, ordini o prodotti, e collegate tra loro attraverso identificatori comuni. Questa impostazione permette di evitare la ripetizione delle stesse informazioni in più punti e di recuperare dati incrociando più tabelle in un’unica interrogazione.
Il modello è stato proposto da Edgar F. Codd nel 1970 e si fonda sulla teoria degli insiemi e sulla logica del primo ordine: ogni tabella corrisponde a una relazione matematica, ogni riga a una tupla e ogni colonna a un attributo con un dominio di valori ammessi. Questa base teorica garantisce che l’accesso ai dati segua regole prevedibili, indipendenti dal modo in cui i dati sono fisicamente memorizzati su disco.
A differenza di un semplice elenco o di un foglio di calcolo, un sistema relazionale applica vincoli di integrità: ogni tabella deve avere un identificatore univoco, i riferimenti tra tabelle devono puntare a righe esistenti e i tipi di dato devono rispettare lo schema definito. Il software che implementa queste regole e gestisce letture, scritture e indicizzazione prende il nome di RDBMS, sistema di gestione di basi di dati relazionali.
I casi d’uso tipici riguardano contesti in cui la coerenza dei dati è prioritaria rispetto alla velocità di scrittura massiva: gestione di anagrafiche clienti, contabilità, inventari, prenotazioni e qualsiasi applicazione in cui una riga errata o duplicata comprometterebbe l’affidabilità del sistema. Per i volumi di dati non strutturati o per schemi che cambiano di frequente, si valuta invece un database NoSQL, pensato per una flessibilità di schema diversa da quella relazionale.
Struttura e componenti chiave
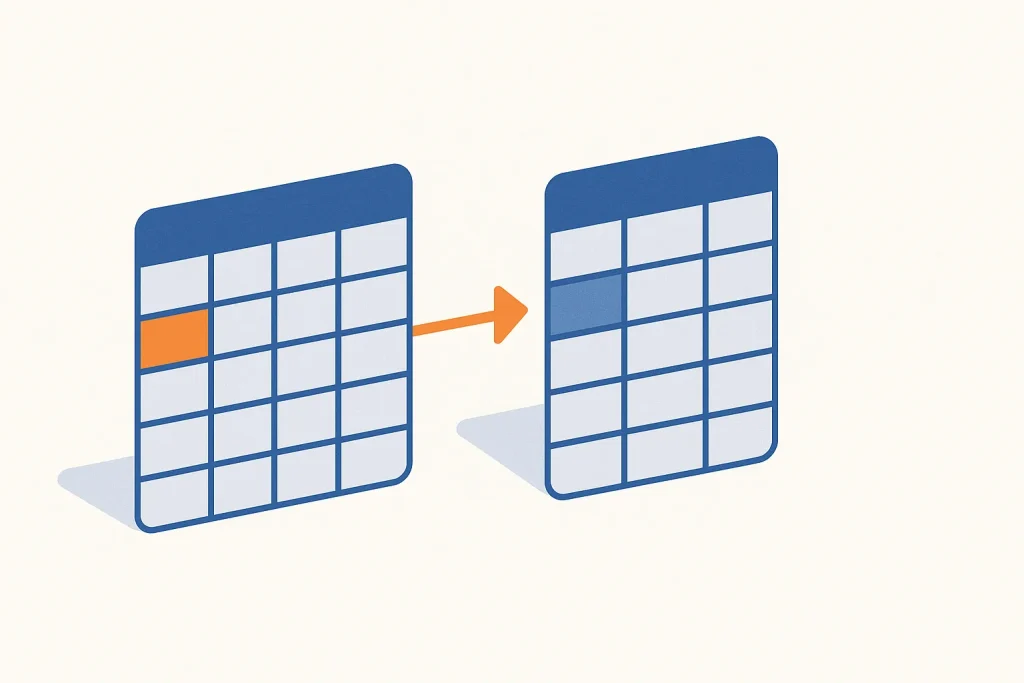
Ogni tabella, detta anche relazione, rappresenta un’entità come Clienti, Prodotti o Ordini ed è composta da righe e colonne. Le righe, chiamate anche tuple o record, corrispondono a un’istanza singola di quell’entità: un cliente specifico, un ordine specifico. Le colonne, o attributi, descrivono le proprietà di ogni record, come nome, indirizzo o data dell’ordine.
La chiave primaria è la colonna, o l’insieme di colonne, che identifica senza ambiguità ogni riga della tabella: in una tabella Clienti, l’ID cliente non può ripetersi. Quando più colonne potrebbero svolgere questo ruolo si parla di chiavi candidate; quella scelta come identificatore ufficiale diventa la chiave primaria, mentre le altre restano chiavi alternative. Se un singolo campo non basta a garantire l’unicità, si ricorre a una chiave composita, formata dalla combinazione di più colonne.
La chiave esterna è una colonna che riporta il valore della chiave primaria di un’altra tabella, creando così il legame logico tra le due strutture: una tabella Ordini contiene una colonna ID_Cliente che rimanda alla tabella Clienti, stabilendo una relazione che può essere uno a uno, uno a molti o molti a molti a seconda di come i record si associano tra loro.
Lo schema definisce in anticipo quali colonne compongono ogni tabella, quali tipi di dato accettano e quali vincoli devono rispettare, ad esempio l’obbligo di un valore non nullo o l’unicità di un campo. Questa rigidità, spesso percepita come un limite, è in realtà ciò che garantisce la coerenza dei dati nel tempo.
Per velocizzare il recupero delle informazioni senza scansionare l’intera tabella, i sistemi relazionali costruiscono indici: strutture che memorizzano i valori di una colonna insieme a un riferimento alla riga corrispondente. Le due strutture più diffuse sono l’albero B, che mantiene l’ordinamento dei valori e si adatta bene a ricerche per intervallo, e la tabella hash, più efficiente per le ricerche di corrispondenza esatta ma meno adatta a query che richiedono un ordine.
Linguaggio SQL
L’interrogazione e la modifica dei dati in un database relazionale avvengono tramite SQL, acronimo di Structured Query Language, un linguaggio dichiarativo che permette di descrivere quale risultato si vuole ottenere senza specificare come il motore debba calcolarlo internamente.
Le operazioni principali si dividono in due categorie: quelle che definiscono la struttura del database, come la creazione o la modifica di una tabella, e quelle che agiscono sui dati contenuti, cioè la selezione, l’inserimento, l’aggiornamento e la cancellazione di righe. Una query che unisce dati provenienti da più tabelle, ad esempio per abbinare ogni ordine al nome del cliente che lo ha effettuato, si realizza attraverso un’operazione di join, che sfrutta proprio le chiavi esterne descritte nella sezione precedente.
La standardizzazione del linguaggio consente di spostare competenze e logiche applicative da un sistema all’altro con adattamenti minimi: la sintassi di base resta comune a MySQL, PostgreSQL, Oracle Database e Microsoft SQL Server, anche se ciascun motore aggiunge estensioni proprietarie per funzioni avanzate.
Proprietà ACID
Le transazioni in un database relazionale rispettano quattro garanzie raccolte nell’acronimo ACID, pensate per assicurare che ogni operazione si concluda in modo affidabile anche in presenza di errori hardware, interruzioni o accessi simultanei.
- Atomicità
- Una transazione viene eseguita per intero oppure annullata completamente: non esistono stati intermedi parzialmente applicati.
- Coerenza
- Il database passa sempre da uno stato valido a un altro stato valido, rispettando vincoli e regole definiti nello schema.
- Isolamento
- Più transazioni eseguite contemporaneamente producono lo stesso risultato che si otterrebbe eseguendole una dopo l’altra.
- Durabilità
- Una volta confermata, una transazione resta memorizzata in modo permanente anche in caso di guasto successivo del sistema.
Queste garanzie sono il motivo per cui i sistemi relazionali restano la scelta predefinita in ambiti dove un errore di aggiornamento ha conseguenze dirette, come i movimenti bancari, la fatturazione o la gestione degli ordini in un e-commerce: un pagamento che aggiorna due conti diversi deve riuscire o fallire interamente, mai lasciare un conto addebitato e l’altro non accreditato.
Database relazionali vs non relazionali (NoSQL)
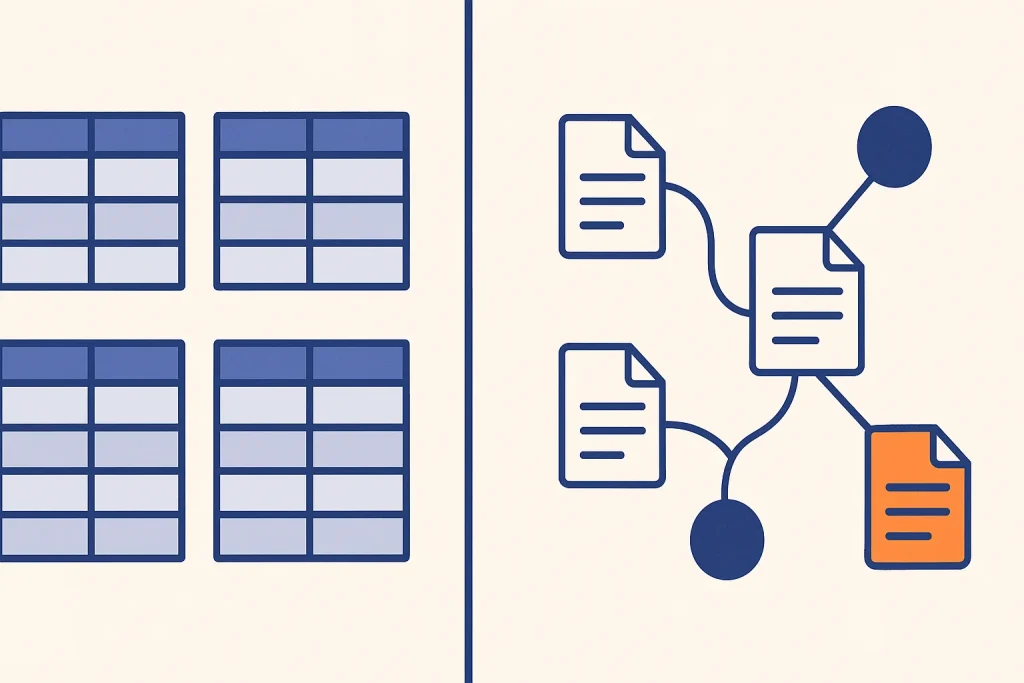
La scelta tra i due modelli dipende dal tipo di dato da gestire e dal compromesso che si vuole ottenere tra coerenza e capacità di scalare su più server. Se i dati hanno una struttura stabile e prevedibile e serve la massima garanzia di coerenza, un sistema relazionale resta la soluzione più solida; se i dati sono semi-strutturati, variano frequentemente di forma o devono essere distribuiti su larga scala, un database NoSQL offre maggiore flessibilità di schema e scalabilità orizzontale.
| Caratteristica | Database relazionale (SQL) | Database non relazionale (NoSQL) |
|---|---|---|
| Struttura dei dati | Tabellare, con schema fisso definito in anticipo | Flessibile: documenti, coppie chiave-valore, colonne o grafi |
| Linguaggio | SQL, standardizzato tra i diversi motori | Varia per ogni sistema, spesso API proprietarie |
| Integrità | Garanzia rigorosa tramite proprietà ACID | Spesso coerenza eventuale, secondo il modello BASE |
| Scalabilità | Prevalentemente verticale, con hardware più potente | Orizzontale, distribuita su più server |
Il principio che spiega questo compromesso è noto come teorema CAP: un sistema distribuito può garantire pienamente solo due proprietà fra coerenza, disponibilità e tolleranza di partizione. I sistemi relazionali privilegiano tipicamente la coerenza, rispondendo con un errore o un nuovo tentativo piuttosto che restituire un dato non aggiornato; molti database NoSQL privilegiano invece la disponibilità, accettando che un’informazione possa risultare obsoleta per qualche secondo. Per un approfondimento sulle famiglie di database non relazionali, dai sistemi a documento a quelli a grafo, la trattazione dedicata è disponibile nella pagina sul database NoSQL.
Altre tipologie di database oltre al modello relazionale
Accanto al modello relazionale e al mondo NoSQL esistono categorie nate per esigenze più specifiche, spesso usate in combinazione con un sistema relazionale piuttosto che in alternativa.
- NewSQL: architetture che cercano di unire la scalabilità orizzontale tipica del NoSQL al supporto delle transazioni ACID e, spesso, alla compatibilità con SQL.
- In-memory: sistemi che mantengono i dati nella memoria RAM invece che su disco, azzerando i tempi di lettura e scrittura legati all’I/O fisico; si usano per il caching degli oggetti e per applicazioni che richiedono risposte immediate.
- A serie temporali (time-series): ottimizzati per registrare dati che cambiano a intervalli regolari, come metriche di sistema, log di sensori IoT o quotazioni finanziarie.
- A oggetti: memorizzano i dati come oggetti, in modo coerente con linguaggi di programmazione orientati agli oggetti, evitando la conversione tra struttura applicativa e struttura tabellare.
Queste categorie non sostituiscono il modello relazionale nei contesti in cui la coerenza transazionale resta prioritaria, ma lo affiancano quando il collo di bottiglia riguarda la velocità di accesso o la natura temporale del dato, non la sua integrità referenziale.
Esempi di database relazionali più diffusi
I motori che implementano il modello relazionale si distinguono per licenza, prestazioni e contesto d’uso, pur condividendo la stessa base teorica e un dialetto SQL comune.
| RDBMS | Tipo di licenza | Contesto d’uso tipico |
|---|---|---|
| MySQL | Open source, con versione commerciale | Applicazioni web, sistemi di gestione dei contenuti (CMS) |
| PostgreSQL | Open source | Progetti complessi, dati geografici, carichi misti |
| Oracle Database | Commerciale | Grandi infrastrutture aziendali, sicurezza avanzata |
| Microsoft SQL Server | Commerciale, con edizione gratuita limitata | Ambienti Windows e integrazione con l’ecosistema Microsoft |
| MariaDB | Open source | Alternativa a MySQL dopo l’acquisizione da parte di Oracle |
| SQLite | Open source | Applicazioni mobile e desktop, file locale senza server dedicato |
Accanto alle installazioni locali, i principali fornitori cloud offrono versioni gestite dello stesso modello relazionale, accessibili anche tramite API per l’automazione di backup, scalabilità e monitoraggio: è il caso di Amazon RDS e Google Cloud SQL, che eliminano la manutenzione diretta del server a fronte di un costo ricorrente legato all’utilizzo.
Programmi per creare e gestire un database
La scelta dello strumento dipende dal livello di competenza tecnica disponibile e dalla scala del progetto, più che da un’unica soluzione valida in ogni contesto.
Se serve un database senza programmare
Per chi non scrive codice SQL, Microsoft Access resta uno strumento diffuso per creare rapidamente un gestionale interno con moduli, tabelle e interfacce grafiche, mentre LibreOffice Base offre una funzione equivalente gratuita e multipiattaforma, utile anche per creare un semplice database clienti con pochi campi collegati tra loro.
Se si sviluppa un’applicazione web o un progetto complesso
Per progetti che richiedono query avanzate, scalabilità e supporto a lungo termine, PostgreSQL e MySQL restano le scelte più diffuse tra chi sviluppa software, grazie alla disponibilità di documentazione, estensioni e compatibilità con la maggior parte dei linguaggi di programmazione.
Se serve un database per un’app mobile o leggera
Quando non è necessario un server dedicato, SQLite rappresenta la soluzione predefinita: un singolo file locale integrato nella maggior parte delle applicazioni per smartphone, senza configurazioni di rete da gestire.
Se serve amministrare più database diversi
Per chi deve esplorare, interrogare e gestire database di motori differenti da un’unica interfaccia, un client universale come DBeaver permette di collegarsi a MySQL, PostgreSQL, SQLite e Oracle con un’esperienza grafica comune, senza passare dalla riga di comando di ciascun sistema.
Errori frequenti nella progettazione di un database relazionale
Alcuni problemi ricorrono indipendentemente dal motore scelto e derivano da scelte di struttura fatte all’inizio del progetto, quando sono più semplici da correggere.
- Omettere una chiave primaria su una tabella, rendendo impossibile identificare in modo univoco ogni riga e complicando qualsiasi collegamento con altre tabelle.
- Ripetere le stesse informazioni in più tabelle invece di collegarle tramite una chiave esterna, aumentando il rischio di dati incoerenti quando un valore viene aggiornato in un solo punto.
- Non applicare vincoli di tipo e di obbligatorietà sulle colonne, lasciando che dati incompleti o nel formato sbagliato entrino nel sistema senza controlli.
- Creare indici solo dopo aver riscontrato rallentamenti, anziché valutare in anticipo quali colonne saranno interrogate più spesso.
- Scegliere un modello relazionale rigido per dati che cambiano struttura di frequente, quando un approccio più flessibile risolverebbe il problema con meno manutenzione.
Riconoscere questi casi limite durante la fase di progettazione riduce la necessità di interventi correttivi successivi, spesso più costosi di una modellazione accurata fatta in partenza.
Domande frequenti
Cos’è un database relazionale?
È un sistema che organizza i dati in tabelle composte da righe e colonne, collegate tra loro tramite chiavi primarie ed esterne. I dati vengono interrogati e modificati con il linguaggio SQL e le operazioni rispettano le proprietà ACID per garantire coerenza e affidabilità.
Come si chiama una riga in una tabella di un database relazionale?
Una riga si chiama anche tupla o record e rappresenta un’istanza singola dell’entità descritta dalla tabella, ad esempio un cliente specifico in una tabella Clienti, con un valore per ciascuna colonna definita dallo schema.
Qual è la differenza tra righe e colonne?
Le righe rappresentano i singoli record, cioè le istanze concrete di un’entità, mentre le colonne definiscono le proprietà comuni a tutti i record, come nome, data o importo. Le colonne descrivono la struttura, le righe forniscono i dati effettivi.
Quali sono alcuni esempi di database relazionali?
MySQL, PostgreSQL, Oracle Database, Microsoft SQL Server, MariaDB e SQLite sono tra i sistemi di gestione di database relazionali più diffusi, ciascuno con un proprio equilibrio tra licenza, prestazioni e contesto d’uso, dallo sviluppo web alle applicazioni mobile.
Qual è la differenza tra database relazionali e non relazionali?
I database relazionali usano uno schema fisso con tabelle, righe e colonne e garantiscono coerenza tramite le proprietà ACID; i database non relazionali adottano strutture flessibili come documenti o coppie chiave-valore, privilegiando scalabilità orizzontale e tempi di risposta rapidi su grandi volumi.
Come creare un database semplice?
Per un primo database basta uno strumento visuale come LibreOffice Base o Microsoft Access: si definiscono le tabelle necessarie, si assegna una chiave primaria a ciascuna e si collegano le tabelle correlate tramite chiavi esterne, prima di inserire i record.
Cosa sostituisce Access?
Come alternativa gratuita e multipiattaforma a Microsoft Access si usa comunemente LibreOffice Base, mentre per progetti più strutturati si passa a un RDBMS vero e proprio come MySQL o PostgreSQL, gestito eventualmente tramite un client grafico universale.
