
Feature engineering: definizione e funzionamento

Il feature engineering è il processo che trasforma i dati grezzi di un dataset in feature, cioè le variabili di input che un modello di machine learning usa per riconoscere pattern e produrre previsioni più accurate. Comprende attività come pulizia, creazione, trasformazione e selezione delle variabili prima dell’addestramento del modello.
Da dove iniziare con il feature engineering?
- Cos’è: trasforma i dati grezzi di un dataset in feature pronte per un modello di machine learning.
- Perché conta: la qualità delle feature decide le prestazioni del modello almeno quanto l’algoritmo scelto.
- Fasi tipiche: pulizia dei dati, creazione o estrazione, trasformazione, selezione delle variabili.
- Tecniche più usate: encoding delle categorie, scaling numerico, log transform, PCA.
- Rischio principale: il data leakage, quando una feature contiene informazioni che il modello non avrebbe al momento della previsione.
- Strumenti: librerie di automazione e feature store per riusare le stesse feature in training e inferenza.
Cos’è una feature e che cosa cambia rispetto al dato grezzo
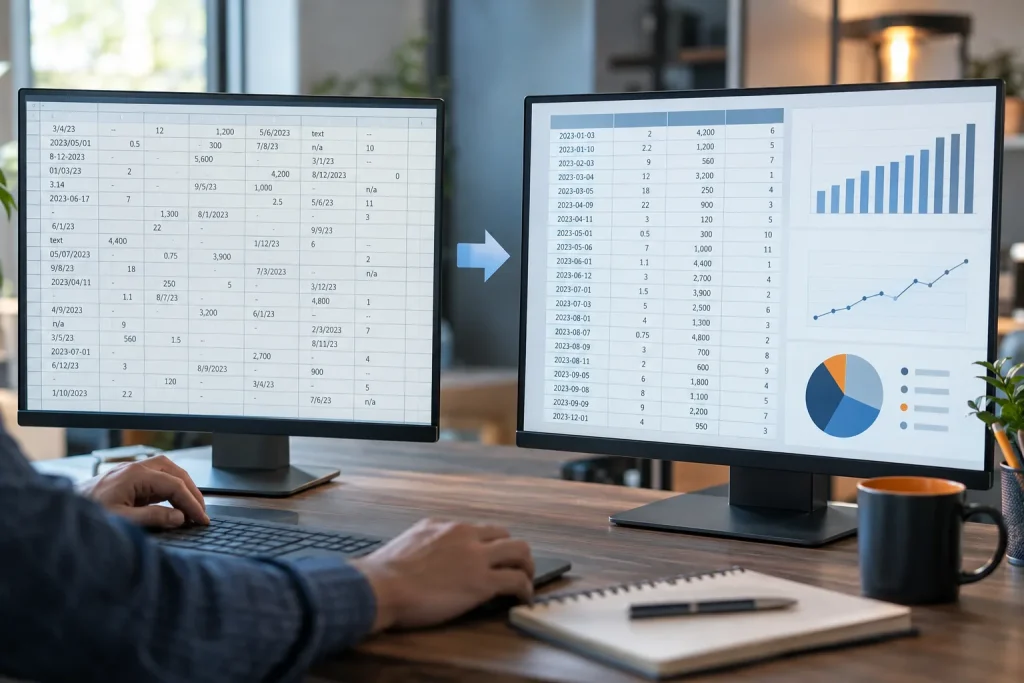
Una feature è una colonna del dataset che il modello usa per imparare: può venire direttamente dai dati di origine, come l’importo di una transazione, oppure essere calcolata, come il numero di accessi di un cliente negli ultimi 30 giorni. Il dato grezzo, da solo, dice al modello molto meno di quanto sembri: una data senza elaborazione è solo una stringa, mentre il giorno della settimana che se ne ricava può spiegare un picco di vendite che altrimenti resterebbe invisibile all’algoritmo.
Il feature engineering si colloca tra la raccolta dei dati e l’addestramento vero e proprio del modello di machine learning: chi lo fa decide quali segnali portare al modello e in che forma presentarli, e questa decisione richiede conoscenza del dominio tanto quanto competenza tecnica. Non è un’attività isolata: nella pratica coinvolge chi conosce i dati e chi conosce il problema di business, perché un rapporto come il prezzo al metro quadro ha senso solo se qualcuno sa che in quel settore conta più del prezzo assoluto.
Capita spesso che chi si avvicina al tema confonda il feature engineering con la semplice pulizia dei dati: la pulizia toglie errori e valori mancanti, il feature engineering va oltre e costruisce rappresentazioni nuove. Questo passaggio fa parte della più ampia panoramica sull’intelligenza artificiale applicata ai dati tabellari, dove la qualità dell’input resta un vincolo che nessun algoritmo aggira da solo.
Perché la qualità delle feature conta più dell’algoritmo
Un modello non può recuperare un segnale che non è mai arrivato nelle feature, qualunque sia la sofisticatezza dell’algoritmo o il tempo speso nel tuning. Se le variabili disponibili non rappresentano la struttura del problema, l’algoritmo lavora con meno informazioni di quelle che servirebbero, e nessun parametro lo compensa del tutto.
La stessa variabile, espressa in modo diverso, racconta al modello storie diverse. Il numero grezzo di accessi di un cliente negli ultimi 30 giorni dice quanto è stato attivo; la variazione rispetto a 60 giorni prima dice se sta rallentando, e spesso è questo secondo segnale a prevedere l’abbandono. I dati sottostanti restano gli stessi: cambia solo la rappresentazione, e con essa il contenuto informativo che raggiunge il modello.
Uno studio sulla previsione dei risultati accademici degli studenti mostra bene quanto pesi questa scelta: tra le variabili usate, il CGPA risulta il predittore singolo più forte, con un peso del 31,2% sull’importanza complessiva, seguito dalle marche interne con il 24,8%; insieme coprono il 56,0% del potere predittivo del modello, A Machine Learning-Based Predictive Framework for … – FMDB (2025). Nello stesso lavoro, un Random Forest costruito su queste feature raggiunge l’82,0% di accuratezza sul set di test, contro il 68,0% di un Naive Bayes gaussiano addestrato sugli stessi dati. Una differenza di 14 punti percentuali che dipende dalla combinazione tra feature e algoritmo, più che dall’algoritmo preso da solo. La convalida incrociata a 5 fold sul training set conferma un’accuratezza dell’80,4% ± 2,3%, un intervallo che conferma la stabilità del risultato oltre il singolo split.
Una domanda utile per verificare una feature è questa: il suo valore esisteva già al momento in cui il modello dovrà fare la previsione? È un controllo più utile di qualunque confronto tra algoritmi.
Le fasi principali del processo
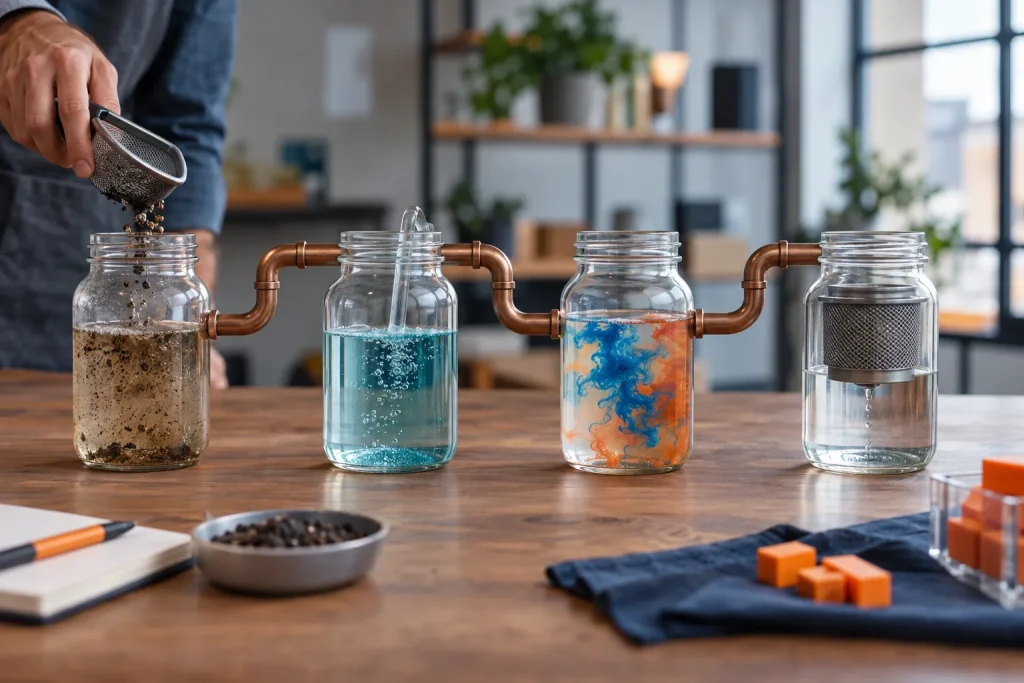
Il processo si divide in quattro attività che si susseguono, anche se nella pratica si ripetono più volte prima di arrivare a un set di feature stabile:
- Pulizia dei dati: si gestiscono i valori mancanti, sostituendoli con stime statistiche come media, mediana o moda, e si trattano gli outlier che distorcerebbero l’apprendimento.
- Creazione ed estrazione: si generano nuove variabili a partire da quelle esistenti, per esempio separando una data in anno, mese e giorno della settimana, oppure aggregando più transazioni in un’unica misura.
- Trasformazione: si modifica la scala o la distribuzione dei dati con scaling, encoding delle categorie o trasformazioni logaritmiche, così da renderli compatibili con il modello.
- Selezione: si riduce il numero di feature scartando quelle ridondanti o rumorose, per limitare l’overfitting e semplificare il modello.
Ogni fase si valuta con lo stesso criterio: la nuova feature migliora le prestazioni sui dati esclusi dall’addestramento? Alcune variabili si dimostrano utili al primo tentativo, altre vengono escluse perché introducono un segnale che il modello non avrà davvero a disposizione in produzione. È un processo iterativo più che una sequenza a senso unico: capita di tornare alla fase di creazione dopo aver scoperto, nella selezione, che mancava un segnale importante.
Tecniche di trasformazione e di estrazione delle feature
Le variabili categoriche si convertono in numeri con tre metodi principali: l’one-hot encoding crea una colonna binaria per ogni categoria, il label encoding assegna un numero intero a ciascuna categoria ed è utile con gli alberi di decisione, il target encoding sostituisce la categoria con la media della variabile obiettivo calcolata su un sottoinsieme separato dei dati.
Sul lato numerico, la standardizzazione centra i valori a media zero e varianza unitaria, mentre il min-max scaling li riporta in un intervallo fisso, tipicamente tra 0 e 1; la scelta tra le due dipende dall’algoritmo che riceverà i dati, perché i modelli basati sulle distanze risentono molto di scale diverse tra le variabili. La trasformazione logaritmica riduce l’effetto di distribuzioni molto sbilanciate, come i redditi o i prezzi.
L’estrazione automatica, usata nella computer vision classica con descrittori come SIFT o gli istogrammi dei gradienti orientati, oggi è stata in gran parte sostituita dalle reti convoluzionali, che apprendono le proprie mappe di feature direttamente dai pixel; l’estrazione manuale resta però centrale sui dati tabellari e sulle serie temporali, dove un modello semplice può usare solo le colonne che gli vengono fornite. La riduzione della dimensionalità con la PCA comprime feature correlate in componenti non correlate, mantenendo il contenuto informativo con meno colonne.
Esempi pratici di feature engineering
In un modello che prevede il prezzo di una casa, passare al modello solo il prezzo e la superficie lascia sul tavolo un’informazione importante: il prezzo al metro quadro, che mette a confronto immobili diversi su una base comune, o la distanza dai mezzi pubblici, che spiega variazioni di prezzo che la sola superficie non coglie.
In un sistema che analizza transazioni con carta, la singola operazione racconta poco; aggregare i dati per cliente e calcolare la spesa totale negli ultimi 3 mesi, o il numero di transazioni nell’ultima ora, trasforma un flusso di eventi isolati in un segnale di comportamento. Lo stesso principio vale nel rischio di credito, dove il rapporto tra debito e reddito o l’utilizzo del credito disponibile prevedono il mancato pagamento meglio dei saldi grezzi, e nella manutenzione predittiva, dove le medie mobili calcolate su vibrazioni e temperature rivelano un’usura prima che una singola lettura superi la soglia di allarme.
Che differenza c’è tra feature engineering e feature selection
Il feature engineering crea nuove variabili combinando o trasformando quelle esistenti; la feature selection, che ne è una fase, sceglie quali di queste variabili, originali o create, restano nel modello finale. I metodi filtro valutano le feature con misure statistiche come la correlazione con il target; i metodi wrapper provano sottoinsiemi di feature direttamente sul modello; i metodi integrati, come la regolarizzazione L1, eliminano le feature meno utili durante l’addestramento stesso.
Confondere i due termini porta a un errore pratico: chi applica solo la selezione lavora con le variabili che ha, chi applica l’ingegnerizzazione ne costruisce di nuove prima ancora di scegliere. La mia regola è semplice: prima creo, poi seleziono, perché scartare troppo presto una variabile che non ha ancora la forma giusta significa buttare via un segnale che bastava trasformare.
Come si evita il data leakage nelle feature
Una feature è valida solo se il suo valore è disponibile nel momento in cui il modello deve fare la previsione. Un modello di abbandono che usa il numero di chiamate all’assistenza registrate dopo la cancellazione, oppure una codifica del target calcolata sull’intero dataset invece che sui soli dati di addestramento, ottiene risultati ottimi nei test e fallisce in produzione: è una forma di leakage, perché il modello ha “visto” un’informazione che nella realtà non avrebbe ancora.
Per ridurre questo rischio, ogni trasformazione con parametri appresi, come le medie di uno scaler o le codifiche delle categorie, si calcola solo sui dati di addestramento e si applica agli altri fold senza ricalcolarla; una nuova feature si tiene solo se migliora il punteggio in convalida incrociata, non solo sul training set. Lo stesso controllo serve a evitare lo scarto tra i dati usati in addestramento e quelli disponibili in produzione, un problema che un feature store riduce perché garantisce che training e inferenza calcolino la stessa feature allo stesso modo.
Strumenti utili per il feature engineering
Gli strumenti di ingegneria dei dati, come i linguaggi di trasformazione SQL e Python, coprono già buona parte del lavoro, perché molte trasformazioni sono comuni ai due ambiti. A questi si aggiungono librerie specifiche per il machine learning: Featuretools automatizza la creazione di feature da dati strutturati, TSFRESH estrae caratteristiche da serie temporali, piattaforme come Databricks integrano l’intero flusso dalla trasformazione al deployment del modello.
Un feature store è un repository centralizzato che gestisce e versiona le feature, ne traccia la derivazione e garantisce che training e inferenza usino la stessa definizione: evita che un modello venga addestrato su una versione dei dati e messo in produzione su un’altra. Il versioning dei dati, in questo contesto, è un elemento importante: permette di riprodurre un modello addestrato mesi prima anche quando i dati di origine sono nel frattempo cambiati.
Quale approccio scegliere in base al tipo di dato
Il tipo di dato decide quanto lavoro manuale serve prima di arrivare al modello.
| Tipo di dato | Tecniche prevalenti | Chi fa il lavoro |
|---|---|---|
| Tabellare (clienti, transazioni) | encoding, scaling, aggregazioni, rapporti tra variabili | ingegnerizzazione manuale guidata dal dominio |
| Serie temporali | finestre mobili, ritardi, estrazione da data/ora | ingegnerizzazione manuale |
| Testo | pulizia, vettorizzazione, embedding | mista: preprocessing manuale, rappresentazione spesso appresa |
| Immagini | estrazione automatica tramite reti convoluzionali | appresa dal modello, poco lavoro manuale |
Se lavori su dati tabellari o su serie storiche di vendite, conviene investire tempo nella creazione manuale di feature derivate: un modello semplice, anche un albero di decisione, le userà bene. Se lavori su immagini, audio o testo non strutturato, il funzionamento del deep learning sposta buona parte del lavoro di rappresentazione dentro il modello stesso: qui il compito umano si concentra più sulla preparazione dei dati grezzi che sulla costruzione delle singole variabili.
Errori frequenti nel feature engineering
L’errore più comune è aggiungere feature senza verificarne l’effetto reale: un numero contenuto di variabili davvero informative riduce il rischio di overfitting meglio di tante colonne ridondanti. Un secondo errore è calcolare statistiche, come medie o codifiche, sull’intero dataset prima di dividerlo in addestramento e test: il modello sembra performante in fase di validazione e perde precisione non appena incontra dati nuovi.
Un terzo errore riguarda la valutazione con la cross-validation: testare una sola volta su un singolo split nasconde quanto il risultato dipenda dal caso; un controllo su più fold, come quello che si vede nello studio citato in questa pagina sulla previsione accademica, mostra se l’accuratezza è stabile o legata a una combinazione fortunata dei dati. Infine, capita di confondere la complessità dell’algoritmo con la qualità del lavoro fatto a monte: un algoritmo avanzato applicato a feature povere resta un algoritmo che lavora con poche informazioni.
Domande frequenti
Cosa si intende per feature engineering?
Si intende il processo che trasforma i dati grezzi di un dataset in feature utilizzabili da un modello di machine learning, attraverso pulizia, creazione, trasformazione e selezione delle variabili. L’obiettivo è dare al modello una rappresentazione del problema più informativa di quella grezza.
Cos’è una feature?
Una feature è una variabile di input usata per addestrare un modello: può essere una colonna già presente nel dataset, come l’età di un cliente, oppure una variabile derivata, come la spesa media negli ultimi tre mesi.
Che cos’è il feature scaling?
Il feature scaling è la tecnica che porta i valori numerici su una scala comune, con la standardizzazione a media zero e varianza unitaria o il min-max scaling in un intervallo fisso. Serve a evitare che le variabili con numeri grandi dominino l’apprendimento.
Che differenza c’è tra feature extraction e feature engineering?
La feature extraction è un sottoinsieme del feature engineering: calcola nuove variabili con un algoritmo fisso o un modello appreso, come la PCA, mentre il feature engineering comprende anche le decisioni guidate dal dominio su quali variabili creare e come rappresentarle.
Che differenza c’è tra feature engineering e feature selection?
Il feature engineering crea e trasforma le variabili, la feature selection sceglie quali di queste tenere nel modello finale, eliminando quelle ridondanti o poco informative con metodi filtro, wrapper o integrati nell’addestramento.
Come si evita il data leakage nel feature engineering?
Si evita calcolando ogni trasformazione con parametri appresi solo sui dati di addestramento e verificando che ogni feature sia nota al momento della previsione, non dopo. Una convalida incrociata, non un singolo split, conferma se il miglioramento è reale.
Quali strumenti si usano per il feature engineering?
Si usano linguaggi di trasformazione come SQL e Python, librerie specifiche come Featuretools o TSFRESH per l’automazione, e un feature store per versionare e riutilizzare le stesse feature tra addestramento e produzione.
