
Cos’è GoogleAgent-URLContext e come funziona

GoogleAgent-URLContext è lo user-agent con cui Gemini recupera in tempo reale il contenuto di un URL indicato in un prompt, dentro le API di Gemini, Google AI Studio e la Gemini Enterprise Agent Platform. Si attiva solo quando un’applicazione lo richiede in quel momento, non quando un crawler decide di passare sul sito secondo un proprio calendario.
GoogleAgent-URLContext: cosa serve sapere
- Cosa fa: legge e sintetizza il contenuto di uno o più URL indicati in un prompt rivolto a Gemini.
- Chi lo usa: le API Gemini, Google AI Studio e la Gemini Enterprise Agent Platform.
- Quando si attiva: solo su richiesta esplicita (live-fetch), non con una scansione pianificata del sito.
- Limiti tecnici: fino a 20 URL per richiesta, 34 MB massimi per singolo URL, secondo la documentazione ufficiale aggiornata a ottobre 2026.
- Accesso ai contenuti: solo pagine pubbliche; non raggiunge contenuti dietro paywall o riservati.
- Gestione sul sito: si può consentire o bloccare con una regola dedicata nel file robots.txt.
Cos’è GoogleAgent-URLContext e chi lo usa
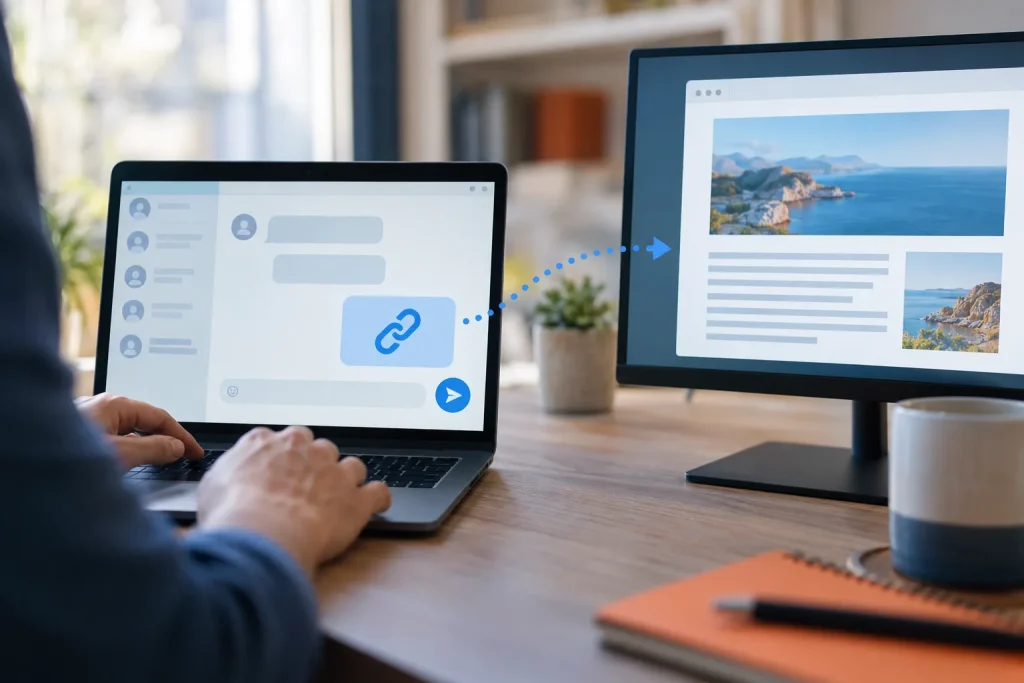
GoogleAgent-URLContext compare nei log quando qualcuno, dentro un’applicazione basata su Gemini, inserisce un link e chiede al modello di leggerlo, riassumerlo o confrontarlo con altri documenti. Non indicizza il sito: recupera quella singola pagina, quel PDF o quell’immagine, li passa al modello e si ferma lì.
Lo usano tre ambienti distinti: le API Gemini per chi scrive codice, Google AI Studio per chi sperimenta un prompt senza scrivere nulla, e la Gemini Enterprise Agent Platform per gli agenti aziendali che devono leggere documentazione interna o pagine pubbliche su richiesta. Gemini è il modello che riceve il contenuto recuperato dall’agente e lo usa per generare la risposta.
La scala con cui gira Gemini spiega perché questo traffico non è trascurabile: l’app Gemini aveva 950 milioni di utenti attivi mensili nel secondo trimestre del 2026, secondo 30+ Google Gemini Statistics: Usage, Revenue, Models (2026). Ogni volta che uno di quegli utenti incolla un link, può generare una richiesta di GoogleAgent-URLContext verso il sito che lo ospita.
Il tema rientra nel più ampio funzionamento degli ai crawler, i software che le piattaforme di intelligenza artificiale usano per raccogliere o leggere contenuti dal web, ciascuno con un compito diverso.
Come funziona l’attivazione su richiesta
GoogleAgent-URLContext non scansiona il sito con un calendario fisso: parte solo quando un prompt contiene un URL o quando un’applicazione passa quell’URL al modello tramite l’apposito strumento. È questo che lo distingue da Googlebot, il crawler che Google usa per indicizzare il web in modo continuo e indipendente dalle richieste degli utenti.
La conseguenza pratica è un traffico irregolare: una pagina può ricevere decine di richieste in un’ora, se diventa oggetto di molte conversazioni, oppure nessuna per settimane. Il traffico generato è tipicamente concentrato nei momenti in cui gli utenti usano quella pagina come riferimento, non distribuito nel tempo come fa un crawler di indicizzazione.
Chi legge i log del server e vede GoogleAgent-URLContext sta osservando una richiesta nata da una persona che, altrove, ha incollato quell’indirizzo in una chat o in una chiamata API.
Quali contenuti legge e quali limiti tecnici ha
Lo strumento legge testo, immagini e documenti PDF presenti su un URL pubblico, estraendone il contenuto per confrontarlo, riassumerlo o usarlo come base di una risposta. Nella documentazione ufficiale per sviluppatori, aggiornata a ottobre 2026, compaiono due soglie precise: fino a 20 URL per singola richiesta e un limite di 34 MB per ciascun URL.
Chi deve capire se il supporto a un modello specifico della famiglia Gemini (2.5 Flash incluso) sia garantito non trova un elenco fisso in questa pagina: il supporto cambia da una versione all’altra, quindi il modo corretto di verificarlo è controllare la pagina dei modelli supportati prima di costruire la chiamata, non affidarsi a ciò che valeva per una versione precedente.
Superare le soglie di dimensione o di numero di URL può impedire il corretto recupero della richiesta: per questo chi integra lo strumento nelle proprie API tiene conto dei limiti prima di passare documenti molto grandi al modello.
Perché non legge contenuti dietro paywall
GoogleAgent-URLContext raggiunge solo pagine pubbliche e accessibili senza autenticazione. Un’area riservata, un documento protetto da login o un contenuto dietro paywall restano fuori dalla sua portata, allo stesso modo in cui restano fuori dalla portata di qualunque visitatore anonimo.
Questo limite non dipende da una scelta di cortesia verso l’editore: l’agente, come qualunque fetch automatico, riceve la stessa pagina di blocco o di login che vedrebbe un browser senza sessione attiva. Se un sito aziendale vuole far leggere a Gemini una pagina tecnica specifica, quella pagina deve restare raggiungibile senza credenziali.
Come i link incollati in chat attivano l’agente
Chi usa Gemini dalla chat web incolla un link direttamente nel messaggio e chiede un riassunto, un confronto tra fonti o un’estrazione di dati puntuali. Quel gesto, apparentemente banale, è esattamente il trigger che fa partire GoogleAgent-URLContext verso il dominio indicato.
Capita spesso che chi gestisce un sito di servizi locali scopra questo traffico analizzando i log dopo aver notato visite anomale, senza che nessuna query di ricerca le spieghi: la spiegazione, nella maggior parte dei casi, è un cliente o un collaboratore che ha incollato l’indirizzo in una conversazione con l’AI.
Come integrarlo nelle API Gemini
Per chi scrive codice, lo strumento si attiva includendo gli URL nel corpo della richiesta API insieme al prompt: il modello recupera il contenuto e lo tratta come contesto aggiuntivo, allo stesso modo in cui tratterebbe un testo incollato a mano. Google AI Studio offre la stessa funzione senza scrivere codice, utile per verificare il comportamento prima di programmarlo.
Sulla Gemini Enterprise Agent Platform lo stesso strumento serve agli agenti aziendali che devono leggere pagine pubbliche di terzi (documentazione di un fornitore, un comunicato, una scheda prodotto) per rispondere a una domanda interna senza duplicare manualmente quel contenuto in un database.
Come bloccare o consentire GoogleAgent-URLContext
Il file robots.txt resta lo strumento con cui dare o togliere il permesso a questo agente, con la stessa sintassi usata per gli altri bot di Google: una riga User-agent con il nome dell’agente, seguita da Disallow o Allow.
- Apri il file robots.txt nella radice del sito, o crealo se manca.
- Aggiungi un blocco dedicato con
User-agent: GoogleAgent-URLContext. - Scrivi
Disallow: /per impedire ogni fetch, oppureAllow: /(o percorsi specifici) per consentirlo esplicitamente. - Pubblica il file e verifica che risponda con stato 200 all’indirizzo /robots.txt del dominio.
- Controlla nei log del server, nei giorni successivi, se le richieste da quell’agente proseguono o si fermano.
Repertori specializzati in bot AI, come quelli che monitorano GoogleAgent-URLContext, lo trattano come un agente controllabile da robots.txt: non è documentato nei materiali ufficiali di Google se il rispetto della direttiva sia garantito in ogni contesto applicativo, quindi il controllo nei log resta il passaggio che conferma se il blocco ha avuto effetto. Per chi vuole vedere prima esempi applicati ad altri bot, gli esempi pratici di robots txt coprono casi analoghi. Un altro modo per segnalare alle AI quali pagine leggere per prime, più indicativo che impositivo, è il funzionamento di llms.txt.
GoogleAgent-URLContext e Googlebot a confronto
| Aspetto | GoogleAgent-URLContext | Googlebot |
|---|---|---|
| Quando si attiva | Su richiesta esplicita, legata a un prompt | Secondo una pianificazione interna di Google |
| Cosa visita | Solo l’URL indicato nella richiesta | L’intero sito, seguendo i link che trova |
| Scopo del recupero | Dare contesto a una risposta generata da Gemini | Costruire e aggiornare l’indice di ricerca |
| Regolarità del traffico | Irregolare, concentrato in picchi | Ricorrente, distribuito nel tempo |
Vale la pena distinguerli perché bloccare uno dei due nel robots.txt non tocca l’altro: una regola scritta per Googlebot non impedisce a GoogleAgent-URLContext di leggere la stessa pagina, e viceversa.
Cosa cambia per la visibilità dei contenuti
Il fetch di GoogleAgent-URLContext serve a costruire la risposta che Gemini mostra a chi ha condiviso quel link, un meccanismo distinto dall’indicizzazione e dalla scansione che alimentano i risultati di ricerca tradizionali.
Il contesto in cui questo traffico cresce è però lo stesso in cui il clic verso i siti si riduce: il 68% delle ricerche su Google negli Stati Uniti tra gennaio e aprile 2026 si è concluso senza un clic verso un sito esterno, secondo Google AI Mode e SEO nel 2026: cosa cambia davvero (2026). In questo scenario, farsi leggere correttamente da uno strumento come GoogleAgent-URLContext conta quanto farsi indicizzare da Googlebot: è un’altra via con cui il contenuto arriva a chi cerca una risposta, con metriche diverse rispetto al ranking tradizionale.
Se vuoi essere citato quando qualcuno incolla il tuo link in Gemini
Lascia l’agente libero di leggere le pagine che vuoi vedere riassunte o citate: un blocco totale toglie anche questa possibilità.
Se vuoi impedire ogni lettura automatica dei tuoi contenuti
Applica il blocco nel robots.txt descritto sopra, sapendo che perdi anche le sintesi generate su richiesta da chi condivide il tuo URL, non solo un’eventuale citazione.
Chi lavora sulla visibilità nei motori generativi di risposta valuta questa scelta insieme alle altre leve di ottimizzazione, non come una decisione isolata sul singolo bot.
Domande frequenti su GoogleAgent-URLContext
Cos’è GoogleAgent-URLContext?
È lo user-agent con cui Gemini recupera in tempo reale il contenuto di un URL indicato in un prompt, usato dalle API Gemini, da Google AI Studio e dalla Gemini Enterprise Agent Platform per dare contesto aggiuntivo al modello.
Come si attiva GoogleAgent-URLContext?
Si attiva solo quando un’applicazione o un utente inserisce un URL in un prompt rivolto a Gemini: non scansiona il sito con una pianificazione propria, come fa invece un crawler di indicizzazione.
Quanti URL può leggere in una richiesta?
Fino a 20 URL per singola richiesta, con un limite di 34 MB per ciascun URL, secondo la documentazione ufficiale per sviluppatori aggiornata a ottobre 2026.
Legge contenuti dietro paywall o aree riservate?
No, raggiunge solo pagine pubbliche e accessibili senza autenticazione: un’area protetta da login restituisce la stessa pagina di blocco che vedrebbe un visitatore anonimo.
Come si blocca GoogleAgent-URLContext nel robots.txt?
Si aggiunge un blocco dedicato con User-agent: GoogleAgent-URLContext seguito da Disallow per impedire il fetch, poi si verifica nei log del server se le richieste di quell’agente continuano o si fermano.
Che differenza c’è tra GoogleAgent-URLContext e Googlebot?
Googlebot scansiona l’intero sito in modo continuo per costruire l’indice di ricerca; GoogleAgent-URLContext legge un singolo URL solo quando un prompt lo richiede, per dare contesto a una risposta di Gemini.
GoogleAgent-URLContext influisce sul posizionamento organico?
Incide sulla possibilità di essere letti e citati dentro le risposte di Gemini, un meccanismo distinto dall’indicizzazione che alimenta il ranking tradizionale.
Fonti e riferimenti
- 30+ Google Gemini Statistics: Usage, Revenue, Models … (2026) www.secondtalent.com
- Google AI Mode e SEO nel 2026: cosa cambia davvero (2026) google.com
