
Hypertext Transfer Protocol (HTTP): cos’è e come funziona

L’Hypertext Transfer Protocol (HTTP) è il protocollo di livello applicativo che regola lo scambio di richieste e risposte tra un browser e un server web: ogni volta che una pagina si carica, un client apre una connessione, invia un metodo e riceve un codice di stato insieme alla risorsa richiesta.
HTTP in sintesi per chi gestisce un sito
- Modello di comunicazione: il browser invia una richiesta e il server web risponde, in un ciclo request-response.
- Natura stateless: ogni richiesta è indipendente; sessioni e login restano attivi solo grazie a cookie o token.
- Metodi principali: GET, POST, PUT, PATCH e DELETE indicano al server quale azione eseguire su una risorsa.
- Sicurezza: la versione cifrata HTTPS, su porta 443, ha ormai sostituito quasi ovunque la porta 80 in chiaro.
- Trasporto: HTTP si appoggia storicamente su TCP; HTTP/3 usa invece QUIC su UDP per ridurre la latenza.
- Versioni in uso: HTTP/1.1, HTTP/2 e HTTP/3 convivono oggi sui server, con pesi diversi nelle richieste web.
Come funziona il modello richiesta-risposta di HTTP
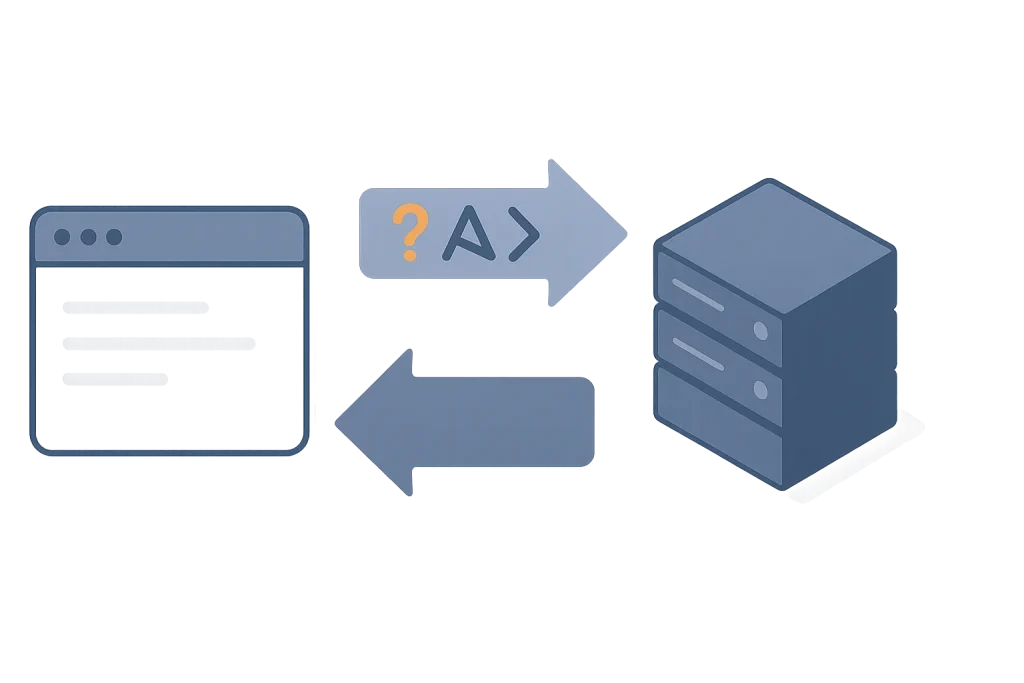
Quando un visitatore digita l’indirizzo del tuo sito, succede questo: il browser cerca prima l’indirizzo IP del dominio tramite il Domain Name System (DNS), poi apre una connessione verso il server e invia una richiesta HTTP. Il server la elabora e restituisce una risposta con un codice di stato e il contenuto richiesto, che il browser trasforma nella pagina che l’utente vede.
La richiesta contiene tre elementi fissi: un metodo (cosa vuole fare il client), un URL (quale risorsa vuole) e una serie di intestazioni, gli header, con informazioni accessorie come il tipo di browser o i formati accettati. Il body, cioè i dati veri e propri, è opzionale e compare tipicamente quando si invia un modulo. La risposta ha la stessa struttura ma al posto del metodo porta il codice di stato. Tra gli header più utili c’è Cache-Control: dice al browser per quanto tempo può riusare una risorsa senza richiederla di nuovo, ed è uno dei primi punti che controllo quando un sito carica più lento del dovuto.
Nel mio lavoro, quando analizzo un problema di indicizzazione, la prima cosa che guardo è proprio questo scambio: apro gli strumenti per sviluppatori del browser, controllo la scheda rete e leggo la risposta che il server restituisce al crawler di Google. Se lì il codice di stato non torna 200, tutto il resto dell’analisi parte da un presupposto sbagliato.
HTTP è inoltre un protocollo stateless: il server non ricorda nulla della richiesta precedente. Lo tratto più avanti, perché è il punto che genera più confusione tra chi non lavora tutti i giorni con l’infrastruttura di un sito.
Quali sono i metodi HTTP principali e a cosa servono
I metodi HTTP dicono al server quale azione eseguire su una risorsa: sono sei, e nella gestione ordinaria di un sito ne incontri quotidianamente soprattutto due, GET e POST, mentre gli altri emergono quando lavori con API o moduli di back office.
| Metodo | Azione | Esempio d’uso |
|---|---|---|
| GET | Recupera una risorsa senza modificarla | Caricamento di una pagina o di un’immagine |
| POST | Invia dati al server per creare una risorsa | Invio di un modulo di contatto o di un ordine |
| PUT | Sostituisce integralmente una risorsa esistente | Aggiornamento completo di una scheda prodotto via API |
| PATCH | Aggiorna solo una parte della risorsa | Modifica del solo prezzo di un prodotto |
| DELETE | Rimuove una risorsa | Cancellazione di un account utente |
| HEAD | Richiede solo gli header, senza il corpo | Verifica che una pagina esista prima di scaricarla |
La differenza tra PUT e PATCH è quella che genera più dubbi quando si integra un’API esterna: PUT riscrive la risorsa intera, quindi se ometti un campo nella richiesta quel campo spesso si azzera; PATCH tocca solo i campi indicati. Se stai sincronizzando un e-commerce con un gestionale, questa distinzione decide se un aggiornamento di prezzo cancella per errore anche la descrizione del prodotto. L’ho visto succedere, e il colpevole non era mai il protocollo ma la scelta del metodo sbagliato nella configurazione dell’integrazione.
Cosa indicano i codici di stato HTTP
Il codice di stato è il primo dato che leggo quando un cliente segnala “la pagina non si vede”: è un numero a tre cifre che il server mette in testa alla risposta e che racconta, da solo, come è andata la richiesta.
- 1xx — Informativo
- Il server ha ricevuto la richiesta e sta ancora elaborando.
- 2xx — Successo
- La richiesta è andata a buon fine; il caso più comune è 200 OK.
- 3xx — Reindirizzamento
- La risorsa si trova altrove; il caso più comune è 301 Moved Permanently.
- 4xx — Errore del client
- La richiesta è malformata o la risorsa non esiste; il caso più comune è 404 Not Found.
- 5xx — Errore del server
- Il server ha fallito nell’elaborare una richiesta corretta; il caso più comune è 500 Internal Server Error.
In Search Console questi codici arrivano sotto forma di report di copertura: una pagina con troppi errori 4xx o 5xx nel tempo perde posizioni, non perché Google “punisce” il sito ma perché non riesce più a leggerlo in modo affidabile. Lo stesso principio vale per una pagina scansionata ma non indicizzata: il problema spesso comincia da un codice di stato che il server restituisce in modo incoerente.
HTTP è un protocollo stateless: cosa significa in pratica
Stateless vuol dire che ogni richiesta HTTP è indipendente dalle precedenti: il server non conserva memoria di chi ha chiesto cosa un attimo prima. È per questo che un sito senza cookie “dimentica” il carrello a ogni pagina caricata, finché non si aggiunge un meccanismo che simuli lo stato.
Il meccanismo più comune è il cookie: il server lo invia nella risposta con l’header Set-Cookie, il browser lo conserva e lo rimanda a ogni richiesta successiva sullo stesso dominio. In alternativa, soprattutto nelle API, si usano i token: una stringa che il client allega come header di autenticazione.
Stateless o stateful: come si comportano altri protocolli
Non tutti i protocolli funzionano come HTTP, e la distinzione aiuta a capire perché “stateless” non è di per sé un limite da compensare.
- Firewall: può essere stateless (valuta ogni pacchetto da solo) o stateful (tiene traccia delle connessioni attive); la maggior parte dei firewall moderni è stateful proprio per riconoscere traffico anomalo.
- SMTP: mantiene lo stato per tutta la durata di una sessione di invio email, a differenza di HTTP che chiude e riapre lo scambio a ogni richiesta.
- API REST: per definizione sono stateless, proprio perché costruite sopra HTTP: ogni chiamata deve contenere tutte le informazioni necessarie, senza presupporre che il server ricordi la chiamata precedente.
Se ti stai chiedendo se “stateless” sia un bene o un male, la mia posizione è che dipende dal volume di traffico da gestire: uno stato condiviso tra milioni di richieste diventa un collo di bottiglia, mentre per un singolo servizio interno può semplificare la logica. Non è una regola assoluta, è un compromesso che ogni architettura sceglie in base al carico che deve reggere.
HTTP vs HTTPS: differenze che contano per un sito
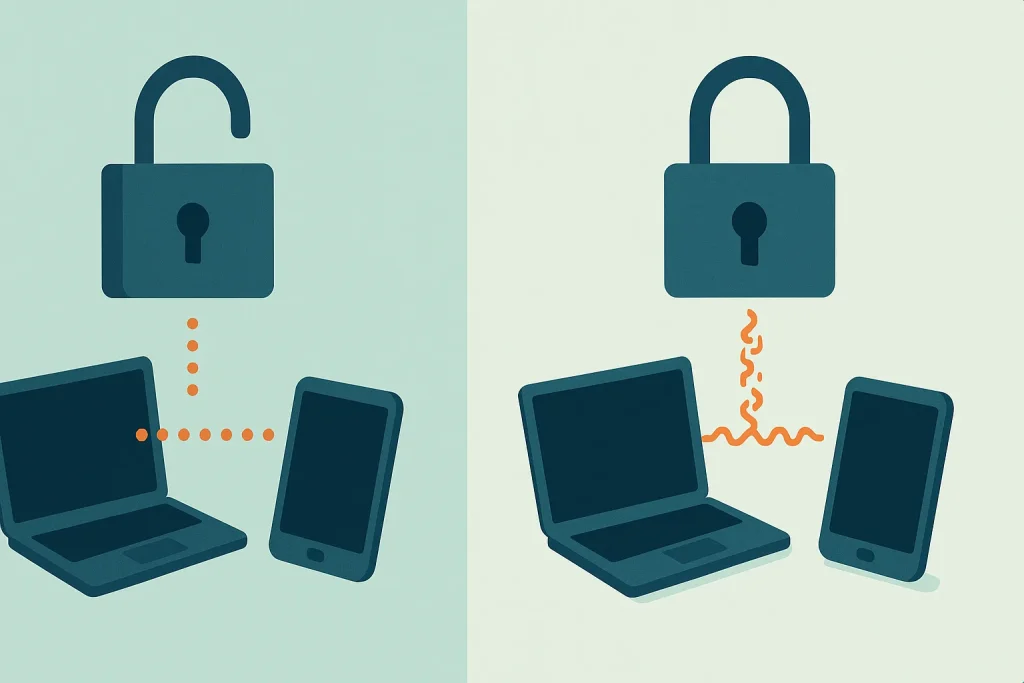
La differenza tra HTTP e HTTPS non è di principio ma di cifratura: HTTPS è HTTP trasportato dentro un canale TLS, quindi stesso protocollo applicativo, stessa logica di richiesta e risposta, ma con i dati illeggibili per chiunque intercetti il traffico di rete.
| Aspetto | HTTP | HTTPS |
|---|---|---|
| Porta predefinita | 80 | 443 |
| Dati in transito | In chiaro, leggibili da chi intercetta la rete | Cifrati tramite TLS |
| Certificato | Non richiesto | Richiesto un certificato TLS valido |
| Effetto su login e form | Password e dati sensibili esposti | Credenziali protette durante l’invio |
Ad aprile 2025 circa il 98% del traffico internet negli Stati Uniti passava già da HTTPS, secondo HTTPS vs. HTTP: Why Secure Connections Matter in 2025 (2025): un sito ancora in HTTP puro, oggi, è l’eccezione, non la norma, e i browser lo segnalano come “non sicuro” già nella barra degli indirizzi.
Se vedi porte diverse da 80 e 443: cosa significa
- Se il sito risponde su porta 8080: è quasi sempre un ambiente di test o un proxy interno, non la configurazione pubblica finale.
- Se vedi la porta 8443 al posto di 443: in genere indica un servizio HTTPS secondario, spesso usato per pannelli di amministrazione, mantenuto separato dal sito principale.
- Se la porta 443 risulta bloccata: il problema è quasi sempre un firewall di rete o del provider, non una configurazione del server web.
- Porta 80 e porta 443 non sono la stessa cosa: la prima resta aperta solo per reindirizzare automaticamente verso la 443, non per servire contenuto.
- Se usi una porta non standard come la 444: funziona dal punto di vista tecnico, ma va scritta esplicitamente nell’URL, quindi ha senso solo in ambienti controllati, mai su un sito pubblico.
HTTP e il trasporto di rete: il ruolo di TCP e QUIC
HTTP vive al livello applicativo dello stack di rete: si occupa del contenuto della comunicazione, non di come i pacchetti arrivano a destinazione. Quel compito spetta al livello di trasporto, storicamente il Transmission Control Protocol (TCP), un protocollo orientato alla connessione che garantisce consegna ordinata e senza perdite, a differenza dell’UDP, che non offre queste garanzie ma è più veloce proprio perché le evita.
Come avviene una richiesta HTTP sopra TCP
- Il browser risolve il dominio in un indirizzo IP tramite una query DNS.
- Si apre una connessione TCP con il server, attraverso il three-way handshake: SYN, SYN-ACK, ACK.
- Il browser invia la richiesta HTTP sulla connessione appena aperta.
- Il server elabora la richiesta e restituisce la risposta sullo stesso canale.
- La connessione resta aperta per richieste successive, se il server supporta le connessioni persistenti introdotte con HTTP/1.1.
TCP garantisce che i pacchetti arrivino nell’ordine giusto, ma proprio questa affidabilità genera un costo in latenza quando la rete è instabile: ogni pacchetto perso va rinegoziato. È il motivo per cui HTTP/3 abbandona TCP a favore di QUIC, un protocollo di trasporto costruito sopra UDP che gestisce la perdita di pacchetti senza bloccare l’intero flusso.
Un paper del 2024 della ACM Web Conference misura però un limite di QUIC alle alte velocità: sopra i 500 Mbps il data rate può ridursi fino al 45,2% rispetto a HTTP/2, secondo HTTP Protocol Adoption Q3 2026: HTTP/3 Is Shrinking … (2024). Non è un dato che sposta la scelta per la maggior parte dei siti con traffico normale, ma vale la pena saperlo prima di considerare HTTP/3 una soluzione sempre superiore.
Le differenze pratiche tra HTTP/1.1, HTTP/2 e HTTP/3, e come verificare quale versione sta usando davvero il tuo server, le ho trattate a parte, con i passaggi di verifica: le trovi nell’approfondimento su differenze tra HTTP/2 e HTTP/3 e quando contano per un sito.
Come si è evoluto HTTP nel tempo
Tim Berners-Lee lo ha progettato al CERN tra la fine degli anni ottanta e il 1991, insieme a HTML e al primo browser. Da lì HTTP è cambiato quattro volte in modo sostanziale: HTTP/0.9 nel 1991 trasferiva solo documenti HTML grezzi; HTTP/1.0, formalizzato nel 1996 con la RFC 1945, ha introdotto header e codici di stato; HTTP/1.1, nel 1997, ha aggiunto le connessioni persistenti; HTTP/2, standardizzato nel 2015, ha introdotto multiplexing e compressione degli header; HTTP/3, standardizzato nel 2022, ha sostituito TCP con QUIC.
Nel terzo trimestre 2026 HTTP/2 copriva il 51,04% delle richieste web, in crescita di 0,58 punti rispetto al mese precedente, mentre HTTP/3 era sceso al 20,17% dal 22,98% dello stesso trimestre 2025 e HTTP/1.x risultava al 27,37%, secondo HTTP Protocol Adoption Q3 2026: HTTP/3 Is Shrinking … (2026). Questi numeri dicono una cosa semplice: sapere quale versione gira sul tuo server non è un dettaglio da manuale, è una misura da controllare, e per questo ho dedicato una pagina a parte alle differenze tra HTTP/2 e HTTP/3 e come verificarle sul tuo sito.
Errori frequenti quando si lavora con HTTP su un sito aziendale
Nel mio lavoro, gli errori legati a HTTP che tornano più spesso non riguardano il protocollo in sé ma la sua configurazione sul server.
- Redirect misti HTTP/HTTPS: una parte del sito reindirizza a HTTPS, un’altra no; Google tratta le due versioni come pagine diverse e disperde i segnali di posizionamento.
- Contenuti misti (mixed content): una pagina servita in HTTPS che carica immagini o script ancora in HTTP; il browser la segnala come non del tutto sicura, anche se il dominio ha il certificato.
- Header mancanti o duplicati: un header Content-Type assente o scorretto può far interpretare male una risposta, soprattutto nelle integrazioni con API esterne.
- Metodo sbagliato in un’integrazione: usare PUT dove servirebbe PATCH, con il rischio di sovrascrivere dati che non si voleva toccare.
- Connessioni non persistenti su siti con molte risorse: un server configurato male riapre una connessione per ogni immagine, appesantendo il tempo di caricamento percepito e, di conseguenza, le metriche osservate in fase di analisi tecnica.
Sconsiglio di delegare questi controlli solo a un plugin: un plugin segnala il sintomo, ma la causa è quasi sempre nella configurazione del server o dell’hosting, e lì serve una verifica diretta nel pannello o via riga di comando.
Domande frequenti su HTTP
Cos’è l’Hypertext Transfer Protocol (HTTP)?
È il protocollo di livello applicativo che permette a un browser di richiedere una risorsa a un server web e di riceverne una risposta. Si basa su un modello client-server e su uno scambio di messaggi di testo strutturati, con metodo, header e corpo opzionale nella richiesta e codice di stato nella risposta.
Cos’è l’hypertext a cui fa riferimento il nome HTTP?
L’hypertext è un testo che contiene collegamenti, i link, verso altri documenti o risorse. HTML struttura questo contenuto, mentre HTTP si occupa di trasferirlo tra server e browser: il nome del protocollo deriva proprio da questa combinazione.
HTTP è un protocollo stateless?
Sì, per definizione: ogni richiesta è indipendente dalle precedenti e il server non conserva memoria delle interazioni passate. L’aggiunta di cookie o token permette di simulare lo stato per mantenere login, carrelli e preferenze tra una richiesta e l’altra.
HTTPS è più sicuro di HTTP?
Sì: HTTPS cifra i dati tramite TLS, quindi chi intercetta il traffico non può leggerli, mentre HTTP li trasmette in chiaro. Ad aprile 2025 circa il 98% del traffico internet negli Stati Uniti passava già da HTTPS, segno che è ormai lo standard, non l’eccezione.
HTTP funziona solo su TCP o anche su UDP?
HTTP/1.1 e HTTP/2 funzionano su TCP, un protocollo orientato alla connessione. HTTP/3 è l’eccezione: usa QUIC, costruito sopra UDP, per ridurre la latenza e gestire meglio la perdita di pacchetti su reti instabili.
Porta 80 e porta 443 sono la stessa cosa?
No: la porta 80 è quella predefinita per HTTP in chiaro, la 443 per HTTPS cifrato. Nella configurazione corretta di un sito, la porta 80 resta attiva solo per reindirizzare automaticamente le richieste verso la 443.
Una REST API è stateful o stateless?
È stateless per definizione, proprio perché costruita sopra HTTP: ogni chiamata deve contenere tutte le informazioni necessarie alla sua elaborazione, senza presupporre che il server ricordi le chiamate precedenti dello stesso client.
HTTP/2 è ancora supportato dai browser e dai siti?
Sì, è la versione più diffusa oggi: secondo HTTP, è supportato dal 71% dei siti web e da oltre il 98% degli utenti tramite browser. Per capire quale versione usa realmente il tuo server serve però una verifica diretta, non una supposizione.
Fonti e riferimenti
- HTTPS vs. HTTP: Why Secure Connections Matter in 2025 (2025) securityscorecard.com
- HTTP Protocol Adoption Q3 2026: HTTP/3 Is Shrinking … (2026) technologychecker.io
- HTTP en.wikipedia.org
