
GraphQL: cos’è, come funziona e quando ha senso valutarlo per il tuo sito

GraphQL è un linguaggio di interrogazione per API e un runtime lato server che permette al client di chiedere esattamente i dati che gli servono, in un’unica richiesta, invece di combinare più chiamate come spesso accade con le API REST tradizionali. È stato creato da Facebook ed è oggi open source.
GraphQL in sintesi
- Natura: è un linguaggio di query più un runtime server, non un database né un framework a sé stante.
- Origine: nato internamente in Facebook nel 2012, reso open source nel 2015 e oggi gestito dalla GraphQL Foundation.
- Operazioni: si basa su tre tipi di richiesta — query per leggere, mutation per scrivere, subscription per gli aggiornamenti in tempo reale.
- Endpoint: usa un solo punto di accesso (di solito
/graphql) invece di più URL come fa REST. - Confronto con REST: riduce i dati inutili scambiati, ma complica il caching e richiede uno schema ben progettato.
- Idoneità: ha senso quando più client (sito, app, dashboard) devono leggere dati collegati tra loro in modi diversi; per un sito aziendale su CMS standard, nella maggior parte dei casi non è una priorità.
Cos’è GraphQL e da dove arriva
GraphQL nasce per risolvere un problema concreto: far arrivare ai client mobile solo i dati che servono, senza sprecare banda. Lo ha sviluppato internamente Facebook (oggi Meta) nel 2012, quando il team stava riscrivendo l’app iOS e si è accorto che le API REST esistenti restituivano troppi dati, o troppo pochi, per ogni schermata del News Feed.
La specifica è stata resa pubblica e open source nel 2015. Nel 2018 il progetto è passato a una governance esterna: oggi è gestito dalla GraphQL Foundation, ospitata dalla Linux Foundation, fondata formalmente nel marzo 2019 (2019 Annual Report (2019)). È un dettaglio che conta più di quanto sembri: significa che GraphQL non è un prodotto di un’azienda, ma una specifica aperta con un comitato tecnico che ne decide l’evoluzione, un po’ come successe a HTML o a JavaScript con i loro organismi di standardizzazione.
La licenza è MIT, quindi l’uso è libero anche in contesti commerciali: nessun canone da pagare per implementare un’API GraphQL sul proprio server. Chi paga, semmai, è il tempo di sviluppo per progettare lo schema e i resolver, di cui parlo nella prossima sezione.
Nel mio lavoro vedo spesso confondere GraphQL con un prodotto o un servizio in abbonamento: non lo è. È una specifica, come REST lo è per lo stile architetturale delle API, solo più prescrittiva su come strutturare schema e query.
Come funziona GraphQL: schema, endpoint unico e dati esatti
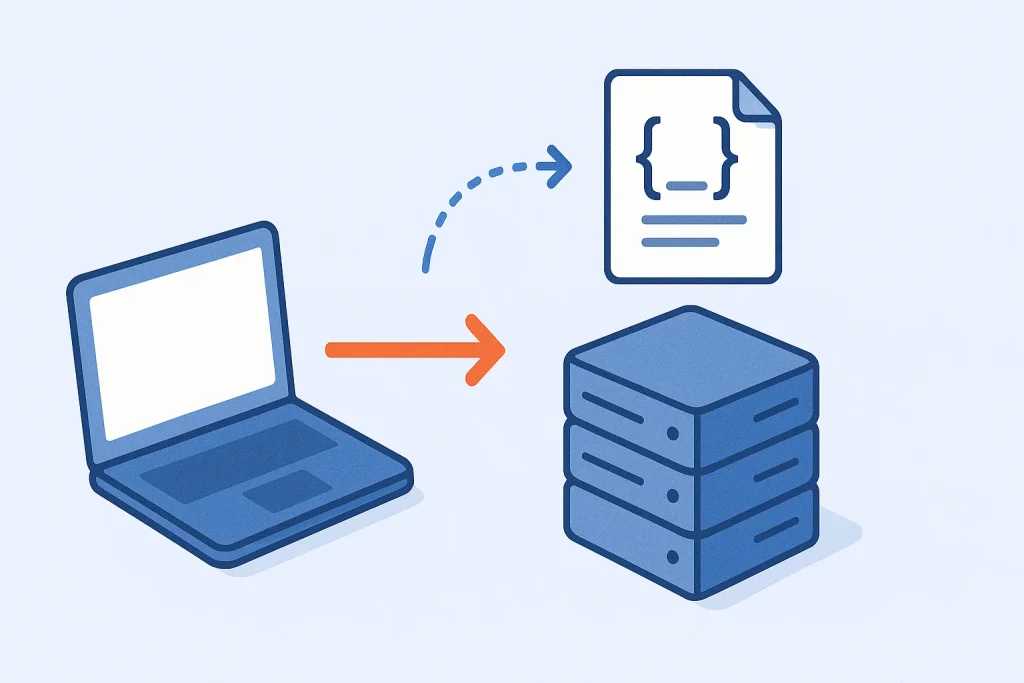
GraphQL funziona così: il server espone uno schema, scritto in un linguaggio chiamato SDL, che elenca tipi, campi e relazioni disponibili. Il client invia una query che rispecchia esattamente la struttura dei dati che vuole ricevere, e il server risponde con un oggetto che ha la stessa forma della richiesta. Se chiedi solo il nome e l’email di un cliente, ricevi solo quello: niente indirizzo, niente storico ordini, a meno che tu non li includa esplicitamente nella query.
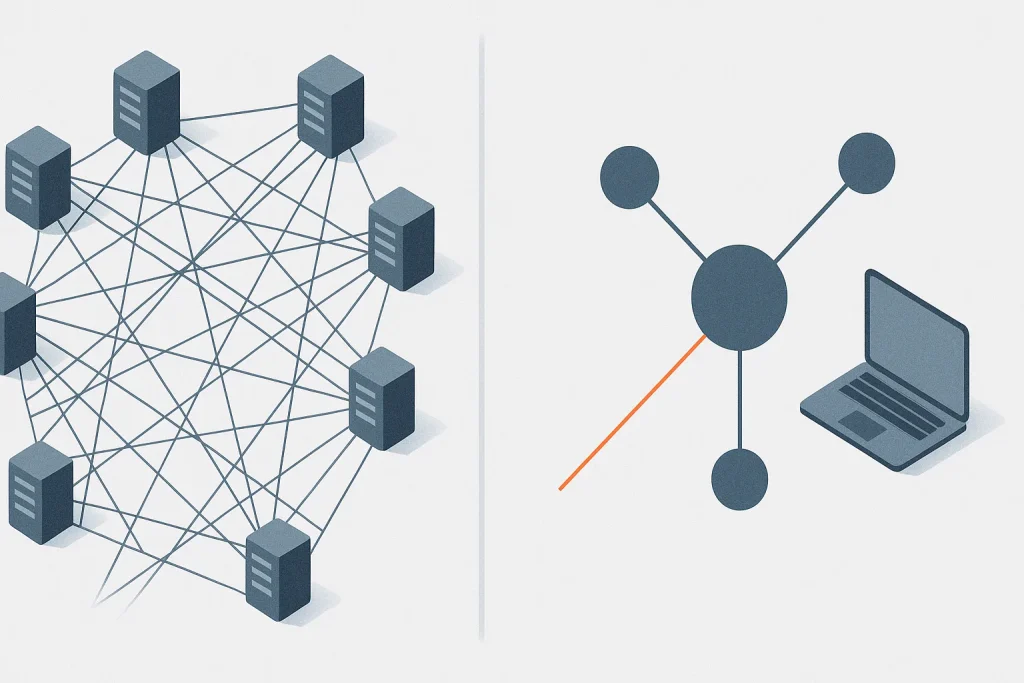
Questo risolve due problemi opposti che con REST capitano spesso: l’over-fetching (l’endpoint restituisce più campi di quelli che servono) e l’under-fetching (servono più chiamate a endpoint diversi per ricostruire la stessa informazione). Con un’unica richiesta a un endpoint singolo, di solito /graphql, il client ottiene dati che in un’architettura REST classica richiederebbero più round trip verso più URL.
Dietro ogni campo dello schema c’è un resolver: una funzione lato server che sa dove andare a prendere quel dato, che sia un database relazionale, una fonte NoSQL o un altro servizio interno. Se gestisci un sito con dati sparsi tra più sistemi — un content management system (CMS) per i contenuti e un database relazionale per gli ordini, per esempio — i resolver sono il punto in cui GraphQL aggrega queste fonti in un’unica risposta coerente.
Lo schema è tipizzato: ogni campo ha un tipo dichiarato (stringa, numero, ID, oggetto personalizzato), e un punto esclamativo indica che il campo è obbligatorio. Questo permette al server di validare la query prima ancora di eseguirla e di restituire errori chiari quando il client chiede un campo che non esiste. In più, grazie all’introspection, un client può interrogare lo schema stesso per scoprire quali tipi e campi sono disponibili: è quello che permette agli strumenti di sviluppo di suggerire l’autocompletamento mentre scrivi una query.
Un’ultima cosa che distingue GraphQL da REST sul piano tecnico: l’evoluzione dell’API non passa da versioni numerate (/v1, /v2), ma dalla deprecazione graduale dei campi tramite la direttiva @deprecated. Se cambi un campo, lo segnali come obsoleto, i client migrano con calma, e lo rimuovi solo quando non lo usa più nessuno.
Le tre operazioni di base: query, mutation e subscription
Ogni interazione con un’API GraphQL rientra in una di queste tre categorie, e la distinzione è netta anche a livello di sintassi.
- Query
- Serve a leggere dati esistenti. È l’operazione più comune: il client chiede una struttura di campi e riceve indietro gli stessi campi valorizzati.
- Mutation
- Serve a modificare dati: creare un nuovo record, aggiornarne uno esistente o cancellarlo. Dopo l’operazione, il server restituisce comunque i dati aggiornati nella forma richiesta dal client, così non serve una chiamata aggiuntiva per verificare l’esito.
- Subscription
- Mantiene una connessione aperta, di solito su WebSocket, e il server invia un aggiornamento al client ogni volta che un dato sottoscritto cambia: utile per dashboard, chat o notifiche in tempo reale.
Nella pratica di un sito aziendale, le query coprono la quasi totalità dei casi: cataloghi prodotto, contenuti, elenchi clienti. Le mutation entrano in gioco nei moduli di contatto, nei carrelli, nei pannelli di amministrazione. Le subscription sono quelle che vedo usare meno, perché richiedono un’infrastruttura realtime che molti siti aziendali semplicemente non hanno bisogno di gestire: un magazzino che aggiorna la disponibilità ogni notte non ha bisogno di WebSocket, gli basta una query eseguita al caricamento della pagina.
Una cosa da tenere a mente quando ne parli con chi ti sviluppa il sito: query, mutation e subscription condividono lo stesso schema e lo stesso endpoint. Non sono tre API separate, sono tre modi di interrogare la stessa struttura dati.
Un esempio pratico di richiesta e risposta
Per capire concretamente la differenza rispetto a REST, immagina di voler mostrare, sulla pagina di un articolo del blog aziendale, il titolo, l’autore e i primi tre commenti. Con REST, probabilmente servirebbero tre chiamate: una per il post, una per l’autore, una per i commenti. Con GraphQL basta una query sola:
query {
  post(id: "123") {
    title
    author { name }
    comments(limit: 3) { text }
  }
}
La risposta mantiene la stessa forma della richiesta:
{
  "data": {
    "post": {
      "title": "Come funziona GraphQL",
      "author": { "name": "Redazione" },
      "comments": [{ "text": "Articolo utile" }]
    }
  }
}
Chi sviluppa il frontend con un framework JavaScript come quelli basati su componenti (React è il caso più citato insieme a librerie client come Apollo) scrive questa query una volta e la riutilizza ovunque serva quella combinazione di dati, senza dover orchestrare tre richieste separate e gestirne gli errori singolarmente. È qui che si vede il guadagno pratico: non nella teoria dello schema, ma nel numero di chiamate che il browser deve fare prima di mostrare la pagina.
GraphQL e REST: differenze pratiche e quando scegliere l’uno o l’altro
GraphQL può tecnicamente sostituire REST, ma nella pratica quasi nessuno lo fa in modo totale: i due stili convivono nella stragrande maggioranza dei progetti che ho visto, e i dati di settore confermano questa tendenza. Nel 2026 REST resta lo stile più diffuso, usato da oltre l’80% degli sviluppatori intervistati, mentre l’adozione di GraphQL si attesta intorno al 28% delle organizzazioni (GraphQL vs REST in 2026: Which API Style Actually Wins (2026)). Sono numeri che vanno letti insieme: non significano che GraphQL stia perdendo terreno, significano che risponde a un bisogno specifico, non a ogni bisogno.
| Aspetto | REST | GraphQL |
|---|---|---|
| Endpoint | Più URL, uno per risorsa | Un endpoint unico |
| Forma della risposta | Decisa dal server | Decisa dal client |
| Over-fetching | Frequente | Assente per progettazione |
| Versioning | Gestito con URL (/v1, /v2) | Evoluzione dello schema con deprecazione dei campi |
| Caching | Nativo via HTTP | Richiede soluzioni custom |
| Dati in tempo reale | Richiede configurazione separata | Integrato con le subscription |
Perché GraphQL non sostituisce del tutto REST
Il limite più concreto è il caching. REST si appoggia alle intestazioni HTTP standard, quindi un proxy o una CDN possono mettere in cache una risposta senza configurazioni particolari. GraphQL passa quasi sempre da richieste POST su un unico endpoint, e il caching a quel punto va costruito ad hoc, a livello applicativo. Se il tuo sito vive di contenuti statici serviti velocemente, questo è un costo da considerare, non un dettaglio tecnico da ignorare.
Se ti chiedi quale architettura scegliere
Se il tuo progetto ha più client diversi che leggono dati relazionati tra loro — sito, app, dashboard interna — valuta GraphQL insieme a chi te lo sviluppa: il guadagno in meno chiamate di rete può essere concreto. Se invece il tuo sito è un CMS standard con poche integrazioni esterne, REST resta la scelta più semplice da mantenere: meno infrastruttura da gestire, caching già risolto dal server web.
Una domanda che mi sento fare spesso è se GraphQL possa essere “usato come se fosse” un’API REST. La risposta breve è no: sono due modelli di interazione diversi, uno basato su risorse e metodi HTTP (GET, POST, PUT, DELETE), l’altro su uno schema unico interrogato con query. Si può costruire un livello REST sopra un backend GraphQL, ma è un lavoro aggiuntivo, non una conversione automatica.
Vantaggi e limiti di GraphQL quando gestisci un sito aziendale
Il vantaggio principale lo ho già descritto: meno dati inutili scambiati, meno chiamate di rete, schema autodocumentato che riduce gli errori di integrazione tra frontend e backend. A questo si aggiunge l’evoluzione senza versioni separate, utile se il tuo sito cambia spesso struttura dei contenuti.
I limiti, però, sono reali e vanno pesati prima di decidere. Il caching complesso di cui ho parlato nella sezione precedente è il primo. Il secondo è che GraphQL non è un linguaggio di query a grafo completo come SPARQL: non può, in una sola richiesta, risalire relazioni ricorsive arbitrarie (il classico esempio è “tutti gli antenati di una persona”), quindi certe query molto profonde vanno comunque gestite con logica applicativa aggiuntiva. Il terzo è la curva di apprendimento per chi sviluppa: progettare uno schema buono richiede più disciplina di quanta ne serva per aggiungere un endpoint REST.
Errori frequenti quando si valuta GraphQL per un sito aziendale
- Sceglierlo perché “è più moderno di REST”, senza un bisogno concreto di aggregare fonti diverse.
- Sottovalutare il tempo di progettazione dello schema, trattandolo come un dettaglio implementativo e non come un’architettura dati.
- Non pianificare il caching, scoprendo solo in produzione che le risposte non vengono mai servite dalla cache.
- Esporre l’intero schema del database senza filtrare i campi sensibili, pensando che “tanto il client chiede solo quello che gli serve”.
Quest’ultimo punto lo sottolineo perché lo vedo ripetersi: uno schema ben progettato limita cosa è interrogabile, non si affida alla buona educazione di chi scrive le query. Se il tuo fornitore ti dice che con GraphQL “il client chiede solo quello che serve” come se fosse una garanzia di sicurezza, è una frase da approfondire, non da accettare così.
Casi d’uso reali: dove GraphQL fa la differenza
GraphQL rende concretamente di più in tre scenari ricorrenti: API pubbliche con molti consumatori diversi, gateway davanti a più microservizi, e client mobile con connessioni lente.
Le API pubbliche di GitHub, Shopify e Pinterest usano GraphQL come interfaccia principale: un singolo endpoint che permette a sviluppatori esterni di comporre query su misura invece di dover combinare decine di endpoint REST. Nel settore travel, oltre il 90% delle interazioni dei clienti su web e app native di vrbo.com è alimentato da API GraphQL (2019 Annual Report (2019)): è un dato che mostra come, in un contesto con più piattaforme client da servire, l’investimento nello schema si ripaghi.
Il secondo scenario è l’API gateway per microservizi: quando un’azienda ha decine di servizi interni, mettere GraphQL davanti a tutti come livello unificato semplifica la vita a chi consuma i dati, che sia il sito, l’app o un partner esterno. Un CMS headless è un esempio tipico: espone i contenuti via GraphQL e lascia a ogni client (sito, app, digital signage) la libertà di chiedere solo i campi che gli servono.
Il terzo scenario è l’ottimizzazione mobile: i dispositivi su rete lenta beneficiano di payload più piccoli e di meno round trip, che è esattamente il problema che Facebook stava cercando di risolvere quando ha creato GraphQL nel 2012.
Per completezza: nel materiale che ho verificato non trovo dati pubblici affidabili sull’uso attuale di GraphQL da parte di Netflix, né conferme sull’uso di gRPC o sul linguaggio del loro stack interno; preferisco dirlo chiaramente piuttosto che inventare un dettaglio che non posso verificare.
Come capire se vale la pena valutare GraphQL per il tuo progetto
Prima di chiedere a chi ti sviluppa il sito di “passare a GraphQL”, vale la pena seguire una verifica in ordine: evita di partire dalla tecnologia e di cercare un problema a cui applicarla dopo.
- Elenca quanti client diversi leggono gli stessi dati (sito, app, dashboard interna, partner esterni): se è solo uno, il vantaggio di GraphQL si riduce molto.
- Verifica se i tuoi dati provengono da più fonti che oggi richiedono più chiamate separate (per esempio un database relazionale per gli ordini e un CMS per i contenuti).
- Controlla, con chi gestisce l’infrastruttura, quanto è critico il caching HTTP per le prestazioni attuali del sito: se lo è molto, il costo di ricostruirlo va messo in conto.
- Stima il tempo di progettazione dello schema: non è un dettaglio da sviluppatore, è un investimento architetturale che si ripaga solo se i client che lo useranno sono più di uno.
- Decidi con chi sviluppa se adottare GraphQL solo per una parte dell’API (per esempio il catalogo prodotti) e lasciare REST per il resto, invece di una migrazione totale.
Questa è la sequenza che userei io prima di consigliare un cambio di architettura a un cliente: parte dai dati e dai client reali, non dalla moda del momento. E sì, anche “bisogna passare a GraphQL” è una frase che tra qualche anno qualcuno guarderà con la stessa diffidenza con cui oggi guardiamo certi consigli SEO del 2015.
Domande frequenti su GraphQL
GraphQL può sostituire del tutto REST?
Tecnicamente sì, nella pratica quasi mai: nella maggior parte dei progetti che vedo i due stili convivono, GraphQL per i casi con più client e dati collegati, REST per il resto dell’infrastruttura.
GraphQL è gratuito da usare?
Sì, la specifica è distribuita con licenza MIT: nessun costo di licenza per implementarla sul proprio server. Il costo reale è il tempo di progettazione dello schema e dei resolver.
Cos’è l’architettura di GraphQL?
È composta da uno schema tipizzato, un insieme di resolver che recuperano i dati per ogni campo e un runtime che valida ed esegue le query ricevute su un unico endpoint, di solito /graphql.
Cos’è Apollo GraphQL rispetto a GraphQL?
Apollo è una libreria client e server che implementa la specifica GraphQL, non un’alternativa a essa: serve a scrivere e gestire query, cache e stato lato frontend, tipicamente insieme a librerie come React.
GraphQL è ancora rilevante oggi?
Sì, ma con un ruolo specifico: nel 2026 l’adozione è intorno al 28% delle organizzazioni, mentre REST resta usato da oltre l’80% degli sviluppatori. Non è in competizione totale, copre un bisogno diverso.
Quali sono gli svantaggi di GraphQL?
I principali sono il caching complesso rispetto a REST, l’incapacità di risolvere relazioni ricorsive profonde in una sola query e la curva di apprendimento per progettare uno schema solido e sicuro.
GraphQL è un framework?
No. È una specifica che definisce un linguaggio di query e un runtime di esecuzione; i framework e le librerie (come Apollo o Relay) sono implementazioni che la mettono in pratica.
Netflix e altre grandi aziende usano ancora GraphQL?
Il materiale verificato conferma l’adozione pubblica da parte di aziende come GitHub, Shopify, Pinterest e vrbo.com; non ho trovato dati pubblici affidabili e aggiornati sull’uso attuale da parte di Netflix, quindi evito di affermarlo con certezza.
Fonti e riferimenti
- GraphQL vs REST in 2026: Which API Style Actually Wins (2026) www.devx.com
- 2019 Annual Report (2012) graphql.org
