
Llm cosa sono

Un LLM (large language model, modello linguistico di grandi dimensioni) è un sistema di intelligenza artificiale addestrato su enormi quantità di testo che calcola, parola dopo parola, il token più probabile per proseguire una frase: da questo meccanismo nascono scrittura, traduzione, programmazione e risposta in linguaggio naturale.
Llm cosa sono, in sintesi
- Cosa sono: sistemi che prevedono il testo più probabile dato un contesto, addestrati su grandi volumi di documenti.
- Come funzionano: scompongono il testo in token, li trasformano in vettori numerici e li elaborano con l’architettura transformer.
- A cosa servono: generano testo, traducono, scrivono codice e alimentano chatbot, assistenti e motori di risposta.
- Modelli principali: GPT di OpenAI, Gemini di Google, Claude di Anthropic, Llama di Meta.
- Limiti noti: possono produrre allucinazioni, ereditano bias dai dati e hanno una finestra di contesto limitata.
- Dove girano: di norma su server cloud del fornitore, ma versioni più leggere possono funzionare anche in locale sul dispositivo dell’utente.
Cosa significa l’acronimo LLM
LLM sta per large language model, modello linguistico di grandi dimensioni. L’aggettivo “grande” descrive due cose insieme: la mole di testo usata per l’addestramento e il numero di parametri, cioè le connessioni interne che il modello regola durante il training.
Il riferimento più citato per capire la scala di questi numeri è Tutto quello che devi sapere sugli LLM (2020): GPT-3, rilasciato nel 2020, ha 175 miliardi di parametri. È un dato che vale per quel modello in quel momento, non uno standard: i modelli più leggeri ne hanno molti meno, per costare meno e rispondere più in fretta, mentre le versioni successive non dichiarano sempre la cifra esatta.
Come funziona un LLM
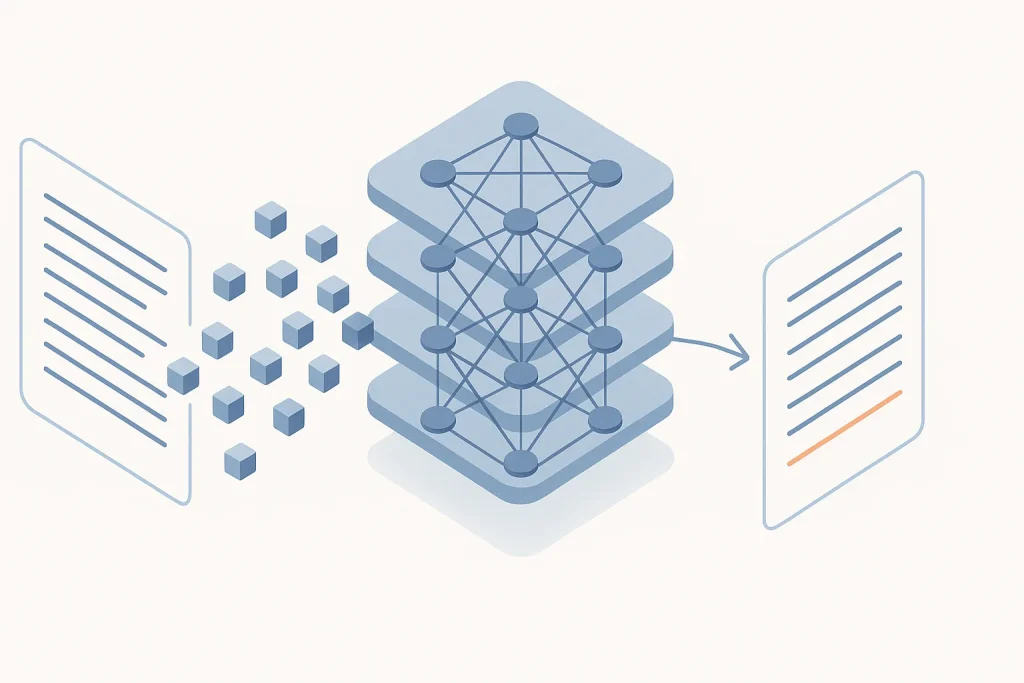
Un LLM funziona scomponendo il testo in unità più piccole, i token, e calcolando per ognuna la probabilità di essere seguita da un certo token successivo. Il risultato è un calcolo statistico: il modello non “sa” la risposta, la costruisce scegliendo di volta in volta il token più probabile in base al contesto precedente.
Tokenizzazione ed embedding
La tokenizzazione è il primo passaggio: una parola può diventare un solo token o più d’uno, a seconda della lunghezza e della lingua. Ogni token diventa poi un vettore numerico, un embedding, che il modello usa per rappresentare il significato e il contesto della parola.
Architettura transformer e self-attention
Gli embedding passano attraverso l’architettura transformer, composta da livelli di codifica e decodifica. Il meccanismo che la rende efficace si chiama self-attention: per ogni token, il modello calcola quanto gli altri token della frase sono rilevanti per interpretarlo, indipendentemente dalla loro posizione. Secondo Tutto quello che devi sapere sugli LLM (2017), l’architettura è stata introdotta da Google nel 2017 con il paper “Attention Is All You Need”; in una guida tecnica di settore ho letto invece il 2018 come anno di riferimento. La data corretta, confermata dalla maggior parte delle fonti, resta il 2017.
Come si crea un LLM
Costruire un LLM richiede tre fasi, nell’ordine:
- Pre-training: il modello legge enormi quantità di testo e impara a prevedere la parola successiva, in modo non supervisionato.
- Fine-tuning: il modello viene specializzato su un compito o un dominio specifico, con dataset più piccoli e mirati.
- RLHF (apprendimento per rinforzo con feedback umano): persone valutano le risposte del modello, che impara a preferire quelle giudicate migliori.
Per un titolare di micro o piccola impresa questo percorso non è praticabile in autonomia: il pre-training richiede capacità di calcolo fuori portata per un singolo sito o e-commerce. Nel mio lavoro consiglio di partire sempre da un modello già addestrato, acceduto via API o tramite un’interfaccia come ChatGPT, e di investire eventualmente nel fine-tuning o nel collegamento a documenti propri, non nella costruzione da zero.
A cosa servono gli LLM
Un LLM serve a generare o elaborare testo in linguaggio naturale: scrive contenuti, traduce, riassume documenti e produce codice, a partire da un’istruzione data dall’utente. Più l’istruzione è chiara, più la risposta è utile: la qualità di un prompt cambia in modo concreto il risultato che un LLM restituisce.
Gli usi più frequenti in un contesto aziendale sono quattro: scrittura di testi (email, schede prodotto, articoli), traduzione automatica, scrittura e correzione di codice, assistenza conversazionale tramite chatbot. In un confronto tra benchmark pubblicato su LLM, cosa sono i Large language model: applicazioni un modello raggiunge il 95,5% nel benchmark MATH, dedicato alla risoluzione di problemi matematici, e il 90,2% nel benchmark MMLU, che misura comprensione linguistica e ragionamento: sono punteggi riferiti a un singolo modello in un singolo test, non una media del settore.
Un uso meno visibile ma in crescita è il collegamento di un LLM a documenti interni di un’azienda, tecnica nota come RAG (retrieval-augmented generation): il modello non risponde solo con quanto ha imparato in addestramento, ma recupera prima informazioni aggiornate da una base documentale, spesso organizzata in un database vettoriale, e poi genera la risposta. Lo stesso principio sta dietro a come funziona Perplexity, un motore di risposta che incrocia ricerca web e un LLM per citare le fonti usate in ogni risposta.
Un LLM può anche operare oltre la semplice conversazione, eseguendo più passaggi in autonomia per completare un compito: è il campo degli agenti AI, che tratto a parte perché richiede un livello di autonomia diverso da quello di un assistente che risponde a una domanda per volta.
Quali sono i principali LLM
I modelli più diffusi oggi sono quattro: GPT, su cui si basa ChatGPT di OpenAI; Gemini di Google, con caratteristiche multimodali che gli permettono di elaborare anche immagini oltre al testo; Claude, sviluppato da Anthropic; Llama di Meta, il principale fra quelli open source scaricabili e modificabili liberamente.
ChatGPT e Microsoft Copilot non sono LLM in sé: sono prodotti conversazionali che richiamano un LLM al loro interno. Il modello e il prodotto non coincidono, lo stesso LLM può essere usato da più interfacce diverse.
La differenza pratica che conta di più, per chi deve scegliere, è tra modelli closed source e modelli open source.
| Caratteristica | Closed source (GPT, Claude, Gemini) | Open source (Llama e simili) |
|---|---|---|
| Accesso | Solo via API o interfaccia del fornitore | Scaricabile e installabile su server propri |
| Personalizzazione | Limitata al fine-tuning concesso dal fornitore | Modificabile liberamente, fine-tuning completo |
| Gestione dati | I dati passano dai server del fornitore | I dati possono restare sull’infrastruttura dell’azienda |
| Costo tipico | Pagamento a consumo, nessun costo di infrastruttura | Nessun canone, ma costo di calcolo e gestione a carico di chi lo usa |
LLM locali: come funzionano e quando convengono
Un LLM locale è una versione del modello installata ed eseguita direttamente sul dispositivo dell’utente, invece che su un data center del fornitore: l’elaborazione sfrutta la GPU o la memoria del computer, non la connessione a Internet.
Il vantaggio principale è la privacy: i dati e i prompt non lasciano mai la macchina, un aspetto rilevante per studi legali, attività sanitarie o chi gestisce dati personali di clienti soggetti al GDPR. Il modello funziona anche offline e non comporta abbonamenti ricorrenti. Il limite è l’hardware richiesto: serve un computer con una scheda video dedicata e una quantità di memoria video adeguata, altrimenti il modello resta lento o non si avvia. Google ha seguito questa direzione con Gemini Nano, introdotto nel dicembre 2023 come modello pensato per funzionare direttamente sul dispositivo, secondo quanto riportato in Small Language Models (SLM): cosa sono, vantaggi e limiti (2023).
Per installare e gestire un LLM in locale si usano programmi con interfaccia grafica o a riga di comando, pensati per scaricare i modelli già pronti e farli girare senza configurazioni manuali complesse.
Se devi scegliere tra LLM locale e cloud
Se gestisci dati sensibili di clienti e vuoi che restino sulla tua infrastruttura, valuta un modello locale o open source installato su server tuoi o del tuo fornitore di hosting. Se invece ti serve rapidità di messa in produzione e non hai un reparto tecnico interno, un modello cloud via API resta la scelta più semplice, perché non richiede di gestire hardware dedicato al calcolo. Nel mio lavoro parto quasi sempre dal secondo caso: per la maggior parte delle micro e piccole imprese il costo di gestione di un’infrastruttura locale supera il risparmio che se ne otterrebbe.
Che differenza c’è tra LLM, intelligenza artificiale e machine learning
L’intelligenza artificiale è il campo di studio che comprende qualunque sistema progettato per simulare capacità tipicamente umane, dal riconoscimento di un’immagine al gioco degli scacchi. Un LLM è una delle tecnologie che appartengono a questo campo, specializzata nel linguaggio: ogni LLM è intelligenza artificiale, ma non ogni sistema di intelligenza artificiale è un LLM. Un algoritmo che riconosce volti in una foto, per esempio, è intelligenza artificiale ma non un LLM.
Il termine “modello linguistico” (LM), senza il secondo “large”, indica in generale qualunque sistema statistico che stima la probabilità di una sequenza di parole: esistono da decenni, anche in forme molto più semplici. Un LLM è un modello linguistico reso “large” dalla scala dei dati di addestramento e dei parametri usati.
Che differenza c’è tra LLM e machine learning
Il machine learning è la disciplina che studia come un sistema impara dai dati senza istruzioni esplicite per ogni caso. Un LLM applica tecniche di machine learning, in particolare di deep learning, a un compito specifico: comprendere e generare linguaggio. Il machine learning è quindi il metodo, l’LLM è un tipo di risultato che quel metodo produce quando si applica a grandi quantità di testo.
Quali sono i limiti di un LLM
Un LLM può generare informazioni false ma espresse in modo plausibile: questo fenomeno si chiama allucinazione e riguarda in particolare nomi, citazioni, numeri e riferimenti normativi inventati con sicurezza. Prima di pubblicare un testo generato da un LLM, nel mio lavoro verifico sempre ogni dato numerico o normativo citato, perché il modello non distingue tra un fatto verificato e uno plausibile.
Un secondo limite è il bias: un LLM eredita gli squilibri presenti nei testi con cui è stato addestrato e può riprodurli nelle risposte senza segnalarlo. Un terzo limite è la finestra di contesto: ogni LLM ha un numero massimo di token che può elaborare in una singola conversazione, oltre il quale perde le informazioni fornite all’inizio. Un quarto limite è il knowledge cutoff: il modello conosce solo quanto era disponibile fino alla data in cui è stato addestrato, a meno che non sia collegato a una ricerca esterna in tempo reale.
Questi limiti hanno un costo pratico: secondo Knowledge Graphs e Large Language Models (LLMs) insieme (2025), Gartner stima che fino al 2025 almeno il 30% dei progetti di AI generativa venga abbandonato dopo la fase di proof of concept, spesso per aspettative mal calibrate su affidabilità e costi. L’uso degli LLM nelle aziende che operano in Europa è anche oggetto di regole specifiche sugli obblighi dei fornitori e dei distributori di sistemi di intelligenza artificiale, disciplinate dall’AI Act.
Quanto costa usare un LLM
Il costo di un LLM dipende dalla modalità di accesso, non da un prezzo fisso valido per tutti i modelli. Chi usa un LLM tramite interfaccia conversazionale paga di norma un canone mensile che dà accesso a un certo volume di utilizzo. Chi lo integra in un proprio sito o software tramite API paga invece a consumo, in base al numero di token elaborati in entrata e in uscita: più lungo il testo scambiato, più alto il costo.
Le tariffe cambiano spesso e da fornitore a fornitore: per avere un numero affidabile, l’unico modo è controllare il listino pubblicato dal fornitore del modello che intendi usare nel mese in cui lo attivi, non un prezzo letto in un articolo di qualche mese prima. Chi sceglie un modello locale o open source sposta il costo dall’abbonamento all’hardware e alla sua manutenzione, un trade-off da valutare in base al volume di utilizzo previsto.
Equivoci frequenti su cosa sono gli LLM
L’equivoco più comune è usare “LLM” e “intelligenza artificiale” come sinonimi: l’LLM è una tecnologia specifica dentro il campo più ampio dell’intelligenza artificiale. Un secondo equivoco è confondere il modello con il prodotto: ChatGPT, Copilot e Gemini sono interfacce software che richiamano un LLM al loro interno, mentre un LLM da solo richiede sempre un software che lo interroghi.
Sui modelli sviluppati in Italia il mercato degli LLM più diffusi resta dominato da modelli statunitensi. Se ti interessa un modello pensato per l’italiano, verifica direttamente sul sito del fornitore la lingua di addestramento dichiarata, prima di dare per scontato che un modello generalista funzioni allo stesso modo in ogni lingua.
Domande frequenti sugli LLM
Cosa sono gli LLM in intelligenza artificiale?
Gli LLM sono sistemi di intelligenza artificiale addestrati su grandi quantità di testo per prevedere, token dopo token, la parola più probabile da generare, con cui scrivono, traducono e rispondono a domande in linguaggio naturale.
Come funziona un LLM?
Un LLM scompone il testo in token, li converte in vettori numerici e li elabora con l’architettura transformer, calcolando a ogni passo il token successivo più probabile in base al contesto fornito.
Quali sono gli LLM più usati?
I più usati oggi sono i modelli GPT di OpenAI (alla base di ChatGPT), Gemini di Google, Claude di Anthropic e Llama di Meta, il principale fra quelli open source.
ChatGPT è un LLM?
ChatGPT non è un LLM: è un prodotto conversazionale costruito sopra un LLM della famiglia GPT. Il funzionamento del prodotto è descritto nella pagina dedicata a ChatGPT.
Copilot è un LLM?
Copilot non è un LLM in sé, ma un assistente che integra un LLM nelle applicazioni Microsoft 365 e nel browser, come spiego nella pagina su Microsoft Copilot.
Che differenza c’è tra LLM e intelligenza artificiale?
L’intelligenza artificiale è il campo generale che include ogni sistema progettato per simulare capacità umane; l’LLM è una tecnologia specifica di quel campo, specializzata nella comprensione e generazione del linguaggio.
Cosa sono gli LLM locali?
Gli LLM locali sono modelli installati ed eseguiti direttamente sul dispositivo dell’utente, senza passare da server cloud: garantiscono privacy e funzionamento offline, ma richiedono hardware adeguato.
Fonti e riferimenti
- Tutto quello che devi sapere sugli LLM (2020) www.osservatori.net
- Knowledge Graphs e Large Language Models (LLMs) … (2025) flowygo.com
- LLM, cosa sono i Large language model: applicazioni in … www.ai4business.it
- Small Language Models (SLM): cosa sono, vantaggi e limiti (2023) www.skilla.com
