
TensorFlow: definizione e caratteristiche principali

TensorFlow è una libreria open source per l’apprendimento automatico, che rappresenta i dati in tensori ed esegue le operazioni attraverso un grafo computazionale. Google Brain l’ha rilasciata nel con licenza Apache 2.0 e oggi la libreria gira su CPU, GPU e TPU per addestrare reti neurali di ogni dimensione.
TensorFlow in sintesi
- Sviluppatore: Google Brain, prima versione pubblica il 9 novembre 2015.
- Licenza: Apache 2.0, codice sorgente aperto su GitHub.
- Linguaggi: API native in Python e C++, con supporto di terze parti per Java, Go e Rust.
- Hardware: esecuzione su CPU, GPU e sulle TPU, i processori proprietari di Google.
- Ecosistema: Keras per costruire i modelli, TensorBoard per monitorarli, LiteRT per il mobile, TFX per la produzione.
- Alternativa principale: PyTorch, il framework concorrente nato in ambito accademico.
Cos’è TensorFlow e come funziona
TensorFlow organizza i dati in tensori, strutture multidimensionali simili a matrici, e li fa scorrere dentro un grafo computazionale, cioè una rete di nodi in cui ogni nodo è un’operazione matematica. Il nome della libreria deriva proprio da questo: i tensori fluiscono (flow) attraverso il grafo.
Il progetto nasce dentro Google Brain e viene reso pubblico il 9 novembre 2015 con licenza Apache 2.0, una licenza libera che permette di usare, modificare e ridistribuire il codice anche in prodotti commerciali. Nella versione descritta su Wikipedia, TensorFlow è già alla base di prodotti Google come la ricerca vocale e Gmail, segno che non è nato come esperimento da laboratorio ma per reggere carichi di produzione.
Le operazioni che il grafo computazionale esegue seguono in pratica la logica degli algoritmi: una sequenza di passaggi definiti che trasforma un input in un output. Il tipo di algoritmo più addestrato con TensorFlow è la rete neurale, un modello organizzato in strati di nodi che, impilati uno sopra l’altro, imparano a riconoscere pattern nei dati.
TensorFlow appartiene al campo più ampio del machine learning, la disciplina che permette a un sistema di migliorare le proprie prestazioni analizzando dati senza istruzioni esplicite scritte a mano. Quando il modello usa reti neurali organizzate in molti strati si entra nel campo del deep learning, su cui ho scritto un articolo a parte perché merita una trattazione autonoma.
Un chiarimento che faccio spesso ai clienti che arrivano da un corso di prompt engineering: il prompt, cioè l’istruzione testuale data a un modello generativo, è un concetto distinto dal grafo computazionale che TensorFlow esegue. Un prompt riguarda l’uso di un modello già addestrato, TensorFlow riguarda la costruzione e l’addestramento di quel modello.
Caratteristiche principali di TensorFlow
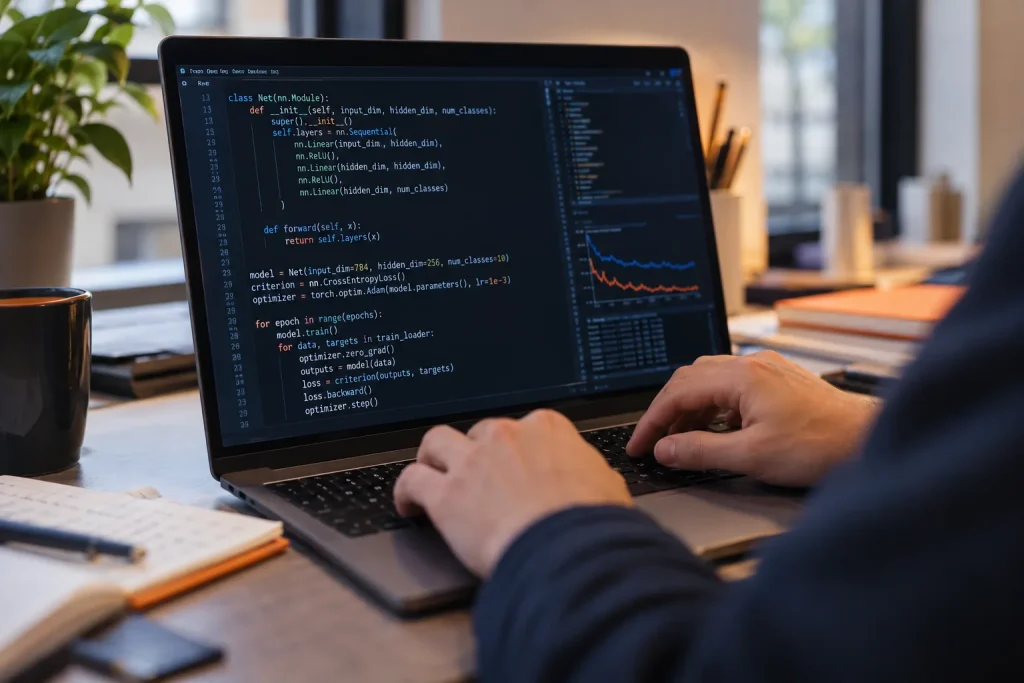
Keras è l’interfaccia che rende TensorFlow accessibile senza passare per il dettaglio matematico di ogni operazione: con poche righe si impilano gli strati di una rete, si sceglie l’ottimizzatore e si avvia l’addestramento. È l’API ufficiale di alto livello della libreria da quando TensorFlow 2 l’ha integrata come default.
Dalla versione 2, TensorFlow esegue le operazioni in modalità eager execution: ogni istruzione viene valutata subito, senza dover prima costruire un grafo statico come nella versione 1. Per chi scrive codice tutti i giorni questo significa un debug molto più semplice, perché si può controllare il valore di un tensore riga per riga invece di aspettare l’esecuzione completa del grafo.
Il calcolo può girare su CPU, su GPU tramite CUDA e cuDNN di NVIDIA, oppure sulle TPU, i processori ASIC che Google ha progettato apposta per il machine learning. Conviene partire dalla CPU per prototipare e passare alla GPU solo quando i tempi di addestramento diventano un collo di bottiglia reale, non per principio.
TensorFlow offre API native in Python e C++; esistono implementazioni di terze parti per Java, Go, Rust, C# e Scala, ma con un livello di manutenzione più discontinuo rispetto alle due principali. Chi lavora in produzione su stack diversi da Python dovrebbe verificare lo stato di quel binding prima di impostarci un progetto importante.
L’ecosistema di TensorFlow
Attorno al nucleo della libreria, Google ha costruito una serie di strumenti pensati per fasi diverse del lavoro con un modello. TensorFlow.js esegue i modelli direttamente nel browser o in Node.js, senza bisogno di un server dedicato all’inferenza. LiteRT, che fino a poco tempo fa si chiamava TensorFlow Lite, porta gli stessi modelli su dispositivi mobile e hardware edge con risorse limitate: secondo i dati più recenti gira su miliardi di dispositivi a , come riportato in una guida comparativa tra framework (PyTorch vs TensorFlow 2026: A Data Science Team’s Guide (2026)).
TensorBoard è lo strumento di visualizzazione integrato: mostra l’andamento della loss, dell’accuratezza e la struttura del grafo computazionale durante l’addestramento. Lo uso spesso con chi non ha un background statistico perché rende visibile, con un grafico, un concetto che altrimenti resterebbe astratto: il modello sta davvero imparando o si è bloccato.
TFX (TensorFlow Extended) gestisce invece la parte che in azienda pesa di più e si vede meno: le pipeline che portano un modello dal notebook di sperimentazione alla produzione, con versioning dei dati e monitoraggio continuo. Chi deve mettere in produzione un modello addestrato altrove può anche partire da un modello già pronto invece che da zero: è il principio del riuso di un modello già addestrato su un altro compito, applicabile ai modelli disponibili su Kaggle Models o nel repository di TensorFlow Hub.
Tra i modelli pronti all’uso compaiono anche architetture basate sul meccanismo di attenzione dei Transformer, oggi lo standard per l’elaborazione del linguaggio naturale dentro lo stesso ecosistema.
TensorFlow e PyTorch: le differenze principali
PyTorch è il framework open source per il deep learning sviluppato da Meta, nato in ambito accademico e oggi preferito da buona parte della ricerca. TensorFlow privilegia la messa in produzione su larga scala; PyTorch punta sull’esecuzione dinamica e sulla leggibilità del codice durante la sperimentazione.
| Aspetto | TensorFlow | PyTorch |
|---|---|---|
| Sviluppatore | Google Brain | Meta (Facebook) |
| Esecuzione predefinita | Eager execution (da TF 2) | Dinamica fin dall’origine |
| Punto di forza | Produzione e deployment su larga scala (TFX, LiteRT) | Flessibilità in fase di ricerca |
| Quota di mercato 2026 | 37,5% su 25.099 aziende | 25,7% su 17.196 aziende |
| Presenza negli annunci ML | 32,9% | 37,7% |
I numeri di quota di mercato arrivano da una sola guida comparativa che ho consultato, quindi li riporto come li dà quella fonte: PyTorch vs TensorFlow 2026: A Data Science Team’s Guide (2026) assegna a TensorFlow il 37,5% della quota globale su 25.099 aziende e a PyTorch il 25,7% su 17.196 aziende, quasi 12 punti percentuali di distacco a favore di TensorFlow sul numero di aziende che lo adottano. La stessa guida, però, misura PyTorch presente nel 37,7% degli annunci di lavoro legati al machine learning contro il 32,9% di TensorFlow: la libreria più usata dalle aziende non è la più richiesta negli annunci.
Sul piano tecnico, in un confronto del 2022 citato nella stessa guida, PyTorch ha completato l’addestramento di una rete convoluzionale circa il 25% più velocemente di TensorFlow in configurazioni specifiche: un dato che riguarda quel test preciso, non una regola generale valida per ogni modello e ogni hardware.
Chi lavora su un progetto affronta anche la parte che precede il modello vero e proprio: trasformare i dati grezzi in variabili utilizzabili dal modello è un passaggio comune a entrambi i framework, e in genere pesa più sul risultato finale della scelta tra TensorFlow e PyTorch.
Python, il linguaggio di riferimento per TensorFlow
Python è il linguaggio consigliato da Google per usare TensorFlow: la libreria espone qui l’API più completa e aggiornata, prima di qualunque altro linguaggio. È gratuito, open source, e la sua installazione non comporta costi di licenza.
Non lo definirei un linguaggio difficile da imparare: la sintassi è leggibile e vicina al linguaggio naturale, il che riduce la curva d’ingresso rispetto a linguaggi più verbosi. Il tempo necessario per arrivare a scrivere un modello funzionante dipende da quanta esperienza di programmazione si ha già: chi parte da zero impiega più tempo di chi arriva da un altro linguaggio, e nessuna delle fonti che ho consultato dà una cifra valida per tutti i casi.
Con Python si installa TensorFlow tramite pip, il gestore pacchetti standard: un comando scarica la versione stabile e le sue dipendenze. Con Python si può fare molto altro oltre al machine learning, dall’automazione di attività ripetitive all’analisi dati, ma per questa pagina il punto resta uno: è il ponte più diretto per arrivare al codice di TensorFlow.
Quando scegliere TensorFlow
Quando un cliente mi chiede quale framework impostare su un nuovo progetto, parto sempre dalla destinazione del modello, non dal gusto personale.
Se devi mettere un modello in produzione su larga scala
Scegli TensorFlow: l’ecosistema TFX gestisce il versioning dei dati e il monitoraggio, LiteRT porta lo stesso modello su mobile ed edge senza riscriverlo da zero.
Se fai ricerca o prototipazione rapida
Valuta anche PyTorch: l’esecuzione dinamica nativa rende più veloce modificare l’architettura di un modello durante gli esperimenti, un vantaggio che pesa più in fase di ricerca che in produzione.
Se non hai ancora un team tecnico interno
Comincia da Keras dentro TensorFlow: l’API di alto livello riduce il codice necessario per un primo modello funzionante, prima di valutare un affiancamento esterno o un corso di formazione specifico.
Casi limite ed errori frequenti
L’errore più frequente riguarda chi trova online codice scritto per TensorFlow 1.x, basato su grafi statici costruiti e poi eseguiti in un secondo momento, e lo prova dentro un ambiente con TensorFlow 2.x, dove l’eager execution è il comportamento predefinito: il codice va adattato, non copiato.
Un secondo caso ricorrente è la versione sbagliata di CUDA o cuDNN installata rispetto alla versione di TensorFlow: ogni release della libreria dichiara nella propria documentazione ufficiale le versioni compatibili, e scostarsi da quella tabella produce errori di installazione difficili da diagnosticare senza controllarla.
Il terzo caso è la scelta dello strumento sbagliato per il dispositivo di destinazione: installare TensorFlow completo su un dispositivo mobile appesantisce l’app senza benefici, quando la stessa inferenza gira con LiteRT in una frazione dello spazio.
Domande frequenti su TensorFlow
Cos’è TensorFlow?
TensorFlow è una libreria open source per l’apprendimento automatico, sviluppata da Google Brain e rilasciata nel 2015 con licenza Apache 2.0. Rappresenta i dati in tensori e li elabora attraverso un grafo computazionale, su CPU, GPU o TPU.
Qual è la differenza principale tra PyTorch e TensorFlow?
La differenza principale sta nella destinazione d’uso prevalente: TensorFlow è più diffuso in produzione su larga scala grazie a TFX e LiteRT, mentre PyTorch è preferito nella ricerca per la sua esecuzione dinamica nativa, senza bisogno di costruire un grafo prima di eseguirlo.
A cosa serve PyTorch?
PyTorch serve a costruire e addestrare modelli di deep learning, soprattutto in ambito di ricerca: la sua esecuzione dinamica permette di modificare l’architettura di una rete durante lo sviluppo senza ricompilare un grafo statico.
Python è gratuito?
Sì, Python è un linguaggio open source e gratuito, senza costi di licenza né per l’uso personale né per quello commerciale. È anche il linguaggio con cui TensorFlow espone la propria API più completa.
Python è difficile da imparare?
No, Python ha una sintassi leggibile e vicina al linguaggio naturale, pensata per ridurre la curva d’ingresso rispetto a linguaggi più verbosi: è uno dei motivi per cui Google lo consiglia per TensorFlow.
Quanto tempo ci vuole per imparare Python?
Il tempo dipende dall’esperienza di programmazione già maturata: chi parte da zero impiega più tempo di chi arriva da un altro linguaggio. Nessuna fonte che ho consultato indica una durata valida per tutti i casi.
Che differenza c’è tra l’intelligenza artificiale e un modello linguistico come ChatGPT?
L’intelligenza artificiale è il campo ampio che include ogni tecnica per far svolgere a una macchina compiti tipici dell’intelligenza umana; il chatbot di OpenAI è un’applicazione specifica di quel campo, costruita su un modello linguistico addestrato su grandi quantità di testo.
Quali sono i tipi di intelligenza artificiale?
La classificazione più diffusa distingue l’AI ristretta, capace di un compito specifico, dall’AI generale e dalla superintelligenza, entrambe ancora teoriche: un approfondimento che ho trattato nella panoramica sull’intelligenza artificiale, perché riguarda il campo intero e non la sola libreria TensorFlow.
