
XGBoost: cos’è e come funziona

XGBoost è una libreria software che applica il gradient boosting a insiemi di alberi decisionali, combinando molte previsioni deboli in un unico modello più accurato attraverso iterazioni successive. È scritta in C++, gira su Windows, Linux e macOS e si usa da Python, R, Java e altri linguaggi per classificazione, regressione e ranking.
Da dove iniziare con XGBoost
- Nome completo: eXtreme Gradient Boosting, libreria open source di machine learning.
- Funzionamento: costruisce alberi decisionali in sequenza, ognuno corregge gli errori del precedente.
- Punti di forza: regolarizzazione L1 e L2, gestione nativa dei valori mancanti, accelerazione su GPU.
- Linguaggi supportati: Python, R, Java, Scala, Julia e C++.
- Uso tipico: classificazione, regressione e ranking su dati tabellari.
- Limite principale: richiede tuning degli iperparametri e offre meno interpretabilità rispetto a un singolo albero.
Cos’è XGBoost
XGBoost nasce come progetto di ricerca di Tianqi Chen all’interno della DMLC, il gruppo di sviluppo distribuito dell’Università di Washington. La prima versione pubblica risale al ; la release stabile più recente documentata è la 3.0.0, uscita il . Il codice è distribuito con licenza Apache 2.0 e il repository ufficiale si trova su GitHub, sotto l’organizzazione dmlc.
La libreria usa il gradient boosting, un metodo che addestra molti alberi decisionali deboli uno dopo l’altro, dove ogni nuovo albero corregge gli errori residui di quelli già costruiti. Rispetto al gradient boosting classico, XGBoost aggiunge penalità sulla complessità dell’albero, parallelizza il calcolo degli split e gestisce da solo i dati mancanti durante l’addestramento.
La popolarità della libreria è legata ai risultati nelle competizioni di data science: nel 2015, tra le soluzioni pubblicate sul blog di Kaggle, 17 solutions avevano usato XGBoost, e nello stesso anno, nel KDDCup, ogni squadra tra le prime dieci lo aveva adottato, secondo il paper originale XGBoost: A Scalable Tree Boosting System (2015). Chi lavora oggi con dati tabellari incontra XGBoost quasi sempre, non per moda ma perché resta uno degli strumenti più usati dentro la più ampia cos’è l’intelligenza artificiale applicata ai dati numerici.
Come funziona XGBoost
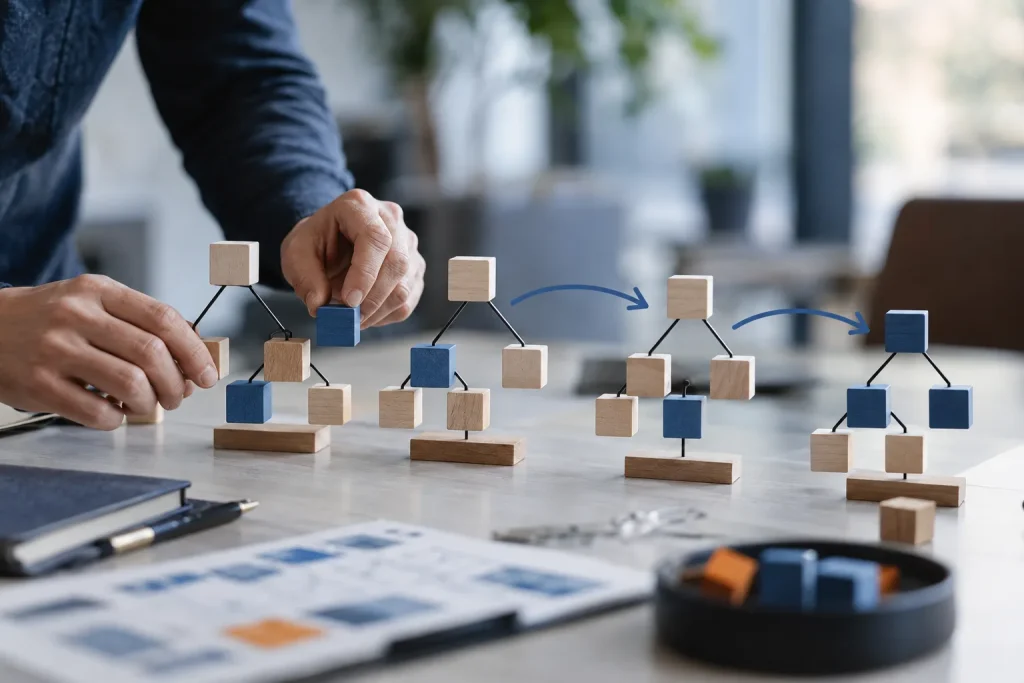
XGBoost costruisce gli alberi uno alla volta, non in parallelo come fa il bagging: il primo albero produce una previsione grezza, il secondo impara a correggere l’errore del primo, il terzo corregge quello che resta, e così via fino al numero di alberi impostato. A ogni iterazione la funzione di perdita viene approssimata con uno sviluppo di Taylor del secondo ordine, che usa sia la derivata prima sia la derivata seconda dell’errore: questo è il dettaglio che distingue XGBoost dal gradient boosting descritto nei testi classici, dove si usa solo la derivata prima.
Per ogni possibile divisione di un nodo, l’algoritmo calcola quanto quella divisione ridurrebbe la perdita complessiva, tenendo conto anche di un termine di penalità sulla struttura dell’albero. Se un valore manca in una colonna, XGBoost non lo sostituisce con una media o una moda: prova entrambe le direzioni dello split e tiene quella che migliora il risultato, imparando così la direzione ottimale per i dati assenti caso per caso.
Quanto l’albero finale generalizza bene dipende anche da cosa gli viene dato in input: uno split ottimo su una colonna poco informativa resta uno split poco utile. Per questo il lavoro di preparazione delle variabili in ingresso viene prima ancora di toccare un iperparametro.
Caratteristiche principali di XGBoost
La regolarizzazione L1 e L2 penalizza gli alberi troppo complessi aggiungendo un termine alla funzione di perdita: più foglie e pesi alti costano in punteggio, quindi il modello resta più semplice del necessario invece di adattarsi al rumore dei dati di addestramento. È la differenza più citata rispetto al gradient boosting tradizionale, che non include questo controllo.
La velocità viene dalla parallelizzazione del calcolo degli split su più core e, dove disponibile, dall’accelerazione su GPU: la costruzione dei singoli alberi resta sequenziale, ma il lavoro dentro ciascun albero è distribuito. Su dataset di grandi dimensioni la differenza tra una CPU e una GPU dedicata si misura in ore di addestramento risparmiate, non in minuti.
XGBoost è versatile perché la stessa libreria gestisce problemi di classificazione, regressione e ranking, oltre a funzioni obiettivo personalizzate scritte dall’utente. È anche portabile: lo stesso codice gira su una singola macchina o su cluster distribuiti con Hadoop, Spark o Dask, ed è disponibile come pacchetto per Python, R, Java, Scala, C++ e Julia. Questa combinazione di controllo sull’overfitting, velocità e portabilità è il motivo per cui resta uno standard di riferimento sui dati tabellari, più che una singola funzione isolata.
XGBoost è un algoritmo o un modello?
XGBoost è, in senso stretto, un’implementazione di un algoritmo di gradient boosting: la libreria offre la procedura di addestramento. Il modello è invece il risultato concreto di quella procedura applicata a un dataset specifico, cioè l’insieme di alberi con i loro pesi e le loro soglie di split, pronto per fare previsioni. La stessa libreria produce modelli diversi a seconda dei dati e degli iperparametri usati, mentre la logica e struttura di un algoritmo di boosting resta la stessa indipendentemente dal problema.
Nella pratica quotidiana i due termini si usano in modo intercambiabile, e non è un errore grave: quando si dice “ho allenato un XGBoost” si intende il modello ottenuto, quando si dice “XGBoost gestisce i dati mancanti” ci si riferisce all’algoritmo.
Qual è il learning rate e gli altri iperparametri di XGBoost
Il learning rate, chiamato eta nella libreria, controlla quanto peso ha ogni nuovo albero sul risultato finale: un valore basso rallenta l’apprendimento e riduce il rischio di overfitting, un valore alto velocizza l’addestramento ma rende il modello più sensibile al rumore. In una guida tecnica che ho consultato il valore predefinito di eta è 0,3; i valori predefiniti possono però cambiare tra una versione e l’altra della libreria, quindi conviene sempre verificarli nella documentazione della versione installata.
| Iperparametro | Cosa controlla | Effetto di un valore alto |
|---|---|---|
| eta (learning rate) | Il peso di ogni nuovo albero sul modello finale | Addestramento più rapido, più rischio di overfitting |
| n_estimators | Il numero di alberi costruiti in sequenza | Modello più complesso, serve un eta più basso per compensare |
| gamma | La riduzione minima di perdita richiesta per uno split | Alberi più piccoli, addestramento più lungo in cerca di split validi |
| max_depth | La profondità massima di ciascun albero | Alberi più profondi, più soggetti a overfitting |
Non esiste una combinazione valida per ogni dataset: dipende dal numero di righe, dal rumore nei dati e dall’obiettivo da ottimizzare. Nel mio lavoro parto sempre da un eta basso con più alberi, poi stringo max_depth e gamma solo dopo aver controllato il risultato con la verifica incrociata sui dati di addestramento, non su un singolo split di test. Spostare gamma di pochi decimali alla cieca, sperando di trovare il valore buono, fa perdere tempo: una ricerca sistematica, anche semplice, lo risparmia.
Esempio pratico di XGBoost in Python
XGBoost si integra con l’interfaccia Estimator di la libreria per il machine learning più diffusa in Python, quindi chi conosce già quell’ecosistema può usare XGBClassifier o XGBRegressor con lo stesso codice a cui è abituato. I passaggi sono sempre gli stessi, a prescindere dal dataset:
- Caricare il dataset e separare le feature dalla variabile da prevedere.
- Dividere i dati in un set di addestramento e uno di test.
- Creare il classificatore o il regressore XGBoost e addestrarlo sui dati di training.
- Generare le previsioni sul set di test e misurarne l’accuratezza.
import xgboost as xgb
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

clf = xgb.XGBClassifier(n_estimators=100, learning_rate=0.1, max_depth=3)
clf.fit(X_train, y_train)

preds = clf.predict(X_test)
print(accuracy_score(y_test, preds))
Il codice sopra resta valido sia per problemi di classificazione sia, cambiando classe e metrica, per la regressione: cambia solo l’oggetto usato e la funzione di valutazione, non la struttura del flusso.
XGBoost, Random Forest, LightGBM, CatBoost e SVM a confronto
Non esiste un algoritmo migliore in assoluto: la scelta dipende dalla dimensione del dataset, dal tempo disponibile per l’addestramento e dal tipo di variabili in gioco.
| Algoritmo | Approccio | Quando preferirlo |
|---|---|---|
| XGBoost | Boosting sequenziale con regolarizzazione | Dati tabellari di media o grande dimensione, serve controllo sull’overfitting |
| Random Forest | Bagging, alberi indipendenti in parallelo | Dataset rumorosi, serve un modello di riferimento rapido e stabile |
| LightGBM | Boosting con campionamento per gradiente (GOSS) | Dataset molto grandi dove il tempo di addestramento è il vincolo principale; in un confronto tecnico che ho letto risulta 2-5 volte più veloce su dataset ampi, secondo XGBoost vs LightGBM 2026: guía completa (2026) |
| CatBoost | Boosting con gestione nativa delle variabili categoriche | Dataset con molte colonne categoriche, meno pre-elaborazione da fare a mano |
| SVM | Separazione tramite iperpiani e kernel | Dataset piccoli e puliti, confini di decisione non lineari ma semplici |
Tra XGBoost e Random Forest la differenza che conta è come riducono l’errore: il bagging di Random Forest abbassa la varianza mediando alberi indipendenti, il boosting di XGBoost abbassa il bias correggendo in sequenza gli errori residui. Tra XGBoost e SVM la differenza è di scala: su poche migliaia di righe pulite una SVM ben calibrata può reggere il confronto, ma su dataset grandi e con molte colonne XGBoost scala meglio e richiede meno preparazione manuale dei dati.
Quando non conviene usare XGBoost
Se il dataset ha poche righe e pochissimo rumore
Un modello più semplice, come una regressione logistica o una SVM, spiega lo stesso risultato con meno parametri da regolare e meno rischio di overfitting su un campione piccolo.
Se i dati sono immagini, audio o testo libero
XGBoost lavora su dati tabellari con feature già definite; su dati non strutturati rende meglio il deep learning applicato a immagini e testo, che impara da solo le feature rilevanti.
Se serve spiegare ogni decisione a chi non lavora con i dati
Un modello fatto di centinaia di alberi non si legge come un albero singolo: per spiegarlo serve una tecnica aggiuntiva, come i valori SHAP, che resta comunque un’interpretazione a posteriori e non una lettura diretta delle regole del modello.
Io sconsiglio di partire da XGBoost per abitudine, anche quando un modello più semplice risponderebbe allo stesso quesito in meno tempo: la complessità si paga in manutenzione, non solo in fase di addestramento.
XGBoost è intelligenza artificiale o machine learning?
XGBoost è una libreria di machine learning supervisionato: impara un modello da dati etichettati, senza le reti neurali multilivello tipiche del deep learning. Rientra quindi nel campo più ampio dell’intelligenza artificiale solo nella misura in cui il machine learning ne è una parte, non perché XGBoost stesso simuli un comportamento intelligente generale. Per capire dove si colloca esattamente rispetto alle altre tecniche vale la pena leggere come funziona il machine learning nel suo complesso, che tratta la relazione tra queste discipline in modo più ampio di quanto serva qui.
Casi d’uso comuni di XGBoost
Nelle attività che lavorano su dati tabellari XGBoost ricorre soprattutto in tre contesti: previsione dell’abbandono dei clienti, rilevamento di transazioni sospette e stima di un punteggio di affidabilità su richieste di credito. In tutti e tre i casi i dati di partenza sono righe e colonne numeriche o categoriche, non immagini o testo libero, ed è proprio questo il terreno dove la libreria rende meglio.
Un altro uso frequente è il ranking: ordinare risultati di ricerca, prodotti o contenuti secondo una probabilità di interesse stimata dal modello. La logica resta quella del boosting sequenziale descritta prima, cambia solo la funzione obiettivo usata in fase di addestramento.
Documentazione, codice sorgente e pacchetti disponibili
La documentazione ufficiale copre l’installazione, i parametri e le guide per ogni linguaggio supportato, compreso il pacchetto per R disponibile su CRAN. Il codice sorgente è pubblico sul repository dell’organizzazione dmlc, dove si seguono anche le note di rilascio di ogni versione. Oltre alla documentazione ufficiale, circolano molti tutorial tecnici su siti specializzati e canali video che spiegano passo per passo la costruzione di un modello: utili per un primo approccio, ma vanno sempre verificati sulla documentazione quando si tratta di valori predefiniti o di comportamento esatto di una funzione.
Per chi preferisce un testo strutturato invece di pagine sparse, un libro che tratta XGBoost insieme a scikit-learn, pubblicato il 5 agosto 2016, conta 115 pagine ed è pensato per chi parte da zero, secondo Gradient Boosted Trees with XGBoost and scikit-learn (2016).
Domande frequenti su XGBoost
Che cos’è XGBoost?
XGBoost è una libreria software che applica il gradient boosting ad alberi decisionali, addestrandoli in sequenza per correggere gli errori residui del modello precedente. È open source, scritta in C++ e disponibile per Python, R, Java e altri linguaggi.
Come funziona XGBoost?
XGBoost costruisce un albero alla volta: ogni nuovo albero impara dagli errori lasciati da quelli precedenti, usando un’approssimazione di secondo ordine della funzione di perdita per decidere dove dividere i nodi e gestire i valori mancanti.
XGBoost è un algoritmo o un modello?
XGBoost applica un algoritmo di gradient boosting; il modello è il risultato specifico ottenuto applicando quell’algoritmo a un dataset con determinati iperparametri.
Qual è il learning rate in XGBoost?
Il learning rate, chiamato eta, controlla quanto peso ha ogni nuovo albero sulla previsione finale; un valore basso rallenta l’apprendimento riducendo l’overfitting, un valore alto lo velocizza ma aumenta il rischio di adattarsi troppo ai dati di addestramento.
Conviene di più XGBoost o LightGBM?
Su dataset molto grandi LightGBM, grazie al campionamento per gradiente, risulta più veloce in addestramento secondo i confronti tecnici disponibili; su dataset di dimensione media, dove il controllo fine sulla regolarizzazione conta di più, XGBoost resta una scelta solida.
Quando è meglio non usare XGBoost?
Conviene evitarlo con dataset molto piccoli e puliti, con dati non strutturati come immagini o testo libero, e quando serve spiegare ogni decisione senza ricorrere a tecniche di interpretazione aggiuntive come i valori SHAP.
XGBoost è intelligenza artificiale o machine learning?
XGBoost è una libreria di machine learning supervisionato, una delle tecniche che rientrano nel campo più ampio dell’intelligenza artificiale, non un sistema che simula un comportamento intelligente generale.
Perché XGBoost è considerato così potente?
Perché combina regolarizzazione contro l’overfitting, gestione automatica dei dati mancanti e calcolo parallelo degli split in un’unica libreria, con risultati che nelle competizioni di data science hanno convinto molti team a usarlo come prima scelta.
